
Through-Silicon Via (TSV) für GPU- und KI-Beschleuniger-Markt Gr??e und Marktanteil
惭补谤办迟ü产别谤蝉颈肠丑迟
| Studienzeitraum | 2020 - 2031 |
|---|---|
| Marktgr??e (2026) | 11.54 Milliarden US-Dollar |
| Marktgr??e (2031) | 32.69 Milliarden US-Dollar |
| Growth Rate (2026 - 2031) | 23.15 % |
| Schnellstwachsender Markt | Nordamerika |
| Gr??ter Markt | Asien-Pazifik |
| Marktkonzentration | Mittel |
Hauptakteure
*Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert Bild ? 黑料不打烊. Wiederverwendung erfordert Namensnennung gem?? CC BY 4.0. |
|
Through-Silicon Via (TSV) für GPU- und KI-Beschleuniger-Marktanalyse von 黑料不打烊
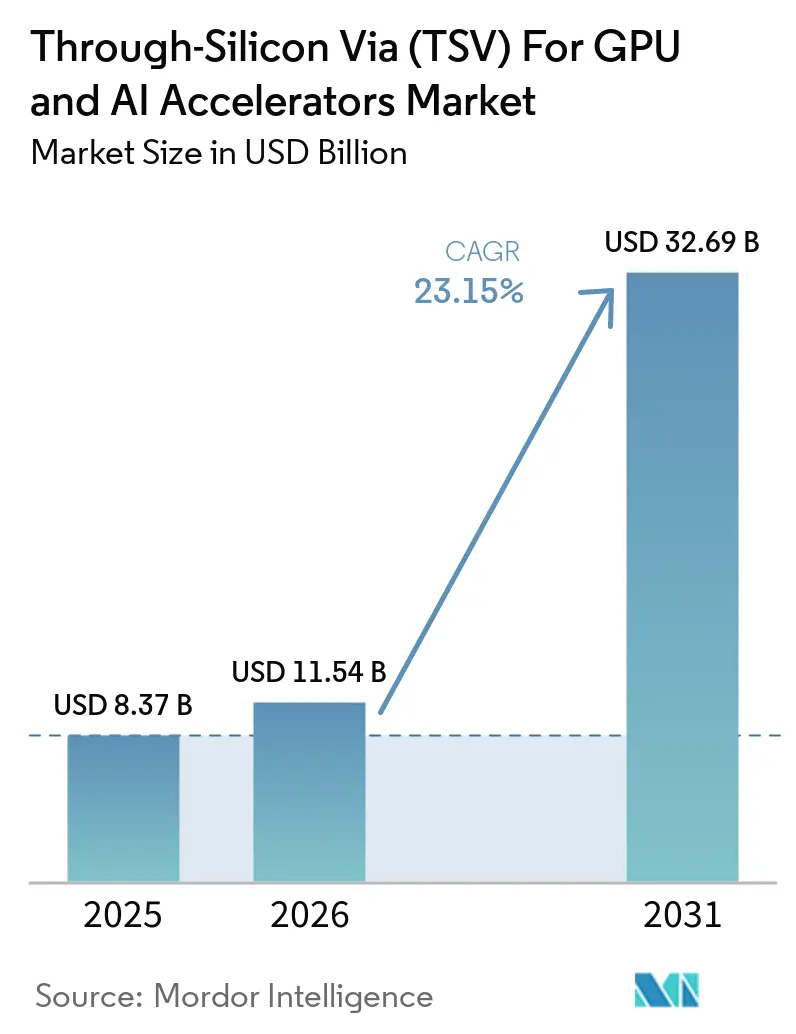
Die Marktgr??e für Through-Silicon Via für GPU- und KI-Beschleuniger wird für 2025 auf 8,37 Milliarden USD, für 2026 auf 11,54 Milliarden USD prognostiziert und soll bis 2031 einen Wert von 32,69 Milliarden USD erreichen, bei einer CAGR von 23,15 % w?hrend des Prognosezeitraums (2026–2031). Die explosionsartige Einführung von Hochbandbreitenspeicher (HBM) in generativen KI-GPUs, der Schwenk zu Chiplet-basierten Grafikarchitekturen sowie milliardenschwere Investitionen in 2,5D- und 3D-Packaging-Linien gestalten die Wertsch?pfung neu. Foundry-eigene Advanced-Packaging-Plattformen wie TSMC CoWoS und Samsung I-Cube bestimmen zunehmend die Markteinführungszeit und verlagern den Wettbewerbsvorteil von der Transistordichte zur vertikalen Verbindungsdichte. Regierungen f?rdern inl?ndische Kapazit?ten durch Subventionsprogramme, die Lieferzeiten für Ausrüstungen verkürzen und den Wettbewerb um Prozessingenieure versch?rfen. Ausrüstungsführer profitieren von Nachfragespitzen bei Wafer-zu-Wafer-Bonding, TSV-?tz- und Freilegungswerkzeugen, auch wenn Ausbeute-Einbu?en, thermische Einschr?nkungen und geopolitische Exportkontrollen das kurzfristige Produktionswachstum d?mpfen. Vor diesem Hintergrund gewinnt der Through-Silicon Via (TSV)-Markt für GPU- und KI-Beschleuniger im gesamten Halbleiter-?kosystem an strategischer Bedeutung.
Wichtigste Erkenntnisse des Berichts
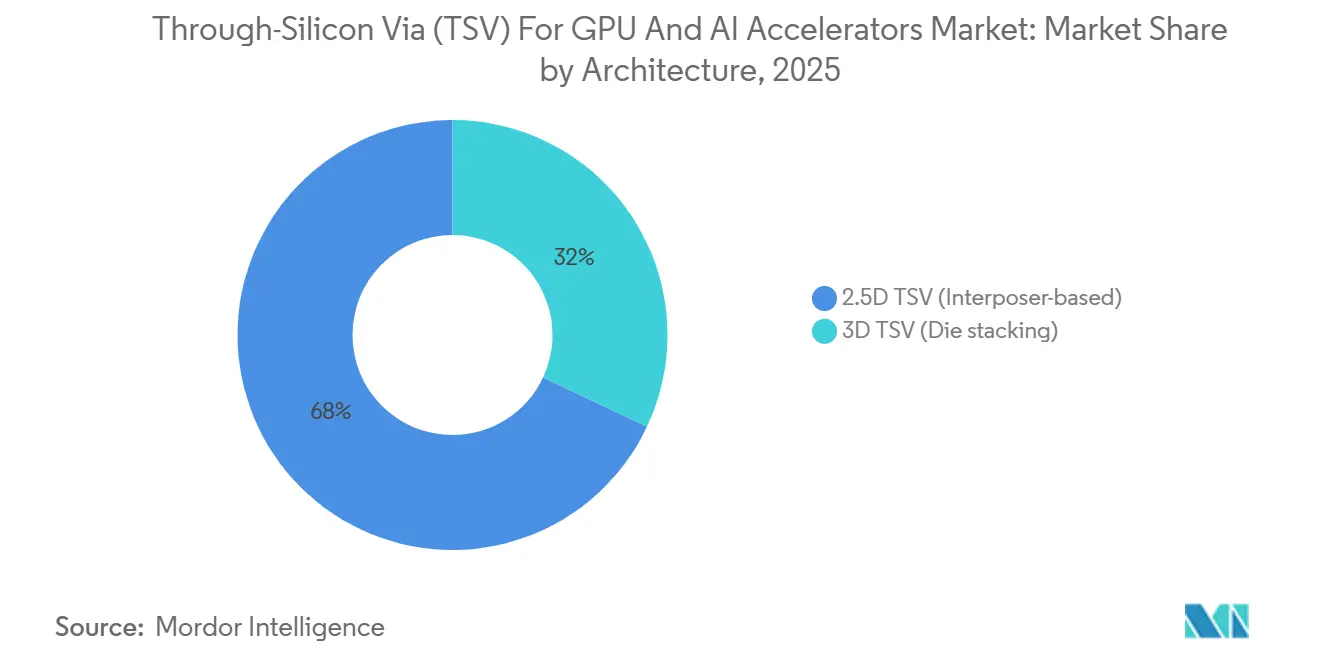
- Nach Architektur erfasste das 2,5D TSV Interposer-basierte Segment im Jahr 2025 einen Marktanteil von 68 % am Markt für Through-Silicon Via für GPU und KI-Beschleuniger, w?hrend das 3D TSV Die-Stacking-Segment bis 2031 voraussichtlich mit einem CAGR von 23,56 % wachsen wird.
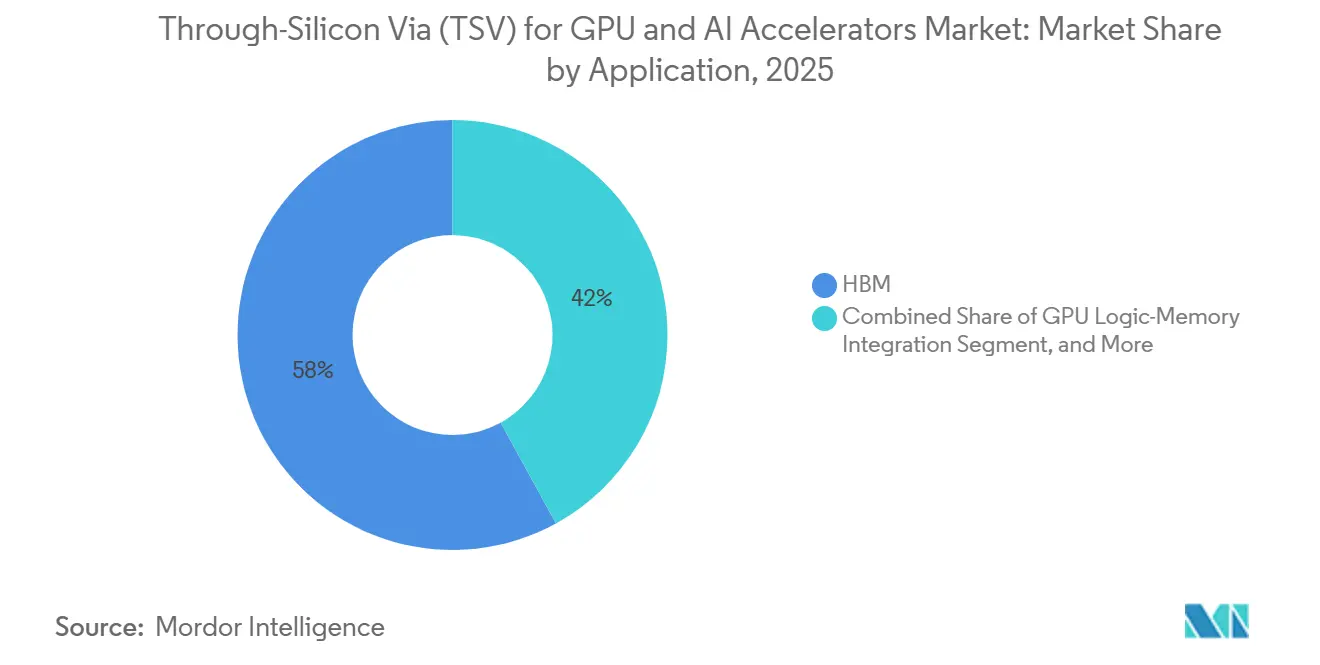
- Nach Anwendung hielten HBM-Speicherstapel im Jahr 2025 einen Anteil von 58 % an der Marktgr??e für Through-Silicon Via für GPU und KI-Beschleuniger, w?hrend Chiplet-basierte GPU-Architekturen im Zeitraum 2026–2031 den schnellsten CAGR von 23,78 % verzeichnen sollen.
- Nach Geografie entfiel im Jahr 2025 ein Anteil von 62 % am Markt für Through-Silicon Via für GPU und KI-Beschleuniger auf den Asien-Pazifik-Raum, und für Nordamerika wird bis 2031 der schnellste CAGR von 24,15 % prognostiziert.
Hinweis: Die Marktgr??e und Prognosezahlen in diesem Bericht werden mithilfe des propriet?ren Sch?tzungsrahmens von 黑料不打烊 erstellt und mit den neuesten verfügbaren Daten und Erkenntnissen vom Januar 2026 aktualisiert.
Globale Through-Silicon Via (TSV) für GPU- und KI-Beschleuniger-Markttrends und Erkenntnisse
Analyse der Treiberwirkung*
| Treiber | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Zeithorizont der Auswirkung |
|---|---|---|---|
| Breite Einführung von HBM3 und darüber hinaus in KI-GPUs | +6.8% | Global, Fertigung im Asien-Pazifik-Raum, Einsatz in Nordamerika | Mittelfristig (2–4 Jahre) |
| Wachstum Chiplet-basierter GPU-Designs, die fortschrittliche Interposer erfordern | +5.2% | Global, Design in Nordamerika, Fertigung im Asien-Pazifik-Raum | Mittelfristig (2–4 Jahre) |
| Steigende Kapitalinvestitionen in 2,5D- und 3D-Packaging-Anlagen | +4.5% | Kernregion Asien-Pazifik, Expansion in Nordamerika | Langfristig (≥ 4 Jahre) |
| Staatliche Anreize für inl?ndische Halbleiter-Lieferketten | +3.1% | Nordamerika, Europa | Langfristig (≥ 4 Jahre) |
| Aufkommende hybride Bonding-TSV-Techniken zur Leistungssteigerung | +2.4% | Taiwan, 厂ü诲办辞谤别补, Vereinigte Staaten | Langfristig (≥ 4 Jahre) |
| Steigende Nachfrage nach energieeffizienten Rechenzentrumsbeschleunigern | +1.9% | Hyperscale-Betreiber in Nordamerika und Europa | Mittelfristig (2–4 Jahre) |
| Quelle: 黑料不打烊 | |||
Breite Einführung von HBM3 und darüber hinaus in KI-GPUs
HBM3E und HBM4 heben die TSV-Dichteziele auf über 100.000 Vias pro Geh?use an, was Packaging-Kostenstrukturen und Prozessfenster neu definiert. SK hynix validierte 12-lagige HBM4-Muster mit einer Bandbreite von über 2 Tbit/s und plant die Massenproduktion für Ende 2025. NVIDIAs Rubin-GPU, die 2026 vorgestellt wurde, integriert 288 GB HBM4 und stützt sich auf 16-lagige Stapel, die dennoch in bestehende Server-Z-H?hengrenzen passen, da Samsung ein 12-lagiges 3D-TSV-Geh?use demonstrierte, das das 720-?m-Profil des ?lteren 8-lagigen HBM2 beibeh?lt. Speicherhersteller lagern nun die Basisdie-Logik an führende Logik-Foundries aus, was die TSV-Ausrichtungstoleranzen und die Anforderungen an Kupfer-zu-Kupfer-Bonding erh?ht. Diese Ver?nderungen skalieren den Markt für Through-Silicon Via für GPU und KI-Beschleuniger rasch, da Lieferanten darum wetteifern, zuverl?ssige Vias mit hohem Aspektverh?ltnis zu liefern.
Wachstum Chiplet-basierter GPU-Designs, die fortschrittliche Interposer erfordern
Die Disaggregation monolithischer GPUs in Chiplets verbessert die Die-Ausbeute und beschleunigt Produktaktualisierungen. AMDs MI300A kombiniert 5-nm-Compute-Tiles, 6-nm-IO-Tiles und HBM3 auf einem einzigen CoWoS-S-Interposer und liefert eine Speicherbandbreite von über 5 TB/s. Intel trieb den hybriden Bond-Pitch mit Foveros Direct unter 10 ?m, was vertikal gestapelte Spannungsregler und Logikschichten erm?glicht. Der Universal Chiplet Interconnect Express-Standard, der gemeinsam von Samsung geleitet wird, ver?ffentlichte 2024 eine offene Die-zu-Die-PHY, wodurch der Interposer-Zugang weniger propriet?r wird. Diese Fortschritte erweitern die Nachfrage nach gro?en Silizium-Interposern und st?rken den Markt für Through-Silicon Via für GPU und KI-Beschleuniger.
Steigende Kapitalinvestitionen in 2,5D- und 3D-Packaging-Anlagen
Foundries und OSATs reservierten zwischen 2024 und 2026 mehr als 20 Milliarden USD für Advanced Packaging. TSMC hat sich zu einem Expansionsplan in den Vereinigten Staaten im Wert von 165 Milliarden USD verpflichtet, der Kapazit?ten für CoWoS-Linien in Arizona vorsieht. Amkor baut eine 7 Milliarden USD teure Anlage in Peoria, um schlüsselfertige 2,5D- und 3D-Dienste anzubieten. Samsung und Tokyo Electron erh?hten ebenfalls die Investitionsausgaben für Hybrid-Bonding und Bonding-Ausrüstung. Der Kapitalzufluss sichert das langfristige Wachstum des Marktes für Through-Silicon Via für GPU und KI-Beschleuniger.
Staatliche Anreize für inl?ndische Halbleiter-Lieferketten
?ffentliche Mittel katalysieren den Aufbau von Packaging-Kapazit?ten au?erhalb Asiens. Der U.S. CHIPS and Science Act stellte 39 Milliarden USD an Zuschüssen bereit, einschlie?lich eines dedizierten Advanced-Packaging-Programms.[1]U.S. Department of Commerce, "CHIPS for America," CHIPS.GOV Intel sicherte sich 8,5 Milliarden USD für den Ausbau der Werke in Ohio und Arizona mit 3D-Packaging-Linien. Der EU Chips Act stellte 43 Milliarden EUR (48,6 Milliarden USD) für ?hnliche Ziele bereit. Solche Anreize f?rdern regionale Zentren und diversifizieren den Standort des Marktes für Through-Silicon Via für GPU und KI-Beschleuniger.
Analyse der Hemmnisauswirkungen*
| Hemmnis | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Zeithorizont der Auswirkung |
|---|---|---|---|
| Ausbeute-Herausforderungen bei der Hochdichte-TSV-Fertigung | -2.8% | Global, akut unterhalb von 5-nm-Logik | Kurzfristig (≤ 2 Jahre) |
| Einschr?nkungen beim W?rmemanagement in gestapelten GPU-Modulen | -1.9% | Global, am st?rksten oberhalb von 500 W | Mittelfristig (2–4 Jahre) |
| Lieferkettenanf?lligkeiten bei Spezial-TSV-Ausrüstung | -1.4% | Global, Risiko bei Lithografie- und Bonding-Werkzeugen | Mittelfristig (2–4 Jahre) |
| Verfügbarkeit alternativer Advanced-Packaging-L?sungen | -0.8% | Global, Fan-out und UCIe-Brücken | Langfristig (≥ 4 Jahre) |
| Quelle: 黑料不打烊 | |||
Ausbeute-Herausforderungen bei der Hochdichte-TSV-Fertigung
TSV-Aspektverh?ltnisse übersteigen nun 10:1 bei Durchmessern unter 5 ?m, was ?tz-, Füll- und Freilegungsschritte belastet. IEEE-Forschungen zeigten, dass TSV-induzierter Stress die Transistorschwellenwerte verschiebt und den Einsatz von Sperrzonenbereichen erzwingt, die die Siliziumfl?che verringern.[2]IEEE, "TSV-Induced Stress Effects," IEEE.ORG Chipmetrics' inline-Hohlraumdetektion identifizierte latente Ausf?lle, die durch Kupferhohlr?ume nach thermischen Zyklen verursacht wurden. Applied Materials ver?ffentlichte ein Plasma-Nass-TSV-Freilegungsmodul, das dielektrische Rückst?nde ohne Kupfersch?den entfernt, um die kurzfristigen Ausbeuten zu verbessern. Bis solche L?sungen ausgereift sind, bleibt die Produktionsleistung für Ger?te im Markt für Through-Silicon Via für GPU und KI-Beschleuniger durch die Defektdichte begrenzt.
Einschr?nkungen beim W?rmemanagement in gestapelten GPU-Modulen
Die Integration von Logik-Dies mit mehr als 500 W mit 12-lagigem HBM erzeugt W?rmeflüsse, die 200 W/cm? übersteigen. Imecs Modellierung identifizierte einen Temperaturunterschied von 15–20 °C zwischen der oberen und unteren DRAM-Schicht, was zu einer Speicherdrosselung führt. Prognosen zeigen, dass die Sockelleistung bis 2027 1.000 W erreichen k?nnte, was bestehende Luft- und Einphasen-Flüssigkühlsysteme erheblich belastet. W?hrend Materialfortschritte wie SK hynix's MR-MUF-Verguss dazu beitragen, Verwerfungen zu reduzieren, adressieren sie keine vertikalen W?rmepfade. Kühlungsbeschr?nkungen schr?nken Verbesserungen der Betriebsfrequenz ein und hemmen den Markt für Through-Silicon Via für GPU und KI-Beschleuniger, bis paketintegrierte Kühlplatten und Zweiphasen-Kühll?sungen praktikabel werden.
*Unsere Prognosen behandeln die Auswirkungen von Treibern und Einschr?nkungen als richtungsweisend und nicht additiv. Die Wirkungsprognosen berücksichtigen Basiswachstum, Mischungseffekte und Wechselwirkungen zwischen Variablen.
Segmentanalyse
Nach Architektur: Interposer dominieren, w?hrend Hybrid-Bonding skaliert
Das 2,5D TSV Interposer-Segment hielt im Jahr 2025 einen Marktanteil von 68 % am Markt für Through-Silicon Via für GPU und KI-Beschleuniger, getrieben durch ausgereifte Designregeln und etablierte Substrat-?kosysteme. TSMCs CoWoS-S unterstützt Interposer mit einer Fl?che von nahezu 2.700 mm?, die mehrere GPU-Chiplets und acht oder mehr HBM-Würfel auf einem Substrat aufnehmen. Samsungs I-CubeE kombiniert Siliziumbrücken mit Fan-out-Umverteilungsschichten, um die Kosten für gro?fl?chige Interposer zu senken. Diese bew?hrten Wege gew?hrleisten eine hohe Tape-out-Geschwindigkeit und vorhersehbare Ausbeute und sichern die Gr??e des Segments im Markt für Through-Silicon Via für GPU und KI-Beschleuniger in den frühen Prognosejahren.
3D Die-Stacking, obwohl nur 32 % des Wertes von 2025, w?chst mit einem CAGR von 23,56 %, da hybrides Kupfer-Bonding einen vertikalen Pitch unter 4 ?m erm?glicht. Intels Foveros Direct und Samsungs X-Cube zielen auf feinpitchige Kupfer-zu-Kupfer-Verbindungen ab, die Via-Parasit?ten reduzieren und Interlogik-Pfade verkürzen. TSMCs SoIC verspricht einen Pitch unter 1 ?m, nützlich für SRAM-auf-Logik-Stapel in zukünftigen GPUs. Mit verbesserter Ausrüstungsausbeute wird erwartet, dass der 3D-Weg inkrementellen Marktanteil im Markt für Through-Silicon Via für GPU und KI-Beschleuniger gewinnt, gebunden an ultrabreitbandige Speicherfabrics.


Nach Anwendung: HBM führt, Chiplet-GPUs beschleunigen
HBM-Stapel machten im Jahr 2025 58 % der Gesamtausgaben aus, getrieben durch die weit verbreitete Einführung von Hochbandbreitenspeicher in erstklassigen KI-Beschleunigern. Jeder dieser Beschleuniger integriert mindestens sechs HBM3E-Würfel, was die entscheidende Rolle der HBM-Technologie bei der Verbesserung der KI-Leistung unterstreicht. Microns HBM3E-Hochlauf mit 8 Gbit/s pro Pin war ma?geblich für die Markteinführung von NVIDIA H200 und AMD MI300X, zwei der bekanntesten KI-Beschleuniger auf dem Markt.[3]Micron, "HBM3E," MICRON.COM Darüber hinaus haben Fortschritte bei der TSV-Dichte (Through-Silicon Via) Samsung in die Lage versetzt, 12-lagige Geh?use zu liefern und dabei die bisherige H?he von 720 ?m beizubehalten. Diese Innovation stellt sicher, dass Systemdesigner weiterhin innerhalb bestehender thermischer Hüllkurven arbeiten k?nnen, ohne dass erhebliche Neugestaltungen erforderlich sind.
Chiplet-basierte GPU-Architekturen, die im Jahr 2025 nur 17 % des Umsatzes ausmachten, sollen bis 2031 mit einem beeindruckenden CAGR von 23,78 % wachsen. AMDs MI300A ist ein Paradebeispiel für kosteneffiziente Skalierung durch Compute-Tiles und zeigt das Potenzial der Chiplet-Technologie zur Optimierung von Leistung und Kosten. Ebenso demonstriert Intels Ponte Vecchio, das mehr als 40 Tiles integriert, den extremen Grad der Disaggregation, der durch Chiplet-basierte Designs erm?glicht wird. Die Verwendung kleinerer Dies verbessert nicht nur die Ausbeute, sondern bietet auch mehr Flexibilit?t bei der Mischung von Prozessknoten. Diese Vorteile treiben eine verst?rkte Kundenakzeptanz voran und erweitern die Marktgr??e für Through-Silicon Via-Technologie in GPU und KI-Beschleunigern erheblich, insbesondere in Anwendungen mit Chiplet-GPUs.

Geografische Analyse
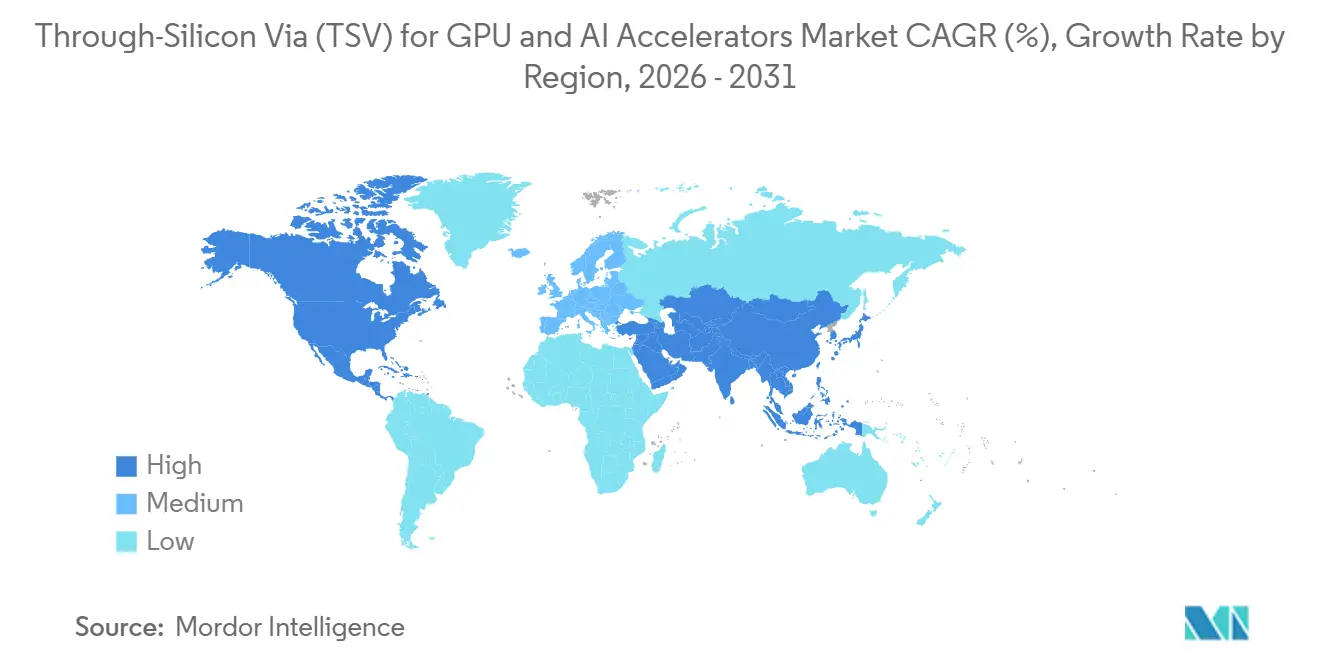
Der Asien-Pazifik-Raum dominierte im Jahr 2025 den Markt für Through-Silicon Via für GPU und KI-Beschleuniger mit einem Umsatzanteil von 62 %, getrieben durch die Cluster-Fertigung, das Advanced Packaging und die HBM-Produktion von TSMC, Samsung und SK Hynix in Taiwan und 厂ü诲办辞谤别补. TSMCs F&E-Zentrum in Kumamoto, Japan, bündelt Substrat- und Materialpartner und verkürzt die Lieferzyklen für CoWoS-Roadmap-Updates. Tokyo Electron steigerte die F&E-Ausgaben 2025 auf 250,0 Milliarden JPY (1,61 Milliarden USD), um die Markteinführung von Bonding-Ausrüstung zu beschleunigen und das regionale ?kosystem zu st?rken. Exportkontroll-Gegenwind schr?nkt Chinas F?higkeit ein, fortschrittliche Lithografie zu beschaffen, was die inl?ndische TSV-Kapazit?t begrenzt und seinen lokalen Anteil am Markt für Through-Silicon Via für GPU und KI-Beschleuniger einschr?nkt.
Der prognostizierte CAGR von 24,15 % für Nordamerika wird durch die Nachfrage der Hyperscaler und staatliche Subventionen angetrieben. TSMCs Multi-Fab-Campus in Arizona reserviert CoWoS-Linien für US-amerikanische GPU-Kunden, w?hrend Amkors Werk in Peoria eine OSAT-Alternative im Inland schafft. Intels durch den CHIPS Act gef?rderte Expansionen in Ohio und Arizona versprechen gebundene und freie 3D-Packaging-Volumina. Die zunehmenden Investitionen in die US-amerikanische Rechenzentrumsinfrastruktur, bei der KI-Beschleuniger zur am schnellsten wachsenden Ausgabenkategorie werden, verst?rken die inl?ndische Nachfrage weiter.
Europa gewinnt dank des EU Chips Act-Pools von 43 Milliarden EUR (rund 46,44 Milliarden USD) einen bescheidenen, aber wachsenden Anteil, der Pilotlinien für Wafer-Level-Bonding und RDL-Interposer finanziert.[4]Europ?ische Kommission, "EU Chips Act," EUROPA.EU STMicroelectronics, GlobalFoundries und IMEC arbeiten an heterogenen Integrationstest-Linien zusammen, aber das Fehlen einer lokalen HBM-Versorgung zwingt europ?ische GPU-Designer weiterhin zu asiatischen Speicherherstellern. 厂ü诲补尘别谤颈办补, der Nahe Osten und Afrika bleiben marginal und beherbergen nur ?ltere Back-End-Operationen ohne TSV-Kapazit?t.

Wettbewerbslandschaft
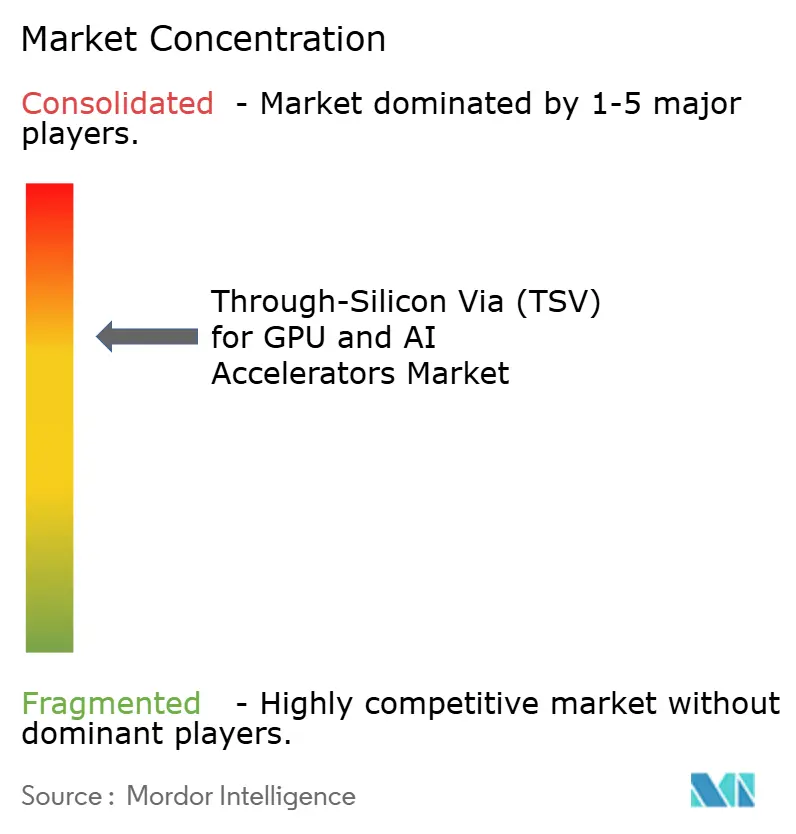
Der Markt für Through-Silicon Via (TSV) für GPU und KI-Beschleuniger ist m??ig konzentriert, wobei einige wenige Schlüsselakteure die Landschaft dominieren. TSMC beherrscht mit seinem CoWoS-Portfolio sch?tzungsweise 60–70 % des 2,5D-Interposer-Umsatzes. Diese Dominanz ist auf die F?higkeit zurückzuführen, eine Einzel-Anbieter-Verantwortung für Logik- und Packaging-Fan-out-auf-Substrat-L?sungen zu bieten, eine Eigenschaft, die von fabless GPU-Designern sehr bevorzugt wird. Samsung hingegen nutzt sein X-Cube Hybrid-Bonding und I-CubeE Fan-out-Interposer, um Kunden anzuziehen, die mit TSMCs Lieferzeiten unzufrieden sind. Samsungs begrenzter Anteil an führender Logik schr?nkt jedoch seine Marktdurchdringung etwas ein. Intel macht ebenfalls Fortschritte in diesem Bereich durch vertikale Integration. Seine Foveros Direct-Linien bedienen sowohl interne Beschleuniger als auch aufkommende Foundry-Kunden, obwohl Bedenken hinsichtlich interner Priorisierung externe Tape-outs verlangsamt haben.
OSATs, darunter ASE Technology, Amkor und JCET, skalieren ihre Aktivit?ten durch Lizenzierung von CoWoS-?quivalenten Abl?ufen oder gemeinsame Entwicklung von Fan-out auf Substraten. Diese Unternehmen spielen eine entscheidende Rolle bei der Erweiterung der Marktkapazit?t und der Deckung der wachsenden Nachfrage nach Advanced-Packaging-L?sungen. Ausrüstungshersteller wie Tokyo Electron und Applied Materials beeinflussen ebenfalls die Marktentwicklung. Tokyo Electrons Synapse Si und Applied Materials' TSV-Freilegungsmodule sind entscheidend für den technologischen Fortschritt, da ein Sub-4-?m-Bonding zur Voraussetzung für HBM4 wird. Diese Entwicklungen unterstreichen die Bedeutung der Zusammenarbeit in der gesamten Lieferkette, um den sich wandelnden Anforderungen des Marktes für GPU und KI-Beschleuniger gerecht zu werden.
Das Universal Chiplet Interconnect Express-Konsortium ist ein weiterer bedeutender Akteur, der die Marktdynamik gestaltet. Durch die Spezifikation offener PHYs zielt das Konsortium darauf ab, die Abh?ngigkeit von Foundries zu reduzieren und einen Multi-Source-Interposer-Markt zu f?rdern. Diese Initiative k?nnte die bestehende Marktstruktur potenziell st?ren und mehr Flexibilit?t und Optionen für Branchenakteure bieten. Befürworter der Fan-out-Technologie argumentieren unterdessen, dass TSMCs InFO mit Through-InFO-Vias Bandbreitenanforderungen zu geringeren Kosten erfüllen kann, was eine Herausforderung für TSV-Marktführer darstellt. Die Wettbewerbslandschaft wird letztendlich davon abh?ngen, ob die Ausbeute-, W?rme- und Bandbreitenvorteile von TSVs die Kosteneffizienz gro?fl?chiger Fan-out-Technologien übertreffen k?nnen.
Through-Silicon Via (TSV) für GPU- und KI-Beschleuniger-Branchenführer
-
TSMC
-
Samsung Electronics
-
SK Hynix
-
Micron Technology
-
ASE Technology Holding
- *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert

Jüngste Branchenentwicklungen
- April 2026: Applied Materials stellte ein Plasma-plus-Nass-TSV-Freilegungsmodul und Oberfl?chenvorbereitungswerkzeuge für Hybrid-Bonding unter 2 nm vor, um die Defektrate bei Vias mit hohem Aspektverh?ltnis zu reduzieren.
- Februar 2026: Tokyo Electron erh?hte die Prognose für das Betriebsergebnis im Gesch?ftsjahr 2026 auf 593 Milliarden JPY (3,8 Milliarden USD) aufgrund stark gestiegener Verk?ufe von Wafer-Bonding- und Debonding-Systemen für HBM-Linien.
- Januar 2026: SK hynix pr?sentierte 16-lagige 48-GB-HBM4-Module mit von TSMC gefertigten Basis-Dies auf dem TSMC Technology Symposium 2026.
- Januar 2026: NVIDIA stellte seine Rubin-Plattform vor, die 288 GB HBM4 pro GPU auf CoWoS-S für die Produktion 2027 integriert.


Globaler Through-Silicon Via (TSV) für GPU- und KI-Beschleuniger-Marktbericht Umfang
Der Markt für Through-Silicon Via (TSV) für GPU und KI-Beschleuniger bezieht sich auf das globale ?kosystem, das an der Entwicklung, Herstellung und dem Einsatz von TSV-basierten Halbleitertechnologien beteiligt ist, die hochdichte vertikale Verbindungen in fortschrittlichen Computerchips erm?glichen. Die TSV-Technologie erm?glicht direkte elektrische Verbindungen durch Siliziumwafer oder -dies und unterstützt die hochbandbreitige, latenzarme Datenübertragung, die für moderne Grafikprozessoren (GPUs) und KI-Beschleuniger entscheidend ist.
Der Bericht über den Markt für Through-Silicon Via für GPU und KI-Beschleuniger ist segmentiert nach Architektur (2,5D TSV Interposer-basiert und 3D TSV Die-Stacking), Anwendung (HBM-Speicherstapel, GPU-Logik-Speicher-Integration, KI-Beschleuniger und HPC-GPUs sowie Chiplet-basierte GPU-Architekturen) und Geografie (Nordamerika, Europa, Asien-Pazifik, 厂ü诲补尘别谤颈办补 sowie Naher Osten und Afrika). Die Marktprognosen werden in Wertangaben (USD) bereitgestellt.
| 2,5D TSV (Interposer-basiert) |
| 3D TSV (Die-Stacking) |
| HBM-Speicherstapel |
| GPU-Logik-Speicher-Integration |
| KI-Beschleuniger / HPC-GPUs |
| Chiplet-basierte GPU-Architekturen |
| Nordamerika | Vereinigte Staaten |
| Kanada | |
| Mexiko | |
| Europa | Vereinigtes K?nigreich |
| Deutschland | |
| Frankreich | |
| ?briges Europa | |
| Asien-Pazifik | China |
| Japan | |
| Indien | |
| 厂ü诲办辞谤别补 | |
| ?briger Asien-Pazifik-Raum | |
| 厂ü诲补尘别谤颈办补 | |
| Naher Osten und Afrika |
| Nach Architektur | 2,5D TSV (Interposer-basiert) | |
| 3D TSV (Die-Stacking) | ||
| Nach Anwendung | HBM-Speicherstapel | |
| GPU-Logik-Speicher-Integration | ||
| KI-Beschleuniger / HPC-GPUs | ||
| Chiplet-basierte GPU-Architekturen | ||
| Nach Geografie | Nordamerika | Vereinigte Staaten |
| Kanada | ||
| Mexiko | ||
| Europa | Vereinigtes K?nigreich | |
| Deutschland | ||
| Frankreich | ||
| ?briges Europa | ||
| Asien-Pazifik | China | |
| Japan | ||
| Indien | ||
| 厂ü诲办辞谤别补 | ||
| ?briger Asien-Pazifik-Raum | ||
| 厂ü诲补尘别谤颈办补 | ||
| Naher Osten und Afrika | ||


Im Bericht beantwortete Schlüsselfragen
Wie gro? ist der aktuelle Markt für Through-Silicon Via für GPU und KI-Beschleuniger und wie schnell w?chst er?
Der Markt belief sich im Jahr 2025 auf 8,37 Milliarden USD, wird voraussichtlich im Jahr 2026 einen Wert von 11,54 Milliarden USD erreichen und soll bis 2031 bei einer CAGR von 23,15 % auf 32,69 Milliarden USD ansteigen.
Warum dominieren 2,5D-Interposer weiterhin gegenüber vollst?ndig gestapelten 3D-Architekturen?
Ausgereifte Designregeln, bew?hrte Zuverl?ssigkeit und Kompatibilit?t mit etablierten Substrat-?kosystemen machen 2,5D-Interposer für Hochvolumen-GPUs wirtschaftlicher, w?hrend 3D Die-Stacking noch mit Ausbeute- und W?rmeproblemen k?mpft.
Wie beeinflussen staatliche Anreize den Aufbau von TSV-Kapazit?ten?
Die Subventionen des U.S. CHIPS Act und des EU Chips Act decken Milliarden an Zuschüssen und Kreditgarantien ab, beschleunigen den Bau von Advanced-Packaging-Linien und diversifizieren die TSV-Produktion über Asien hinaus.
Was sind die wichtigsten technischen Hemmnisse für die TSV-Einführung in KI-Beschleunigern?
Ausbeuten bei der Hochdichte-TSV-Fertigung, W?rmeableitung in gestapelten GPU-HBM-Modulen und das Versorgungsrisiko für Spezial-?tz- und Bonding-Werkzeuge bleiben die führenden Engp?sse.
Welche Unternehmen liefern die kritische Ausrüstung für TSV und Hybrid-Bonding?
Tokyo Electron, Applied Materials und Lam Research dominieren Wafer-zu-Wafer-Bonding, TSV-?tzung und Freilegungsprozesse, die der Hochvolumen-HBM-Produktion zugrunde liegen.
Wie werden Chiplet-Standards wie UCIe die Wettbewerbslandschaft beeinflussen?
Offene Die-zu-Die-Schnittstellenstandards k?nnen die Wechselkosten senken und mehr Foundry- und OSAT-Wettbewerb einladen, was die propriet?ren Vorteile aktueller TSV-Marktführer potenziell untergraben k?nnte.
Seite zuletzt aktualisiert am:



