
HBM für KI-Training Marktgr??e und Marktanteil
惭补谤办迟ü产别谤蝉颈肠丑迟
| Studienzeitraum | 2020 - 2031 |
|---|---|
| Marktgr??e (2026) | 2.89 Milliarden US-Dollar |
| Marktgr??e (2031) | 8.52 Milliarden US-Dollar |
| Growth Rate (2026 - 2031) | 24.14 % |
| Schnellstwachsender Markt | Asien-Pazifik |
| Gr??ter Markt | Nordamerika |
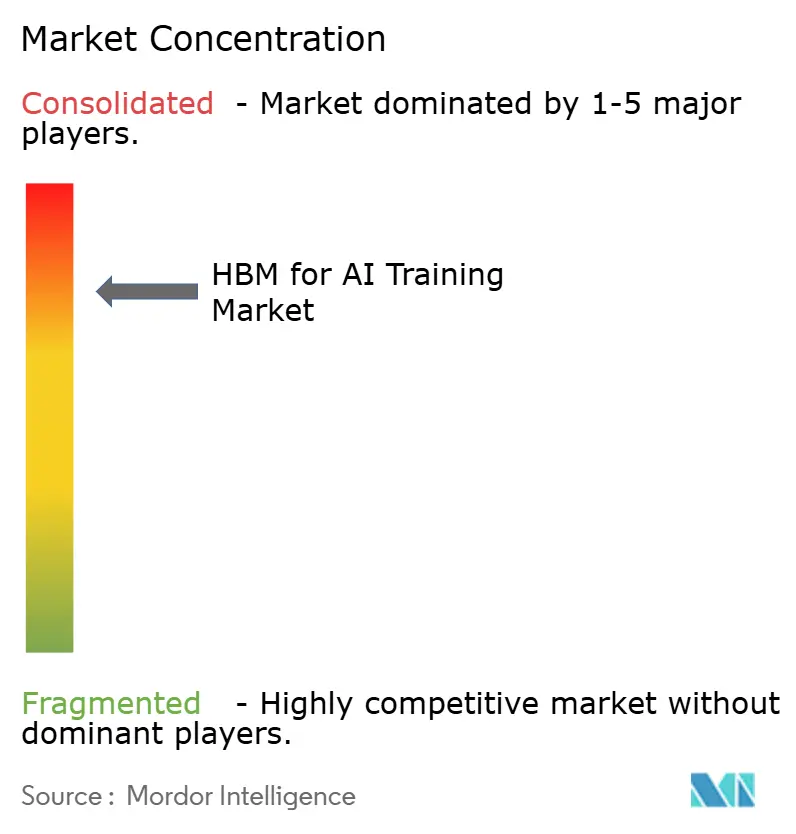
| Marktkonzentration | Hoch |
Hauptakteure
*Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert Bild ? 黑料不打烊. Wiederverwendung erfordert Namensnennung gem?? CC BY 4.0. |
|
HBM für KI-Training Marktanalyse von 黑料不打烊
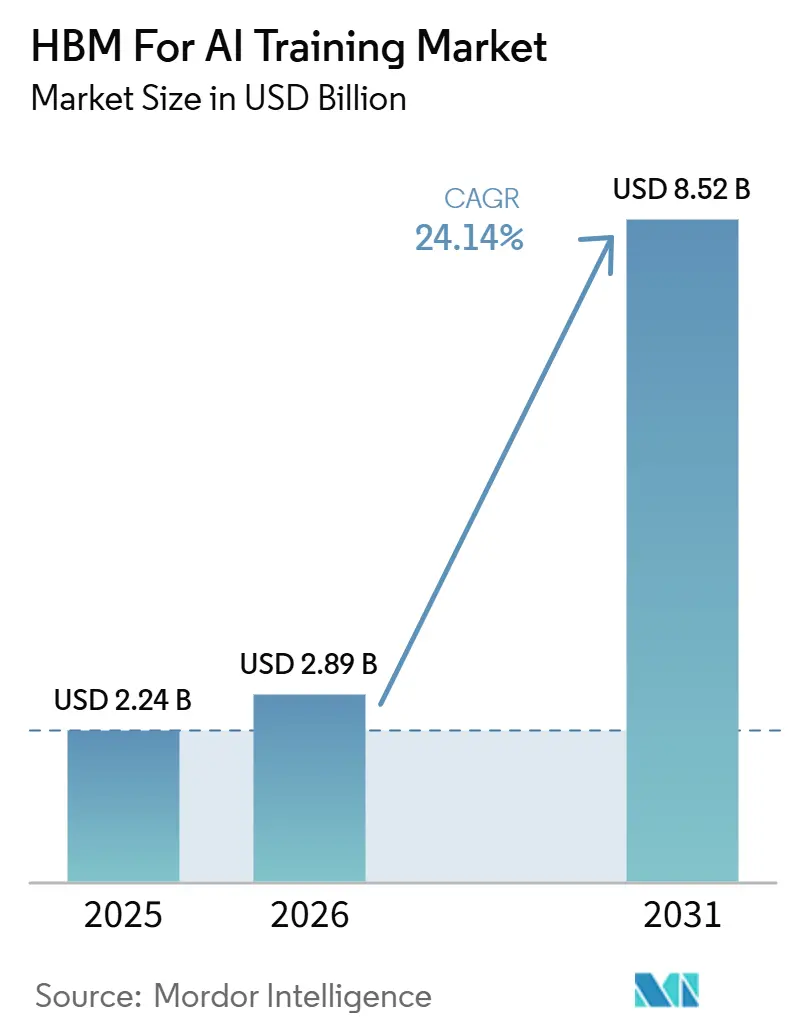
Die Marktgr??e für HBM für KI-Training wird voraussichtlich von 2,24 Milliarden USD im Jahr 2025 auf 2,89 Milliarden USD im Jahr 2026 steigen und bis 2031 einen Wert von 8,52 Milliarden USD erreichen, mit einer CAGR von 24,14 % über den Zeitraum 2026–2031. Der HBM für KI-Training Markt expandiert, weil jeder neue KI-Beschleunigerzyklus mehr Speicher pro Prozessor liefert, was die HBM-Nachfrage erh?ht, selbst wenn die Plattformvolumina in einem gleichm??igen Tempo wachsen. Der HBM4-?bergang verst?rkt dieses Muster im Jahr 2026, da führende GPU- und kundenspezifische Silizium-Programme auf Stacks mit h?herer Kapazit?t und wesentlich h?heren Bandbreitenanforderungen umsteigen. Die Nachfrage bleibt auch in gro?en Trainings-Clustern konzentriert, wo Hyperscaler und Frontier-KI-Labore weiterhin Kapitalprogramme skalieren, w?hrend souver?ne KI-Infrastrukturprogramme eine zweite Ebene mehrj?hriger Beschaffungstransparenz hinzufügen. Eine enge Lieferantenbasis pr?gt ebenfalls den HBM für KI-Training Markt, sodass Qualifizierungszeitpl?ne, Packaging-Zugang und Co-Entwicklungsvereinbarungen die Umsatzrealisierung ebenso stark beeinflussen wie der Fertigungsma?stab. Die kurzfristige Expansion bleibt dem TSV-Ausbeutedruck, Einschr?nkungen beim Advanced Packaging und Anforderungen an das W?rmemanagement ausgesetzt, aber genau diese Einschr?nkungen st?rken den Wert qualifizierter Lieferanten und unterstützen kontinuierliche Investitionen im gesamten HBM für KI-Training Markt.
Wichtigste Erkenntnisse des Berichts
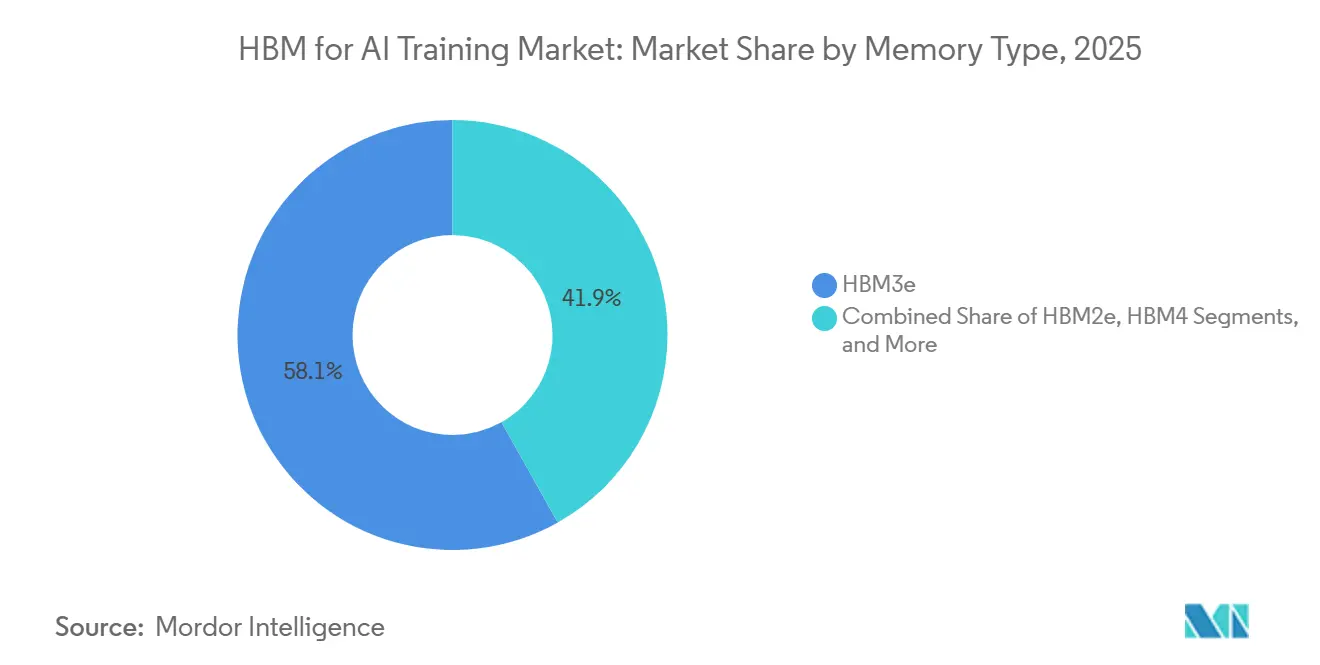
- Nach Speichertyp führte HBM3e mit einem Anteil von 58,14 % am HBM für KI-Training Markt im Jahr 2025, w?hrend HBM4 bis 2031 voraussichtlich mit einer CAGR von 24,96 % wachsen wird.
- Nach Bereitstellungsumgebung entfielen Hyperscale und Cloud auf 87,33 % des HBM für KI-Training Marktes im Jahr 2025, und es wird erwartet, dass dieser Bereich bis 2031 mit einer CAGR von 24,73 % w?chst.
- Nach Verbindungs- und Skalierungsarchitektur entfiel Cluster-Scale Multi-Node auf 61,74 % des HBM für KI-Training Marktes im Jahr 2025, und es wird erwartet, dass dieser Bereich bis 2031 mit einer CAGR von 24,68 % w?chst.
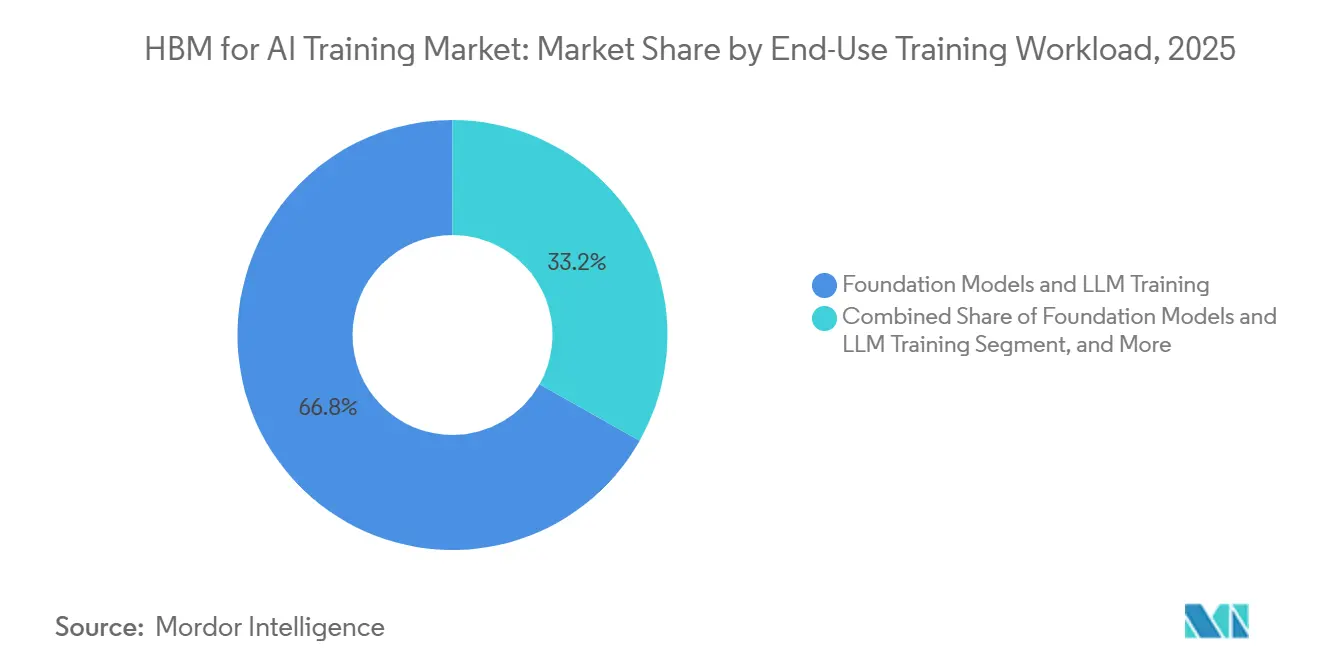
- Nach Endnutzungs-Trainingsworkload repr?sentierten Foundation-Modelle und LLM-Training 66,82 % des HBM für KI-Training Marktes im Jahr 2025, und es wird erwartet, dass dieser Bereich bis 2031 mit einer CAGR von 24,94 % w?chst.
- Nach Prozessortyp hielten GPUs einen Anteil von 91,18 % am HBM für KI-Training Markt im Jahr 2025, w?hrend KI-ASICs bis 2031 voraussichtlich mit einer CAGR von 24,62 % wachsen werden.
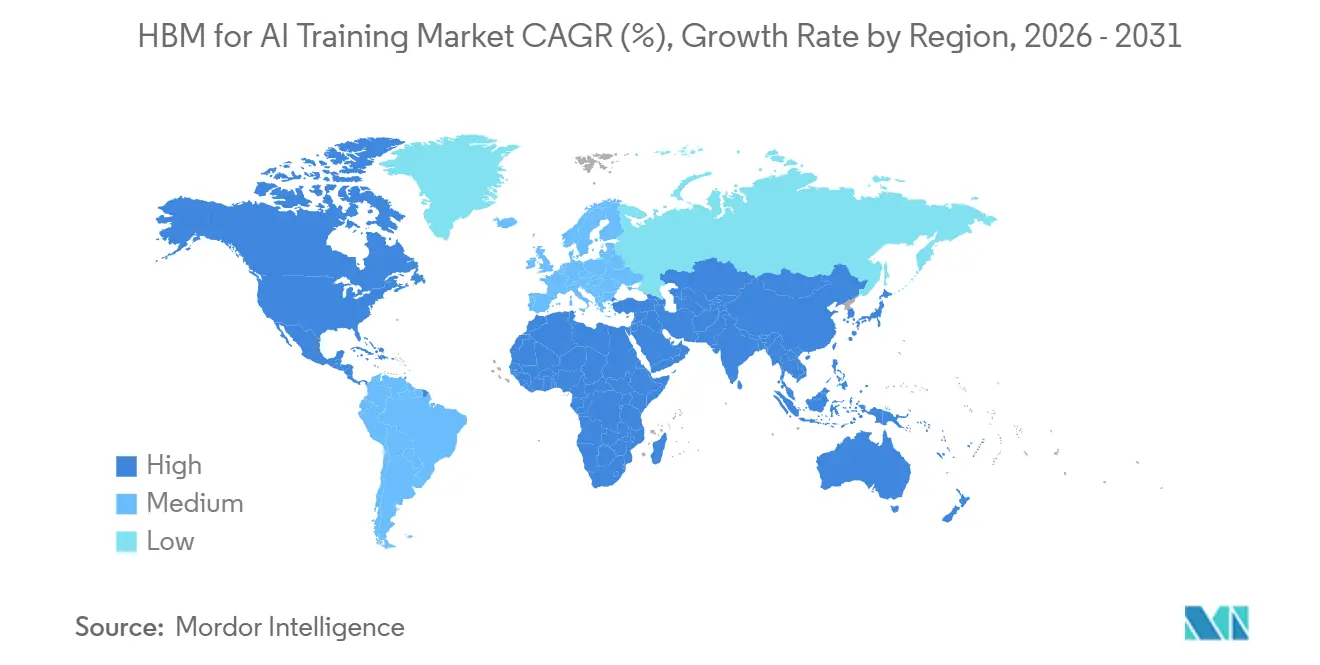
- Nach Geografie hielt Nordamerika im Jahr 2025 einen Anteil von 51,68 % am HBM für KI-Training Markt, w?hrend der asiatisch-pazifische Raum bis 2031 voraussichtlich mit einer CAGR von 25,89 % wachsen wird.
Hinweis: Die Marktgr??e und Prognosezahlen in diesem Bericht werden mithilfe des propriet?ren Sch?tzungsrahmens von 黑料不打烊 erstellt und mit den neuesten verfügbaren Daten und Erkenntnissen vom Januar 2026 aktualisiert.
Markttrends und Einblicke
Analyse der Treiberwirkung*
| Treiber | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Zeithorizont der Auswirkung |
|---|---|---|---|
| Schnelle Skalierung von Frontier-Modell-Trainings-Clustern | +5.8% | Global | Kurzfristig (≤ 2 Jahre) |
| HBM4-Bereitschaft über KI-Beschleuniger-Roadmaps hinweg | +4.9% | Global, APAC-Kern | Kurzfristig (≤ 2 Jahre) |
| Verlagerung hin zu Multi-TB-Trainings-Speicher-Footprints | +3.6% | Nordamerika und APAC | Mittelfristig (2–4 Jahre) |
| Steigender Speicheranteil an den Materialkosten von Trainings-GPUs | +2.9% | Global | Kurzfristig (≤ 2 Jahre) |
| Reservierung von Advanced-Packaging-Kapazit?ten durch Hyperscaler | +2.2% | Nordamerika, APAC-Kern, Ausweitung auf EU | Kurzfristig (≤ 2 Jahre) |
| Souver?ne KI-Ausbauprogramme mit Bedarf an lokalisierter Beschleuniger-Versorgung | +1.8% | Naher Osten, Südasien, EU | Mittelfristig (2–4 Jahre) |
| Quelle: 黑料不打烊 | |||
Schnelle Skalierung von Frontier-Modell-Trainings-Clustern
Der HBM für KI-Training Markt wird durch den Umfang von Frontier-Trainingssystemen angetrieben, die nun Speicherbandbreite auf Rack- und Cluster-Ebene erfordern, nicht nur auf Einzelchip-Ebene. NVIDIAs GB200 NVL72 integriert 72 Blackwell-GPUs in eine einzige NVLink-Dom?ne und unterstützt bis zu 13,4 Terabyte HBM3e über das gesamte Rack, was zeigt, wie eine einzelne Bereitstellungseinheit nun einen sehr gro?en Speicher-Footprint absorbiert. Dieselbe Architektur liefert auch 1,8 Terabyte pro Sekunde Verbindungsbandbreite pro GPU und h?lt gro?e HBM-Pools w?hrend anhaltender Trainingsworkloads aktiv, anstatt nur bei intermittierenden Spitzen. AWS Project Rainier ging Ende 2025 mit einem Cluster von rund 500.000 Trainium2-Chips für Anthropic in Betrieb, und dieser Ma?stab zeigt, wie ein einzelnes Kundenprogramm über einen einzigen Trainingszyklus eine sehr hohe HBM-Nachfrage erzeugen kann.[1]Amazon, "AWS Project Rainier, The World's Most Powerful Computer for Training AI," Amazon, aboutamazon.com Da immer mehr Frontier-Modell-Programme von Pilotphasen in die Produktion übergehen, profitiert der HBM für KI-Training Markt sowohl von h?heren Stückzahlen als auch von h?herem Speicherinhalt pro System. Diese Kombination macht den HBM für KI-Training Markt weniger abh?ngig vom einfachen GPU-Lieferungswachstum und st?rker abh?ngig von Cluster-Designentscheidungen.
HBM4-Bereitschaft über KI-Beschleuniger-Roadmaps hinweg
Die HBM4-Bereitschaft wird zu einem direkten Wachstumshebel für den HBM für KI-Training Markt, da die n?chste Plattformwelle auf gr??ere Stacks, h?here Bandbreite und engere Speicherintegration ausgerichtet ist. NVIDIAs Vera-Rubin-Architektur befindet sich 2026 in der Vollproduktion, mit 288 Gigabyte HBM4 über 8 Stacks und 13 Terabyte pro Sekunde Bandbreite, was einen Sprung in der Speicherkapazit?t auf führenden KI-Plattformen best?tigt. AMDs Instinct MI400 zielt ebenfalls auf 432 Gigabyte HBM4 und bis zu 19,6 Terabyte pro Sekunde ab, was die HBM4-Nachfrage über ein einzelnes Anbieter-?kosystem hinaus ausweitet. Samsung begann im Februar 2026 mit der Massenproduktion von kommerziellem HBM4, was darauf hindeutet, dass die Lieferanten-Hochl?ufe mit den Einführungspl?nen der Beschleuniger übereinstimmen, anstatt ihnen mit erheblichem Abstand zu folgen. Googles 8. Generation TPU 8i verfügt über 288 Gigabyte HBM und verdoppelt die Verbindungsbandbreite gegenüber der Vorg?ngergeneration, was best?tigt, dass der HBM4-?bergang nun auch kundenspezifische Silizium-Programme bei Hyperscale-K?ufern erreicht. Da sich die Qualifizierung über GPU-, TPU- und ASIC-Roadmaps ausbreitet, gewinnt der HBM für KI-Training Markt eine breitere Nachfragebasis und st?rkere Plattformkontinuit?t über den Prognosezeitraum hinweg.
Verlagerung hin zu Multi-TB-Trainings-Speicher-Footprints
Der HBM für KI-Training Markt wird auch durch eine klare Bewegung hin zu Multi-Terabyte-Speicherpools für Trainingssysteme und Petabyte-skaliertem gemeinsamem Speicher auf Supercomputer-Ebene angetrieben. Googles ver?ffentlichte TPU-Analyse zeigte, dass der direkt adressierbare gemeinsame HBM von TPU v2 bis Ironwood um das 400-Fache expandierte, von 4 Terabyte auf 1,77 Petabyte. AWS Trainium3 liefert 144 Gigabyte HBM3e pro Chip mit 4,9 Terabyte pro Sekunde Bandbreite, und ein Trainium3 UltraServer skaliert auf 20,7 Terabyte aggregiertem HBM3e. Diese Speicherpools unterstützen l?ngere Kontextfenster, gr??ere Batch-Gr??en und komplexere multimodale Trainingsl?ufe, die durch langsamere Speicherebenen nicht effizient bedient werden k?nnen. Die Verlagerung bedeutet auch, dass jede neue Systemgeneration mehr HBM verbraucht, noch bevor Cluster-Anzahlen berücksichtigt werden, was einen strukturell gr??eren HBM für KI-Training Markt unterstützt. Sie erh?ht auch die Kosten jeder Versorgungsunterbrechung, da ein Engpass nun gr??ere Speicher-Footprints pro Bereitstellungseinheit betrifft.
Steigender Speicheranteil an den Materialkosten von Trainings-GPUs
Der HBM für KI-Training Markt wird durch die wachsende wirtschaftliche Bedeutung von Speicher in fortschrittlichen Beschleunigersystemen gestützt. Jede neue Flaggschiff-Plattform bietet mehr HBM-Kapazit?t und Bandbreite, was bedeutet, dass Speicher Beschaffungsentscheidungen nun direkter beeinflusst als in früheren KI-Hardware-Zyklen. NVIDIAs Vera-Rubin-Plattform und AMDs MI400 verfügen beide über HBM-Konfigurationen, die wesentlich gr??er sind als die der Vorg?ngergenerationen, was diese Verschiebung in den Systemdesign-Priorit?ten widerspiegelt. SK hynix und NVIDIA kündigten im Juni 2026 eine mehrj?hrige Technologiepartnerschaft an, und dieser Schritt zeigt, dass die Speicherplanung nun weit vor der Festlegung vollst?ndiger Produktionspl?ne mit Beschleuniger-Roadmaps verknüpft wird. Da Speicher zur entscheidenden Einschr?nkung bei Leistung, Verfügbarkeit und Systemkosten wird, behandeln K?ufer die HBM-Beschaffung als strategische Entscheidung und nicht als Komponentenkauf. Diese Ver?nderung verbessert die Planungssicherheit des HBM für KI-Training Marktes, da Liefervereinbarungen früher im Plattformzyklus gesichert werden.
Analyse der Hemmnisse*
| Hemmnis | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Zeithorizont der Auswirkung |
|---|---|---|---|
| TSV-Ausbeuteverluste und Komplexit?t des Advanced Packaging | -2.4% | Global | Kurzfristig (≤ 2 Jahre) |
| Kapazit?tsengp?sse bei Foundries und OSATs | -2.0% | APAC-Kern, Ausweitung auf Nordamerika | Kurzfristig (≤ 2 Jahre) |
| Einschr?nkungen durch thermische Dichte und Leistungsaufnahme | -1.6% | Global | Mittelfristig (2–4 Jahre) |
| Lieferantenkonzentration und Qualifizierungsvorlaufzeiten | -1.2% | Global | Mittelfristig (2–4 Jahre) |
| Quelle: 黑料不打烊 | |||
TSV-Ausbeuteverluste und Komplexit?t des Advanced Packaging
TSV-Ausbeuteverluste bleiben ein wesentliches Hemmnis für den HBM im KI-Training Markt, da die Stack-Komplexit?t mit jeder Generation zunimmt. HBM4 stellt h?here Anforderungen an das Bonden und engere Schnittstellen, was beim ?bergang von HBM3e zu HBM4 einen Neustart des Prozesslernens erfordert. Imec pr?sentierte auf der IEEE IEDM im Dezember 2025 W?rme- und Integrationsanalysen, die zeigten, dass die 3D-HBM-auf-GPU-Integration die Betriebstemperatur unter KI-Trainingsworkloads auf 140,7 °C erh?hte, was verdeutlicht, wie Packaging, W?rmedesign und Ausbeute nun gemeinsam betrachtet werden müssen. Da die Stack-H?hen zunehmen, kann ein Defekt in einer beliebigen Schicht den nutzbaren Stack beeintr?chtigen, sodass das Ausgabewachstum nicht linear mit dem Wafer-Input steigt. Das macht die Angebotsausweitung langsamer als die Nachfrageausweitung, was Lieferungen im gesamten HBM für KI-Training Markt verz?gern kann. Es erh?ht auch den Wert von Lieferanten, die bereits hochgestapelte Produkte in gro?em Ma?stab qualifiziert haben.
Kapazit?tsengp?sse bei Foundries und OSATs
Engp?sse bei Foundries und OSATs begrenzen den HBM für KI-Training Markt, da Advanced-Packaging-Kapazit?ten parallel zur Speicherversorgung und zu Beschleuniger-Wafer-Starts ausgebaut werden müssen. Selbst wenn HBM-Dies verfügbar sind, k?nnen KI-Systeme nicht in gro?em Umfang ausgeliefert werden, ohne ausreichend CoWoS- und verwandte Integrationskapazit?ten, um Speicher und Rechenleistung im erforderlichen Ma?stab zu verbinden. Dies h?lt den Packaging-Zugang im Mittelpunkt der kommerziellen Umsetzung für Speicherlieferanten, GPU-Designer und Hyperscale-K?ufer. Der Engpass verlagert den Wettbewerb auch weg von der reinen Speicherproduktion hin zur ?kosystemkontrolle, da Unternehmen mit besserem Packaging-Zugang Angebot schneller in Umsatz umwandeln k?nnen. In der Praxis ist das Hemmnis am deutlichsten in APAC-Produktionsknoten sichtbar, aber seine Auswirkungen erstrecken sich auf nordamerikanische Systembereitstellungspl?ne, da viele führende Cluster von derselben Packaging-Kette abh?ngen. Bis die Packaging-Kapazit?ten deutlich ausgebaut werden, wird der HBM für KI-Training Markt weiterhin Phasen erleben, in denen Nachfrage sichtbar, aber nicht vollst?ndig in ausgelieferte Systeme umwandelbar ist.
*Unsere Prognosen behandeln die Auswirkungen von Treibern und Einschr?nkungen als richtungsweisend und nicht additiv. Die Wirkungsprognosen berücksichtigen Basiswachstum, Mischungseffekte und Wechselwirkungen zwischen Variablen.
Segmentanalyse
Nach Speichertyp:
HBM4-?bergang setzt die Lieferanten-Qualifizierungsreihenfolge neuHBM4 ist der am schnellsten wachsende Speichertyp im HBM für KI-Training Markt, wobei die HBM4-Marktgr??e bis 2031 voraussichtlich mit einer CAGR von 24,96 % wachsen wird. HBM3e führte 2025 mit einem Anteil von 58,14 % am HBM für KI-Training Markt, da es die etablierte Generation in hochvolumigen KI-Bereitstellungen blieb und weiterhin die aktivsten Trainings-Rollouts bediente. Der HBM für KI-Training Markt behielt auch kleinere Positionen für HBM2e und HBM3, haupts?chlich in kostengünstigeren Unternehmens- und Forschungskonfigurationen, wo Systemersatzzyklen langsamer verlaufen. SK hynix begann Anfang 2026 mit der Volumenproduktion von HBM4 und lieferte 12-Hi-48-Gigabyte-Stacks mit einer Bandbreite von über 2 Terabyte pro Sekunde unter Verwendung von MR-MUF-Packaging und einem von TSMC gefertigten Logic-Base-Die.[2]SK hynix Newsroom, "2026 Market Outlook, SK hynix's HBM to Fuel AI Memory Boom," SK hynix, news.skhynix.com Samsung begann ebenfalls im Februar 2026 mit kommerziellen HBM4-Lieferungen mit einer ?bertragungsgeschwindigkeit von 11,7 Gigabit pro Sekunde pro Pin und erfüllte damit die Qualifizierungsanforderungen führender KI-Plattformk?ufer.
Eine strukturellere Ver?nderung im HBM für KI-Training Markt ist der ?bergang zu kundenspezifischen Base-Die-Architekturen innerhalb des HBM4-Stacks. Das bedeutet, dass Speicherlieferanten nicht mehr nur standardisierte Stacks verkaufen, da GPU- und KI-Chip-Designer nun propriet?re Logik innerhalb des Packages selbst integrieren m?chten. Dieses Designmuster schafft eine zweigliedrige Umsatzstruktur, bei der Standardkonfigurationen st?rker auf Verfügbarkeit konkurrieren und kundenspezifische Konfigurationen Wert aus langfristiger Co-Entwicklung sch?pfen. Samsung erkl?rte 2026, dass mehr als die H?lfte seiner HBM-Produktion auf HBM4 umgestellt werden würde, was zeigt, wie schnell die Lieferantenkapazit?t auf die neue Generation umgelenkt wird. Infolgedessen durchl?uft der HBM für KI-Training Markt einen Wendepunkt, an dem die Qualifizierungsreihenfolge, nicht nur der Fertigungsma?stab, die Lieferantenpositionierung im n?chsten Plattformzyklus bestimmen wird.


Nach Bereitstellungsumgebung:
Hyperscale-Dominanz verdeckt das Entstehen des UnternehmensmarktesHyperscale und Cloud entfielen 2025 auf 87,33 % des HBM im KI-Training Markt, was die anhaltende Konzentration der Nachfrage in sehr gro?en Trainingsumgebungen unterstreicht. Der HBM für KI-Training Markt entwickelte sich auf diese Weise, weil Cluster mit mehreren tausend GPUs oder kundenspezifischen ASIC-Clustern Kapitalverpflichtungen, Stromzugang und operative Tiefe erfordern, die nur Hyperscaler und eine kleine Gruppe von KI-Laboren unterstützen k?nnen. Project Rainier veranschaulicht diese Konzentration, da eine einzige cloud-gebundene Bereitstellung auf rund 500.000 Trainium2-Chips für Anthropics Trainings- und Inferenz-Workloads skalierte. Die Dominanz von Hyperscale-K?ufern bedeutet auch, dass der Beschaffungszeitplan weniger Unternehmen die kurzfristige Nachfragesichtbarkeit im gesamten HBM für KI-Training Markt beeinflussen kann. Gleichzeitig gibt die Konzentration den Lieferanten klarere Kundensignale, da Hyperscale-Roadmaps an wichtige Plattformüberg?nge und l?ngere Reservierungszyklen gebunden sind.
Die Unternehmensbereitstellung blieb 2025 deutlich kleiner, aber ihre Rolle weitet sich aus, da HBM-dichte Systeme über Infrastrukturanbieter und verwaltete Bereitstellungsmodelle zug?nglicher werden. Regulierte Sektoren wie Finanzdienstleistungen, Pharmazeutika und Verteidigung bauen schrittweise On-Premise-Trainingskapazit?ten auf, da sie nicht alle sensiblen Modellentwicklungen in gemeinsam genutzten Cloud-Umgebungen durchführen k?nnen. Regierungs- und Forschungseinrichtungen bilden einen separaten Nachfragepfad, da die Beschaffung st?rker an souver?ne KI-Programme und ?ffentliche Rechenkapazit?tsinitiativen als an kommerzielle Cloud-Zyklen gebunden ist. Das macht die Unternehmens- und Regierungsnachfrage episodischer, aber jeder Kauf ist in der Regel gro?, da K?ufer oft vollst?ndige Cluster statt inkrementeller Kapazit?ten erwerben. Da HBM4-basierte Systeme im sp?teren Prognosezeitraum standardisierter werden, sollte der HBM für KI-Training Markt einen breiteren Bereitstellungsmix gewinnen, auch wenn Hyperscale der Anker bleibt.
Nach Verbindungs- und Skalierungsarchitektur:
Cluster-Scale Multi-Node definiert die Frontier-TrainingsarchitekturCluster-Scale Multi-Node hielt 2025 einen Anteil von 61,74 % am HBM für KI-Training Markt, was die dominante Architektur für sehr gro?es Modelltraining widerspiegelt. Der HBM für KI-Training Markt hat sich zu dieser Konfiguration verlagert, da Trainingsworkloads mit Billionen von Parametern und andere Frontier-Workloads nicht innerhalb des Speicher- und Bandbreitenrahmens eines einzelnen Knotens bleiben k?nnen. NVIDIAs sechste Generation NVLink liefert 1,8 Terabyte pro Sekunde pro GPU innerhalb der NVL72-Rack-Scale-Dom?ne, und der Vera Rubin NVL72 ist für 260 Terabyte pro Sekunde aggregierter GPU-Bandbreite ausgelegt. Diese Architektur h?lt gr??ere Speicherpools mit geringerer Kommunikationsreibung aktiv, was die HBM-Auslastung in Rack-Scale-Systemen effektiver macht als in lose verbundenen, kleineren Clustern. Sie erh?ht auch die Speicherintensit?t pro Bereitstellung, da mehr HBM an Systeme gebunden ist, die für synchronisiertes Training über gro?e Dom?nen hinweg ausgelegt sind.
Einzel-GPU- und Multi-GPU-Intra-Node-Systeme blieben für Inferenz, Feinabstimmung und kleinere, spezialisierte Trainingsl?ufe relevant, machten aber 2025 einen geringeren Anteil der HBM-Nachfrage aus. Ihre Rolle im HBM für KI-Training Markt ist begrenzt, da der Trainingsma?stab schneller gewachsen ist, als die Einzelknoten-Speichererweiterung allein bew?ltigen kann. Ver?ffentlichte TPU- und GPU-System-Roadmaps zeigen auch, dass Systemdesigner Verbindungs- und Speicherkoh?renz gemeinsam priorisieren, nicht als separate Upgrade-Pfade. Da Modellgr??en und multimodale Workloads weiter zunehmen, sollten Cluster-Scale-Bereitstellungen der strukturelle Kern des HBM für KI-Training Marktes bleiben. Das h?lt das Verbindungsdesign eng mit der HBM-Nachfrage verknüpft, da die wertvollsten Trainingssysteme diejenigen sind, die sehr gro?e Speicherpools im erforderlichen Ma?stab adressierbar halten k?nnen.
Nach Endnutzungs-Trainingsworkload:
Foundation-Modell-?konomie treibt Speicherintensit?tFoundation-Modelle und LLM-Training repr?sentierten 2025 66,82 % des HBM für KI-Training Marktes, was sie mit gro?em Abstand zur gr??ten Workload-Kategorie machte. Der HBM für KI-Training Markt spiegelt diese Konzentration wider, da Transformer-basiertes Training auf Frontier-Ebene einen anhaltenden Hochbandbreiten-Speicherzugriff über sehr gro?e Parameters?tze und lange Kontextfenster hinweg erfordert. Amazons Project Rainier zeigte, wie eine einzelne Foundation-Modell-Bereitstellung in einen der weltweit gr??ten KI-Rechencluster umgewandelt werden kann, was den durch eine einzelne Modell-Roadmap erzeugten HBM-Bedarf unterstreicht. Googles TPU 8i erweiterte ebenfalls HBM-Kapazit?t und Verbindungsbandbreite, da Vor- und Nachtraining für Frontier-Modelle zunehmend davon abh?ngt, gro?e Speicherpools direkt adressierbar zu halten. Das macht Foundation-Modell-Training zum prim?ren Volumentreiber im HBM für KI-Training Markt, insbesondere wenn K?ufer die Trainingszeit optimieren und nicht nur die Chip-Anzahl.
Computer Vision, Sprache und NLP sowie Empfehlungs- und Graph-Modell-Training machten das verbleibende Drittel der Nachfrage aus und bildeten weiterhin einen bedeutenden Teil des HBM für KI-Training Marktes. Empfehlungs- und Graph-Workloads weisen unterschiedliche Speicherzugriffsmuster auf, aber ihre HBM-Anforderungen steigen, da Graphgr??en, Merkmalstiefe und Personalisierungsschleifen komplexer werden. Sprach- und breiteres NLP-Training gewinnen ebenfalls an Gewicht, da multimodale Modelle Audio-, Text- und Bildverarbeitung in einem einzigen Trainings-Stack kombinieren. Diese Kategorien erreichen noch nicht den Foundation-Modell-Ma?stab, aber sie verbreitern die Nachfragebasis, da sie mehr Anwendungsf?lle in hochbandbreitige Trainingsinfrastruktur einbringen. Im Laufe der Zeit st?rkt diese Mischung den HBM für KI-Training Markt, indem die Abh?ngigkeit von einem einzigen Anwendungspfad reduziert wird, auch wenn Foundation-Modelle dominant bleiben.
Nach Prozessortyp:
Kundenspezifische ASICs gewinnen Boden bei Hyperscale-TrainingsbereitstellungenGPUs hielten 2025 einen Marktanteil von 91,18 % am HBM-Markt für KI-Training, was die St?rke des CUDA-?kosystems und das geringere Ausführungsrisiko GPU-basierter Cluster widerspiegelt. Der HBM für KI-Training Markt bleibt auf GPUs ausgerichtet, da die meisten K?ufer ausgereifte Software-Tools, breite Entwicklerunterstützung und bew?hrte Bereitstellungsmodelle für gro? angelegtes Training bevorzugen. Gleichzeitig sind KI-ASICs das am schnellsten wachsende Prozessorsegment, wobei die HBM für KI-Training Marktgr??e für KI-ASICs bis 2031 voraussichtlich mit einer CAGR von 24,62 % wachsen wird. AWS Trainium3 zeigt warum, da er 144 Gigabyte HBM3e pro Chip mit 4,9 Terabyte pro Sekunde Speicherbandbreite liefert, w?hrend Trn3 UltraServer-Systeme auf 20,7 Terabyte aggregiertem HBM3e skalieren. SK hynix' Marktausblick für 2026 stellte auch fest, dass die HBM-Nachfrage von kundenspezifischen ASIC-basierten KI-Chips voraussichtlich um 82 % im Jahr 2026 wachsen und ein Drittel der gesamten HBM-Nachfrage ausmachen würde, was das st?rkere Wachstumsprofil von ASIC-Bereitstellungen unterstützt.
FPGA-Beschleuniger blieben eine Nische im HBM für KI-Training Markt, haupts?chlich für Forschungsumgebungen und frühe Architekturtests, bevor Entscheidungen für h?hervolumige GPU- oder ASIC-L?sungen getroffen werden. Die wichtigere Ver?nderung ist, dass Hyperscaler zunehmend bereit sind, kundenspezifisches Silizium zu entwickeln, wenn Workload-Form, Modellarchitektur und Flotten?konomie vorhersehbar sind. Das kann die HBM-Intensit?t pro Chip erh?hen, da kundenspezifische Prozessoren um spezifische Trainings- und Inferenz-Kompromisse herum konzipiert werden, anstatt für breite Workload-Kompatibilit?t. Es bedeutet auch, dass der Prozessormix im HBM für KI-Training Markt sich langsam ausweitet, auch wenn GPUs heute die wichtigste Umsatzbasis bleiben. Im Prognosezeitraum sollte das ASIC-Wachstum die Nachfrage weniger abh?ngig von einer Prozessorarchitektur und st?rker an den Speicherbedarf diversifizierter KI-Rechenflotten gebunden machen.
Geografische Analyse
Nordamerika HBM für KI-Training-Markt
Nordamerika hielt im Jahr 2025 einen Marktanteil von 51,68 % am KI-Training-Markt und behauptete damit seine Position als gr??tes regionales Nachfragezentrum. Der HBM für KI-Training-Markt blieb in Nordamerika verankert, da in den USA ans?ssige Hyperscaler und führende KI-Labore die gr??ten installierten Pools an speicherdichter Trainingshardware betrieben. Die regionale Nachfragebasis profitierte zudem von einer Konzentration an Modellentwicklern wie Anthropic, OpenAI und Meta AI, die die fortschrittlichsten Trainingsprogramme in der N?he der nordamerikanischen Cloud- und Colocation-Infrastruktur hielten. Die Entwicklung einer dedizierten HBM-Anlage von Micron Technology, Inc. in Idaho verknüpfte die Speicherversorgungsplanung zudem enger mit der US-Industriepolitik und den Zielen zur inl?ndischen Resilienz. Diese Kombination aus Nachfragekonzentration und Neuausrichtung der Lieferkette hielt Nordamerika im Jahr 2025 im Mittelpunkt des HBM für KI-Training-Marktes.
Europa HBM für KI-Training-Markt
Europa blieb im Jahr 2025 eine sekund?re Region, doch seine Rolle im HBM für KI-Training-Markt wurde durch souver?ne Rechenkapazit?tsinitiativen und die Expansion ?ffentlicher Cloud-Dienste gestützt. Frankreich kündigte im Februar 2025 KI-Investitionen in H?he von 109 Milliarden EUR (119 Milliarden USD) an und signalisierte damit einen mehrj?hrigen Pfad für die Beschaffung von Hardware und den Aufbau von Clustern. Deutschlands nationale KI-Rechenkapazit?tsbemühungen verliehen dem Vorhaben ebenfalls Schwung, indem ?ffentliche Investitionen auf Trainingsinfrastruktur gelenkt wurden, die auf Hochbandbreitenspeicher angewiesen ist. Diese Programme erreichen noch nicht den nordamerikanischen Ma?stab, sind jedoch bedeutsam, da sie die K?uferbasis über kommerzielle Hyperscaler hinaus erweitern. Im HBM für KI-Training-Markt liegt Europas Bedeutung weniger in der unmittelbaren Volumenführerschaft als vielmehr in der Schaffung einer nachhaltigen ?ffentlichen Nachfrage nach gro?en Trainingssystemen.
APAC, 厂ü诲补尘别谤颈办补 und MEA HBM für KI-Training-Markt
Asien-Pazifik ist das am schnellsten wachsende regionale Segment des HBM für KI-Training-Marktes mit einer prognostizierten CAGR von 25,89 % bis 2031. Die Region vereint die weltweit h?chste Konzentration an HBM-Fertigungskapazit?ten mit kritischer fortschrittlicher Verpackungsinfrastruktur, was ihr eine Doppelrolle als Versorgungsbasis und Nachfragezentrum verleiht. 厂ü诲办辞谤别补 bleibt zentral, da SK hynix Inc. und Samsung Electronics Co., Ltd. ihre HBM- und Verpackungsinvestitionen im Einklang mit der KI-Trainingsnachfrage ausbauen. Taiwan bleibt unverzichtbar, da die fortschrittliche Verpackung für KI-Beschleuniger dort konzentriert ist, was die regionale Fertigung direkt mit den globalen Bereitstellungspl?nen verknüpft.[3]Samsung Global Newsroom, "Samsung Ships Industry-First Commercial HBM4 With Ultimate Performance for AI Computing," Samsung, news.samsung.com Japan und Indien bauen ebenfalls nationale KI-Rechenkapazit?tsprogramme aus, w?hrend 厂ü诲补尘别谤颈办补 sowie der Nahe Osten und Afrika noch frühere Nachfragezentren darstellen, wobei die Golfstaaten das st?rkste kurzfristige Clusteraufbaupotenzial aufweisen. Der HBM für KI-Training-Markt ist daher nicht nur für das Wachstum, sondern auch für die Umsetzung entlang der gesamten Lieferkette auf Asien-Pazifik angewiesen.

Wettbewerbslandschaft
Der HBM für KI-Training Markt operiert mit einer stark konzentrierten Angebotsstruktur, angeführt von SK hynix, Samsung Electronics und Micron Technology. Dieses Triopol besteht fort, da die HBM-Entwicklung erhebliche Kapitalinvestitionen, tiefes Prozess-Know-how und langwierige Qualifizierungszyklen erfordert, die für neue Marktteilnehmer schwer zu replizieren sind. Im HBM für KI-Training Markt wird die Lieferantenposition nicht nur durch den Wafer-Output, sondern auch durch die erfolgreiche Qualifizierung auf neuen KI-Beschleuniger-Plattformen bestimmt. Das macht die Kundenausrichtung und die Zeit bis zur Qualifizierung ebenso wichtig wie den absoluten Fertigungsma?stab. Es bedeutet auch, dass sich Marktanteile w?hrend wichtiger Plattformüberg?nge schnell verschieben k?nnen, selbst wenn die Lieferantenliste stabil bleibt.
SK hynix st?rkte seine Position im HBM für KI-Training Markt durch eine mehrj?hrige Technologiepartnerschaft mit NVIDIA, die im Juni 2026 angekündigt wurde. Die Vereinbarung zeigte, dass Speicher-Roadmaps nun in engerer Abstimmung mit dem Beschleuniger-Plattformdesign geplant werden, was die Eintrittsbarrieren für Lieferanten erh?ht, die nicht frühzeitig eingebunden sind. Samsung verfolgte einen anderen Weg, indem es HBM-Speicher, Logikf?higkeit und Packaging-Ambitionen zu einem integrierteren Angebot kombinierte und im Februar 2026 mit kommerziellen HBM4-Lieferungen begann. Samsung begann 2026 auch frühzeitig mit HBM4E-Sampling, was seine Absicht signalisierte, beim Tempo der kommerziellen Umsetzung zu konkurrieren und nicht nur beim Ma?stab. Diese Schritte zeigen, dass der HBM für KI-Training Markt auch innerhalb einer kleinen Lieferantengruppe wettbewerbsintensiv ist, da jedes Unternehmen versucht, den n?chsten Designzyklus zu gestalten, bevor die Nachfrage ihren H?hepunkt erreicht.
Auf der Nachfrageseite gestalten Hyperscaler und KI-Chip-Designer den HBM für KI-Training Markt ebenfalls um, indem sie kundenspezifisches Silizium und gr??ere interne Infrastrukturflotten aufbauen. Googles TPU 8i und AWS Trainium3 zeigen, dass speicherreiche kundenspezifische Beschleuniger zu einem dauerhaften Teil des Trainingshardware-Mix werden, anstatt ein Nebenpfad zu GPUs zu sein.[4]Google Cloud, "AI Infrastructure at Next '26," Google Cloud Blog, cloud.google.com Das erweitert die qualifizierte Kundenbasis für HBM-Lieferanten und erh?ht gleichzeitig den Druck, unterschiedliche Stack-Designs, Bandbreitenziele und Packaging-Anforderungen zu unterstützen. Das Ergebnis ist ein Markt, in dem die Konzentration hoch bleibt, der Wettbewerb innerhalb des qualifizierten Lieferantenkreises jedoch zunimmt, da immer mehr K?ufer ma?geschneiderte Speicherl?sungen fordern.
HBM für KI-Training Branchenführer
-
SK hynix Inc.
-
Samsung Electronics Co., Ltd.
-
Micron Technology, Inc.
-
NVIDIA Corporation
-
Advanced Micro Devices, Inc.
- *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert
HBM für KI-Training-Markt
- SK hynix Inc.
- Samsung Electronics Co., Ltd.
- Micron Technology, Inc.
- NVIDIA Corporation
- Advanced Micro Devices, Inc.
- Intel Corporation
- ASML Holding N.V.
- Applied Materials, Inc.
- Lam Research Corporation
- KLA Corporation
- Tokyo Electron Limited
- Amkor Technology, Inc.
- ASE Technology Holding Co., Ltd.
- Taiwan Semiconductor Manufacturing Company Limited
- Powertech Technology Inc.
- Coherent Corp.

Recent Industry Developments in HBM für KI-Training-Markt
- Juni 2026: SK hynix und NVIDIA kündigten eine mehrj?hrige Technologiepartnerschaft an, die die Co-Entwicklung von Speicher der n?chsten Generation umfasst, der auf NVIDIAs KI-Fabrik-Infrastruktur-Roadmap abgestimmt ist, sowie Liefervereinbarungen für fortschrittlichen Speicher über zukünftige Beschleuniger-Plattformen hinweg.
- Juni 2026: SK hynix begann mit der Auslieferung von 12-Schicht-HBM4E-Mustern an wichtige Kunden und bot 48 Gigabyte Kapazit?t bei 16 Gigabit pro Sekunde pro Pin mit mehr als 20 % besserer Energieeffizienz als HBM4 an, womit der Qualifizierungszyklus für KI-Beschleuniger eingeleitet wurde, die ab 2027 erwartet werden.
- Februar 2026: Samsung Electronics begann mit der Massenproduktion von HBM4 und lieferte die ersten kommerziellen Produkte an Kunden einschlie?lich NVIDIA aus, womit das Unternehmen der erste Lieferant wurde, der kommerzielles HBM4 auf den Markt brachte. Die Pyeongtaek-P5-Anlage des Unternehmens ging im selben Quartal in Betrieb, dediziert für HBM-Stacking und Packaging, mit einem vollst?ndigen Hochlauf, der für die zweite Jahresh?lfte 2026 angestrebt wird.
- April 2026: SK hynix gab eine zus?tzliche Investition von 21,6 Billionen KRW (13,9 Milliarden USD) in den Yongin-Halbleitercluster Phase 2 bis 6 Reinraumbau bekannt, der dem Ausbau der HBM-Produktionskapazit?t und der Advanced-Packaging-F?higkeit im Einklang mit dem KI-Trainingsnachfragewachstum über den Prognosezeitraum hinweg gewidmet ist.


Globaler HBM für KI-Training Marktbericht – Umfang
Der HBM für KI-Training Markt umfasst die Entwicklung, Produktion und Einführung von Hochbandbreiten-Speicherl?sungen, die zur Beschleunigung von KI-Trainingsworkloads in Rechenzentren, Hochleistungsrechenumgebungen und KI-Infrastruktur eingesetzt werden. Der Marktumfang umfasst HBM-Technologien, die in GPUs, KI-Beschleuniger und andere fortschrittliche Prozessoren integriert sind, die gro? angelegtes Modelltraining durch hohe Speicherbandbreite, verbesserte Energieeffizienz und schnellere Datenverarbeitungsf?higkeiten unterstützen.
Der HBM für KI-Training Marktbericht ist segmentiert nach Speichertyp (HBM2e, HBM3, HBM3e und HBM4), Bereitstellungsumgebung (Hyperscale und Cloud, Unternehmen sowie Regierung und Forschung), Verbindungs- und Skalierungsarchitektur (Einzel-GPU, Multi-GPU Intra-Node und Cluster-Scale Multi-Node), Endnutzungs-Trainingsworkload (Foundation-Modelle und LLM-Training, Computer-Vision-Training, Sprach- und NLP-Modelltraining sowie Empfehlungs- und Graph-Modell-Training), Prozessortyp (GPUs, KI-ASICs und FPGA-Beschleuniger) sowie Geografie (Nordamerika, Europa, asiatisch-pazifischer Raum, 厂ü诲补尘别谤颈办补 sowie Naher Osten und Afrika). Die Marktprognosen werden in Wertangaben (USD) bereitgestellt.
| HBM2e |
| HBM3 |
| HBM3e |
| HBM4 |
| Hyperscale und Cloud |
| Unternehmen |
| Regierung und Forschung |
| Einzel-GPU |
| Multi-GPU Intra-Node |
| Cluster-Scale Multi-Node |
| Foundation-Modelle und LLM-Training |
| Computer-Vision-Training |
| Sprach- und NLP-Modelltraining |
| Empfehlungs- und Graph-Modell-Training |
| GPUs |
| KI-ASICs |
| FPGA-Beschleuniger |
| Nordamerika | Vereinigte Staaten |
| Kanada | |
| Mexiko | |
| Europa | Deutschland |
| Vereinigtes K?nigreich | |
| Frankreich | |
| Italien | |
| ?briges Europa | |
| Asiatisch-pazifischer Raum | China |
| Japan | |
| 厂ü诲办辞谤别补 | |
| Taiwan | |
| Indien | |
| ?briger asiatisch-pazifischer Raum | |
| 厂ü诲补尘别谤颈办补 | |
| Naher Osten und Afrika |
| Nach Speichertyp | HBM2e | |
| HBM3 | ||
| HBM3e | ||
| HBM4 | ||
| Nach Bereitstellungsumgebung | Hyperscale und Cloud | |
| Unternehmen | ||
| Regierung und Forschung | ||
| Nach Verbindungs- und Skalierungsarchitektur | Einzel-GPU | |
| Multi-GPU Intra-Node | ||
| Cluster-Scale Multi-Node | ||
| Nach Endnutzungs-Trainingsworkload | Foundation-Modelle und LLM-Training | |
| Computer-Vision-Training | ||
| Sprach- und NLP-Modelltraining | ||
| Empfehlungs- und Graph-Modell-Training | ||
| Nach Prozessortyp | GPUs | |
| KI-ASICs | ||
| FPGA-Beschleuniger | ||
| Nach Geografie | Nordamerika | Vereinigte Staaten |
| Kanada | ||
| Mexiko | ||
| Europa | Deutschland | |
| Vereinigtes K?nigreich | ||
| Frankreich | ||
| Italien | ||
| ?briges Europa | ||
| Asiatisch-pazifischer Raum | China | |
| Japan | ||
| 厂ü诲办辞谤别补 | ||
| Taiwan | ||
| Indien | ||
| ?briger asiatisch-pazifischer Raum | ||
| 厂ü诲补尘别谤颈办补 | ||
| Naher Osten und Afrika | ||


Im Bericht beantwortete Schlüsselfragen
Wie gro? ist der HBM für KI-Training Markt im Jahr 2026?
Die Marktgr??e für HBM für KI-Training betr?gt 2,89 Milliarden USD im Jahr 2026 und wird voraussichtlich bis 2031 einen Wert von 8,52 Milliarden USD bei einer CAGR von 24,14 % über den Zeitraum 2026–2031 erreichen.
Warum steigt die Nachfrage nach HBM im KI-Training so schnell?
Die Nachfrage steigt, weil jede neue Beschleunigergeneration mehr HBM-Kapazit?t und h?here Bandbreite mitbringt, w?hrend Frontier-Trainings-Cluster ebenfalls weiter im Ma?stab wachsen.
Welche Region führt die HBM-Nachfrage für KI-Trainingssysteme an?
Nordamerika führte 2025 mit einem Anteil von 51,68 %, da gro?e Hyperscaler und Frontier-KI-Labore in den Vereinigten Staaten konzentriert sind.
Welche Region w?chst am schnellsten bei HBM im KI-Training?
Der asiatisch-pazifische Raum ist die am schnellsten wachsende Region mit einer prognostizierten CAGR von 25,89 % bis 2031, unterstützt durch die Konzentration der HBM-Fertigung und expandierende KI-Rechenkapazit?tsprogramme.
Welche Prozessorkategorie w?chst am schnellsten in der KI-Trainingshardware?
GPUs dominierten 2025 noch mit einem Anteil von 91,18 %, aber KI-ASICs werden voraussichtlich am schnellsten mit einer CAGR von 24,62 % bis 2031 wachsen.
Was ist die gr??te Bereitstellungsumgebung für HBM-basierte KI-Trainingssysteme?
Hyperscale und Cloud blieben 2025 mit einem Anteil von 87,33 % die gr??te Bereitstellungsumgebung, da gro?e Trainings-Cluster sehr hohe Kapital-, Strom- und Betriebsanforderungen erfordern.
Seite zuletzt aktualisiert am:



