
HBM3E-Marktgr??e und Marktanteil
惭补谤办迟ü产别谤蝉颈肠丑迟
| Studienzeitraum | 2020 - 2031 |
|---|---|
| Marktgr??e (2026) | 2.01 Milliarden US-Dollar |
| Marktgr??e (2031) | 5.35 Milliarden US-Dollar |
| Growth Rate (2026 - 2031) | 21.73 % |
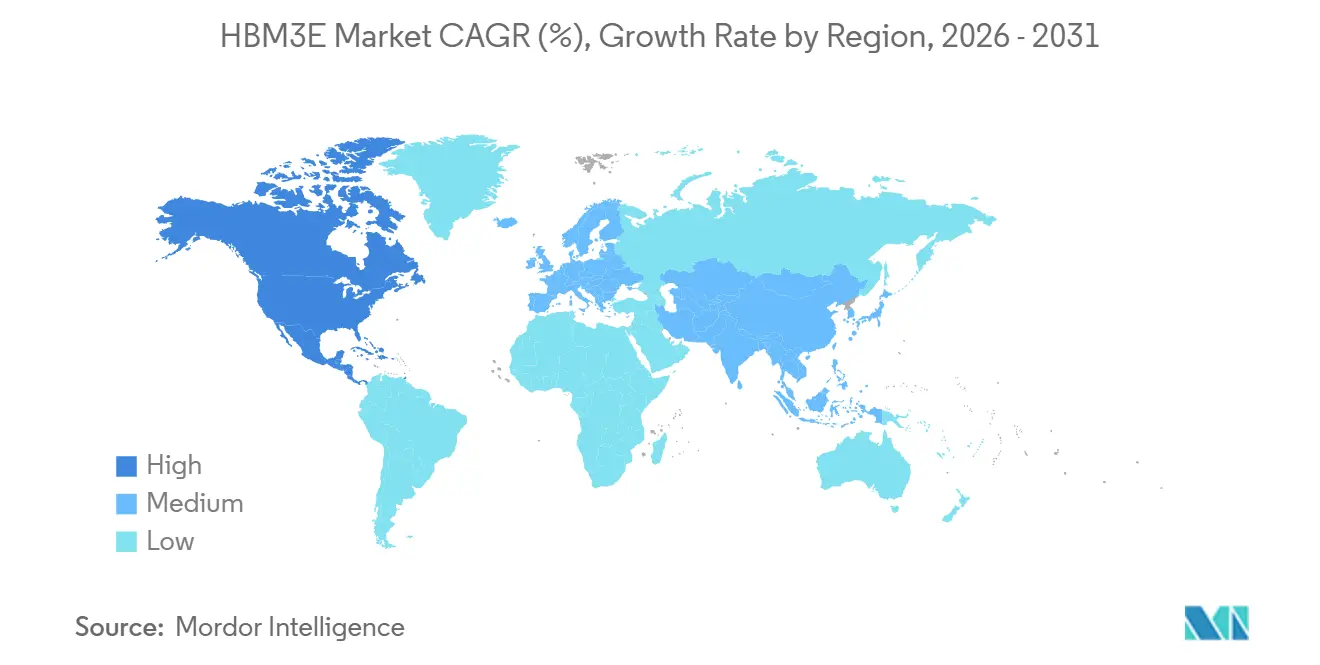
| Schnellstwachsender Markt | Nordamerika |
| Gr??ter Markt | Asien-Pazifik |
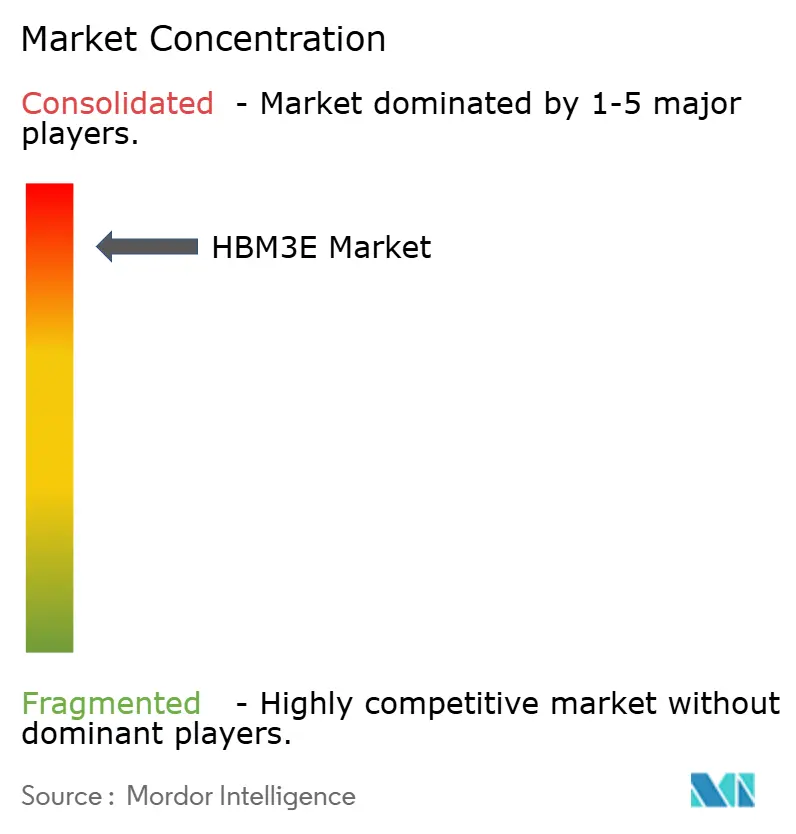
| Marktkonzentration | Hoch |
Hauptakteure
*Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert Bild ? 黑料不打烊. Wiederverwendung erfordert Namensnennung gem?? CC BY 4.0. |
|
HBM3E-Marktanalyse von 黑料不打烊
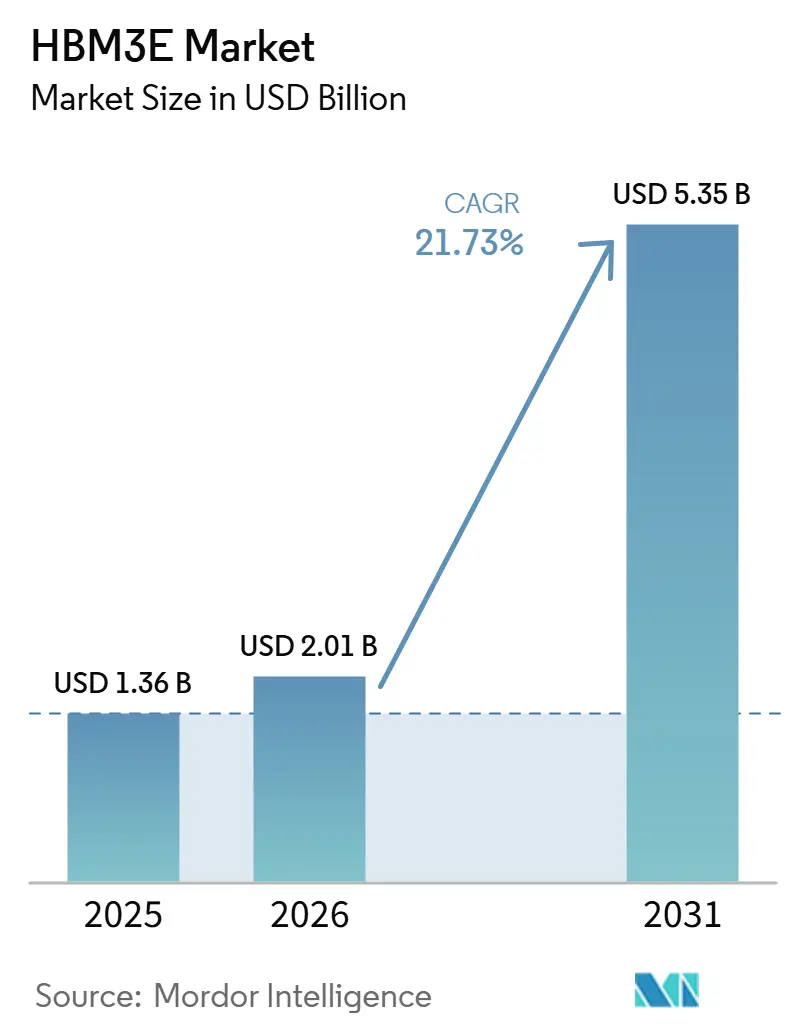
Die HBM3E-Marktgr??e wird voraussichtlich von 1,36 Milliarden USD im Jahr 2025 auf 2,01 Milliarden USD im Jahr 2026 steigen und bis 2031 einen Wert von 5,35 Milliarden USD erreichen, mit einer CAGR von 21,73 % über den Zeitraum 2026–2031. Das Wachstum im HBM3E-Markt wird durch einen starken Anstieg der Speicherkapazit?t pro Beschleuniger angetrieben, wobei der NVIDIA Blackwell Ultra B300 288 GB HBM3E gegenüber 80 GB beim H100 tr?gt, was die Nachfrage steigert, ohne dass ein entsprechender Anstieg der Beschleuniger-Stücklieferungen erforderlich ist. Der HBM3E-Markt profitiert auch davon, dass Hyperscaler die standardm??igen Server-Ersatzzyklen verkürzen, da sie von H100- und H200-Klasse-Systemen auf neuere Plattformen umsteigen, die eine bessere Inferenzwirtschaftlichkeit bieten. Der Markt ist durch eine starke Technologiesperre geschützt, da keine alternative Speicherarchitektur in der Lage ist, die Bandbreiten- und Dichteanforderungen von Flaggschiff-KI-Beschleunigern bei Produktionsausbeuten innerhalb des Prognosezeitraums zu erfüllen. Das Wettbewerbsverhalten im HBM3E-Markt wird durch den Qualifizierungszeitpunkt, den Zugang zu fortschrittlicher Verpackung und die F?higkeit bestimmt, sich in mehrj?hrige Plattform-Roadmaps mit gro?en KI-Chip-Anbietern einzubinden. Gleichzeitig begrenzen die knappe CoWoS-Verpackungskapazit?t und Exportkontrollen für China-gebundene Nachfrage, wie viel dieser Nachfrage im Prognosezeitraum in realisierte Einnahmen umgewandelt werden kann.
Wichtigste Erkenntnisse des Berichts
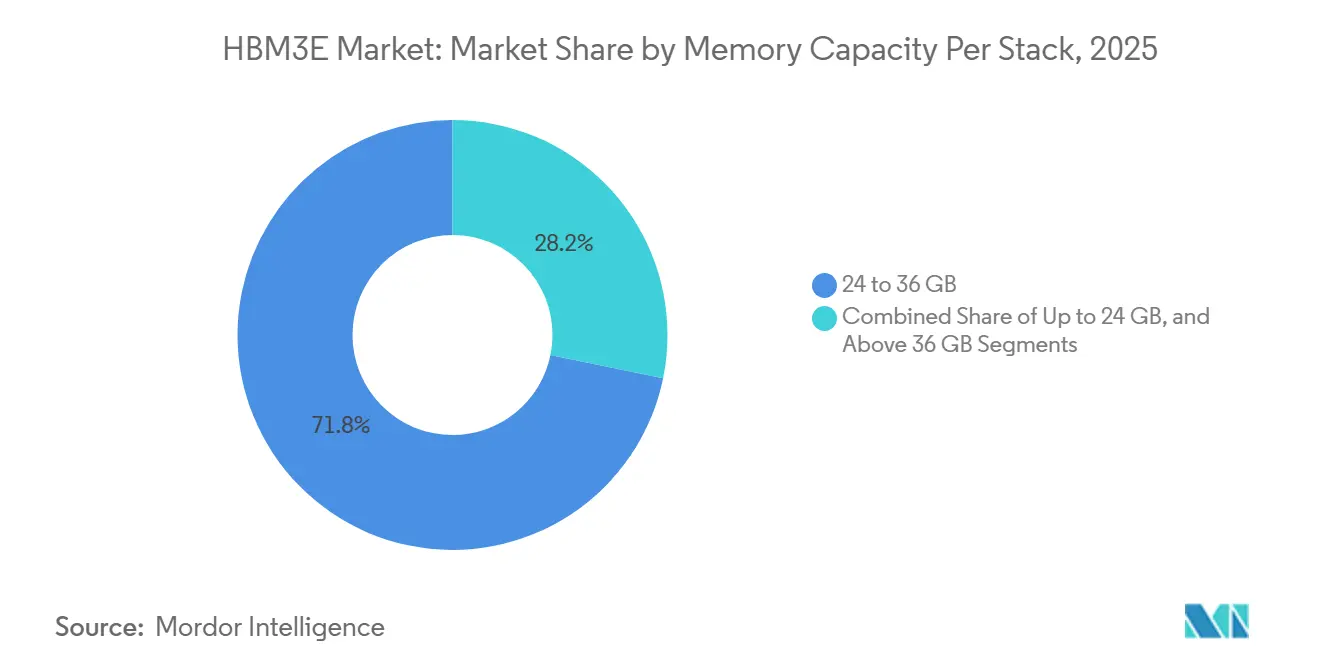
- Nach Speicherkapazit?t pro Stack hielt das Segment 24–36 GB im Jahr 2025 einen HBM3E-Marktanteil von 71,78 %, w?hrend Kapazit?ten über 36 GB bis 2031 voraussichtlich mit einer CAGR von 22,38 % wachsen werden.
- Nach Prozessorschnittstelle entfiel auf GPU im Jahr 2025 ein Umsatzanteil von 76,93 %, w?hrend KI-Beschleuniger und ASICs im HBM3E-Markt bis 2031 die schnellste CAGR von 22,73 % verzeichnen sollen.
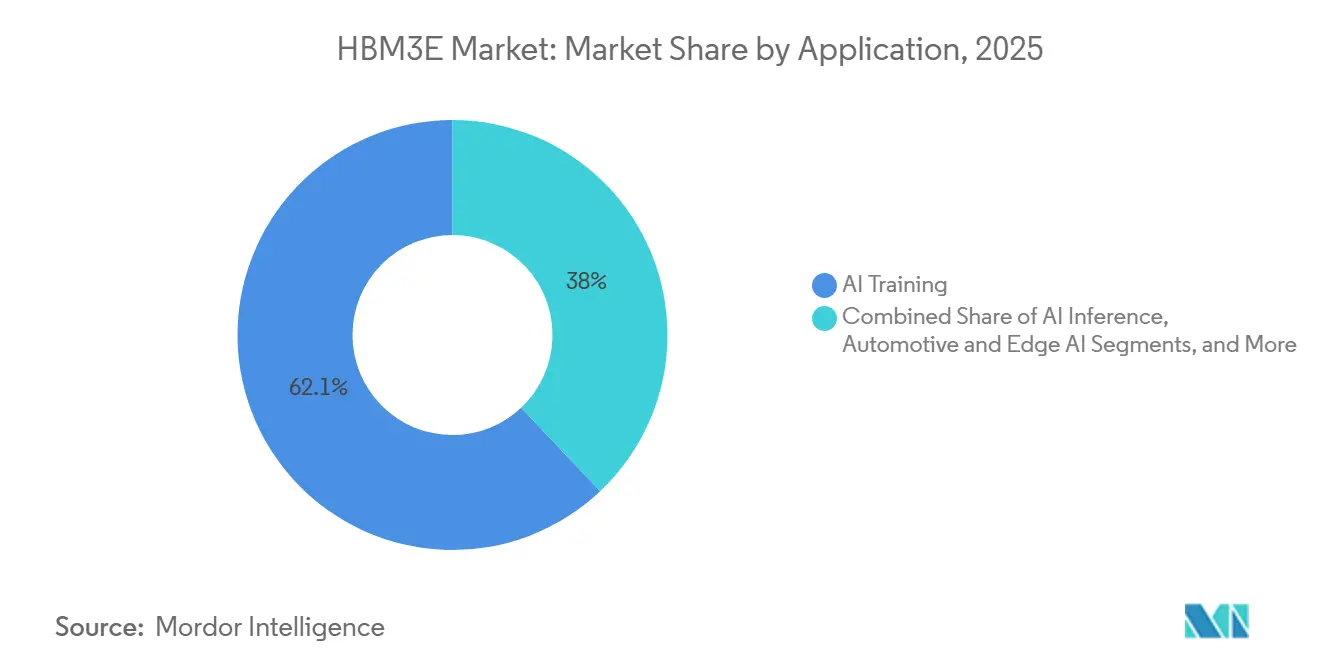
- Nach Anwendung entfiel auf KI-Training im Jahr 2025 ein Anteil von 62,05 % an der HBM3E-Marktgr??e, w?hrend KI-Inferenz bis 2031 voraussichtlich mit einer CAGR von 23,12 % wachsen wird.
- Nach Endverbrauchsbranche trugen Cloud-Dienstleister im Jahr 2025 mit 74,22 % zum Umsatz bei, w?hrend Enterprise-IT im HBM3E-Markt bis 2031 voraussichtlich mit einer CAGR von 22,91 % wachsen wird.
- Nach Geografie entfiel auf den asiatisch-pazifischen Raum im Jahr 2025 ein Umsatzanteil von 61,36 %, w?hrend Nordamerika im HBM3E-Markt bis 2031 voraussichtlich die schnellste CAGR von 22,64 % verzeichnen wird.
Hinweis: Die Marktgr??e und Prognosezahlen in diesem Bericht werden mithilfe des propriet?ren Sch?tzungsrahmens von 黑料不打烊 erstellt und mit den neuesten verfügbaren Daten und Erkenntnissen vom Januar 2026 aktualisiert.
Markttrends und Einblicke
Analyse der Treiberwirkung*
| Treiber | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Zeithorizont der Auswirkung |
|---|---|---|---|
| Rasante Eskalation der KI-Beschleuniger-Bandbreite | +7.2% | Global | Kurzfristig (≤ 2 Jahre) |
| HBM3E-Qualifizierungsvorteil in Premium-GPU-Lieferketten | +4.5% | Asiatisch-pazifischer Raum und Nordamerika | Kurzfristig (≤ 2 Jahre) |
| Steigende Nachfrage nach 12-lagigen und h?heren Stack-Dichten | +3.8% | Global | Mittelfristig (2–4 Jahre) |
| HBM3E-Einführung in hyperscale KI-Server-Erneuerungszyklen | +2.9% | Nordamerika und APAC-Kernregion, Ausweitung auf Europa | Kurzfristig (≤ 2 Jahre) |
| Druck zur Zweitquellen-Qualifizierung bei KI-OEMs | +2.1% | Nordamerika und asiatisch-pazifischer Raum | Mittelfristig (2–4 Jahre) |
| Optimierung der Ausbeute bei fortschrittlicher Verpackung durch Memory-Compute-Co-Design | +1.6% | Global, mit frühen Gewinnen in 厂ü诲办辞谤别补 und Taiwan | Langfristig (≥ 4 Jahre) |
| Quelle: 黑料不打烊 | |||
Rasante Eskalation der KI-Beschleuniger-Bandbreite
KI-Beschleuniger erfordern heute Speicherbandbreitenniveaus, die in früheren kommerziellen Computersystemen nicht zu finden waren. Der HBM3E-Standard selbst wurde für Datenraten pro Pin von über 9 Gbps über eine 1.024-Bit-Schnittstelle und 16 unabh?ngige Kan?le ausgelegt, was zeigt, warum diese Speicherklasse im Mittelpunkt des aktuellen KI-Systemdesigns steht. Da Modellgr??en und Kontextfenster zunehmen, steigt der Datenübertragungsdruck schneller, als viele herk?mmliche Speichersubsysteme bew?ltigen k?nnen, was die Bandbreite weiterhin im Mittelpunkt der Systemengp?sse h?lt.[1]Micron Technology, Inc., "Beschleunigung der Inferenz gro?er Sprachmodelle mit Micron HBM3E," Micron Technology, micron.com Dieses Muster verleiht dem HBM3E-Markt eine strukturelle Nachfragebasis, da K?ufer auf architektonische Einschr?nkungen reagieren und nicht nur auf kurzfristige Budgetzyklen. Es erkl?rt auch, warum der HBM3E-Markt weiter voranschreitet, selbst wenn die KI-Infrastrukturausgaben zwischen Training und Inferenz wechseln. Das Ergebnis ist eine dauerhafte Nachfrage nach Hochbandbreitenspeicher in Premium-KI-Plattformen über den Prognosezeitraum hinaus.
HBM3E-Qualifizierungsvorteil in Premium-GPU-Lieferketten
Der HBM3E-Markt wurde durch einen Qualifizierungsprozess gepr?gt, der als hohe kommerzielle Hürde für Speicheranbieter fungiert. SK Hynix begann im September 2024 mit der weltweit ersten Massenproduktion von 12-lagigem HBM3E und erlangte damit eine frühe Position in Premium-Beschleunigerprogrammen. Micron erkl?rte im Juni 2025, dass sein 36-GB-12-lagiges HBM3E in AMD Instinct MI350 Series-L?sungen integriert und auf mehreren führenden KI-Plattformen qualifiziert wurde. NVIDIA und SK Hynix kündigten dann im Juni 2026 eine mehrj?hrige Technologiepartnerschaft an, die die gemeinsame Entwicklung von Speicher für Vera Rubin KI-Supercomputer, Vera-CPUs, RTX Spark-betriebene PCs und Jetson Thor-Robotikplattformen umfasste. Diese Schritte zeigen, dass der HBM3E-Markt Anbieter belohnt, die sich frühzeitig qualifizieren und über aufeinanderfolgende Plattformgenerationen hinweg in den Kunden-Roadmaps verbleiben. Sie verengen auch das Zeitfenster für Neueinsteiger, die versuchen, etablierte Anbieter in Premium-GPU-Lieferketten zu verdr?ngen.
Steigende Nachfrage nach 12-lagigen und h?heren Stack-Dichten
Der HBM3E-Markt bewegt sich stetig von 8-lagigen Produkten hin zu 12-lagigen und h?heren Stack-Dichte-Konfigurationen. SK Hynix erkl?rte, dass seine 12-lagige HBM3E-Massenproduktion 36 GB pro Stack bei 9,6 Gbps pro Pin und bis zu 1,0 TB/s pro Stack lieferte, was einen wichtigen Schritt in Richtung produktionsreifer Dichte und Bandbreite markiert. Der JEDEC-HBM3E-Standard unterstützt auch den für diese Dichteverschiebung in fortschrittlichen KI-Systemen erforderlichen Leistungsrahmen. Samsungs Ankündigung im Mai 2026 zu HBM4E-Mustern zeigt, dass Anbieter bereits die n?chste Dichtestufe jenseits der aktuellen HBM3E-Volumina vorbereiten, was das Rennen um h?here Stacks in der gesamten Wertsch?pfungskette aktiv h?lt. Dies erh?ht die Fertigungskomplexit?t, da h?here Stacks ein aggressiveres Ausdünnen der Dies, eine schwierigere W?rmekontrolle und eine engere Paketintegration erfordern. Der HBM3E-Markt profitiert daher von einem h?heren Inhalt pro Ger?t, w?hrend das kurzfristige Angebot durch die Schwierigkeit der Skalierung dieser h?herdichten Produkte begrenzt bleibt.
HBM3E-Einführung in hyperscale KI-Server-Erneuerungszyklen
Der HBM3E-Markt wird auch durch Hyperscaler angetrieben, die ihre KI-Server-Flotten schneller erneuern als traditionelle Unternehmens-Ersatzzyklen. Microsoft startete im Januar 2026 den Maia 200 als benutzerdefinierten Inferenzbeschleuniger, der auf TSMCs 3-nm-Prozess basiert, mit 216 GB HBM3E und 7,0 TB/s Bandbreite, was zeigt, dass propriet?res Hyperscaler-Silizium nun eine direkte Nachfragequelle für HBM3E ist. SK Hynix' Marktausblick für 2026 besagte auch, dass Google SK Hynix als ersten HBM3E-Lieferanten für die TPU v7p- und v7e-Serie ausgew?hlt hat, was auf einen zweiten gro?en Beschaffungsweg au?erhalb des NVIDIA-Kernzyklus hinweist. Dies verteilt die Nachfrage auf mehr Kunden und Siliziumtypen und reduziert das mit einer einzelnen Plattform?nderung verbundene Risiko. Es bedeutet auch, dass der HBM3E-Markt nicht mehr nur von der Nachfrage nach Merchant-GPUs abh?ngig ist, da benutzerdefinierte ASIC-Programme nun eigene Speicher-Roadmaps tragen. Diese breitere Kundenmischung unterstützt die Umsatzkontinuit?t über mehrere Erneuerungszyklen hinweg.
Analyse der Hemmnisse*
| Hemmnis | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Zeithorizont der Auswirkung |
|---|---|---|---|
| Begrenzte Kapazit?t für fortschrittliche Verpackung für CoWoS und ?hnliche Interposer | -1.8% | Global | Kurzfristig (≤ 2 Jahre) |
| Exportkontrollen und Kundenkonzentrationsrisiko bei China-gebundener Nachfrage | -1.4% | Asiatisch-pazifischer Raum sowie Naher Osten und Afrika | Mittelfristig (2–4 Jahre) |
| Thermische und Leistungsintegrit?tsbeschr?nkungen in dichten KI-Platinen | -0.8% | Global | Mittelfristig (2–4 Jahre) |
| Qualifizierungsverz?gerungen bei Hochleistungs-12-lagigen HBM3E-Stacks | -1.2% | Global | Kurzfristig (≤ 2 Jahre) |
| Quelle: 黑料不打烊 | |||
Begrenzte Kapazit?t für fortschrittliche Verpackung für CoWoS und ?hnliche Interposer
Der HBM3E-Markt bleibt durch die Kapazit?t für fortschrittliche Verpackung eingeschr?nkt, insbesondere bei CoWoS und verwandten 2,5D-Integrationsprozessen. TSMC beschrieb die KI-bezogene Kapazit?t in seinen Investorenkommunikationen wiederholt als sehr knapp, selbst als das Unternehmen sowohl die Front-End- als auch die Back-End-Unterstützung für die KI-Nachfrage ausweitete. TSMC stellte auch fest, dass sich die CoWoS-Kapazit?t im Jahr 2025 verdoppelt hat, aber vollst?ndig ausgelastet blieb, was darauf hindeutet, dass die Kapazit?tserweiterungen nicht ausreichten, um den Rückstand abzubauen. Dies ist von Bedeutung, da HBM3E-Stacks erst dann zu Einnahmen werden k?nnen, wenn sie über fortschrittliche Verpackungslinien mit Rechen-Dies integriert werden. Die Vorlaufzeiten für Ausrüstungen machen die Einschr?nkung dann schwerer zu l?sen, da neue Bonder und Pr?zisionsplatzierungswerkzeuge Zeit ben?tigen, um in den Volumeneinsatz zu gelangen. Der HBM3E-Markt steht daher vor einer realen Konversionslücke zwischen Speichernachfrage und lieferbaren Beschleunigersystemen.
Exportkontrollen und Kundenkonzentrationsrisiko bei China-gebundener Nachfrage
Der HBM3E-Markt sieht sich auch politischen Einschr?nkungen durch Exportkontrollen ausgesetzt, die den Zugang zu einem Teil der adressierbaren Kundenbasis begrenzen. Das Bureau of Industry and Security der Vereinigten Staaten erkl?rte im Dezember 2024, dass HBM2e, HBM3, HBM3E und HBM4 unter ECCN 3A090.c fallen, mit einer globalen Lizenzpflicht für Exporte nach Macau und L?nder der Gruppe D:5. Diese Regelung entzieht einen Teil der China-gebundenen Nachfrage dem normalen Marktzugang und fügt Compliance-Reibung für Transaktionen hinzu, die mit sensiblen Endnutzern verbunden sind. Der Effekt ist st?rker, weil die Kundenbasis bereits auf eine kleine Anzahl fortschrittlicher KI-K?ufer konzentriert ist. Es begrenzt auch die Nachfragesichtbarkeit in Regionen, in denen die Endnutzerverifizierung komplexer sein kann als in etablierten OECD-Lieferketten. Der HBM3E-Markt w?chst daher von einer engeren zug?nglichen Basis aus, als die reine Technologienachfrage allein vermuten l?sst.
*Unsere Prognosen behandeln die Auswirkungen von Treibern und Einschr?nkungen als richtungsweisend und nicht additiv. Die Wirkungsprognosen berücksichtigen Basiswachstum, Mischungseffekte und Wechselwirkungen zwischen Variablen.
Segmentanalyse
Nach Speicherkapazit?t pro Stack:
12-lagige Konfiguration verankert die MarktstrukturDas Segment 24 bis 36 GB hielt im Jahr 2025 einen Umsatzanteil von 71,78 % und war damit das gr??te Speicherkapazit?tssegment im HBM3E-Markt. Dieser Bereich konzentriert sich auf 36-GB-12-lagige Produkte, die Flaggschiff-KI-Beschleuniger von NVIDIA und AMD unterstützen, was erkl?rt, warum es zum kommerziellen Kern des HBM3E-Marktes wurde. Der JEDEC-HBM3E-Standard unterstützt diese Konfiguration mit einer breiten Schnittstelle und h?heren Datenraten pro Pin, was das Segment für dichte KI-Workloads geeignet macht. Das Segment bis zu 24 GB blieb im Jahr 2025 für ?ltere KI-Server-Deployments, Netzwerkanwendungsf?lle und kostenempfindliche Inferenzsysteme relevant, bei denen absolute Bandbreite weniger kritisch ist. Dennoch verlagert der HBM3E-Markt seinen Schwerpunkt weg von diesen Produkten mit geringerer Kapazit?t, da Kunden zu gr??eren Speicher-Footprints pro Beschleuniger übergehen.
SK Hynix' weltweit erste Massenproduktion von 12-lagigem HBM3E im September 2024 zeigte, dass 12-lagige Produkte bereits von der Entwicklung in die skalierte kommerzielle Produktion übergegangen waren.[2]SK hynix Inc., "SK hynix beginnt weltweit erste Massenproduktion von 12-lagigem HBM3E," SK hynix Korean Newsroom, news.skhynix.co.kr Diese Produktionsverschiebung ist von Bedeutung, da der HBM3E-Markt nun genauso sehr von der Stack-H?he wie vom Wafervolumen abh?ngt, wenn Anbieter versuchen, den Umsatz zu steigern. ?ber 36 GB wird bis 2031 voraussichtlich mit einer CAGR von 22,38 % wachsen, was die Nachfrage nach 16-lagigen und anderen zukünftigen hochdichten Formaten in Systemen der n?chsten Generation widerspiegelt. Samsungs Ankündigung im Mai 2026 über den Versand eines HBM4E-Musters zeigt, dass Anbieter bereits dichtere Speicherpakete vorbereiten, was die Richtung hin zu h?heren Stacks verst?rkt. Der HBM3E-Marktanteil von 24 bis 36 GB im Jahr 2025 spiegelt die aktuelle Deployment-Realit?t wider, w?hrend Produkte über diesem Bereich das zukünftige Wachstum antreiben.


Nach Prozessorschnittstelle:
Benutzerdefiniertes Silizium st?rt die GPU-DominanzGPU entfiel im Jahr 2025 auf 76,93 % des Umsatzes, was Grafikprozessoren als Hauptschnittstellenkategorie im HBM3E-Markt beibehielt. Dieser Anteil spiegelt die Konzentration der aktuellen HBM3E-Beschaffung in NVIDIA Blackwell-Systemen und AMD Instinct-Plattformen wider, die beide gro?e Trainingscluster und fortschrittliche Inferenzinfrastruktur verankern. Der HBM3E-Markt stützt sich weiterhin stark auf Merchant-GPU-Roadmaps, da diese Plattformen die gr??ten Volumenverpflichtungen von Hyperscalern und fortschrittlichen KI-Systemk?ufern antreiben. CPU- und FPGA-Schnittstellen blieben im Jahr 2025 kleiner, da ihre Anwendungsf?lle enger und spezialisierter waren. Dennoch wird der HBM3E-Markt nicht mehr nur durch GPU-Nachfrage definiert, da benutzerdefinierte Silizium-Programme nun in dieselbe Speicherklasse eintreten.
KI-Beschleuniger und ASICs werden bis 2031 voraussichtlich mit einer CAGR von 22,73 % wachsen und sind damit die am schnellsten wachsenden Prozessorschnittstellen im HBM3E-Markt. Microsofts Maia 200-Start im Januar 2026 zeigte diesen Wandel deutlich, mit einem benutzerdefinierten Inferenzbeschleuniger, der 216 GB HBM3E und 7,0 TB/s Bandbreite integriert. SK Hynix erkl?rte auch, dass Google es als ersten HBM3E-Lieferanten für TPU v7p und v7e ausgew?hlt hat, was best?tigt, dass Hyperscaler-ASIC-Programme zu einem bedeutenden zweiten Kanal für die Nachfrage werden. Diese Verschiebung reduziert die Abh?ngigkeit von einem Anbieter-Zyklus und gibt dem HBM3E-Markt eine breitere Kundenbasis sowohl bei Merchant- als auch bei propriet?rem KI-Silizium. Es bedeutet auch, dass der zukünftige Schnittstellenmix wahrscheinlich weniger GPU-lastig wird, selbst wenn die GPU-Stückvolumina weiter steigen.
Nach Anwendung:
Inferenz-Dynamik ver?ndert den NachfragemixKI-Training entfiel im Jahr 2025 auf 62,05 % des Umsatzes und war damit die führende Anwendung im HBM3E-Markt. Diese Position war mit dem Vortraining von Frontier-Modellen verbunden, bei dem dichte GPU-Cluster über lange Zeitr?ume laufen und anhaltenden Druck auf Speicherbandbreite und -kapazit?t ausüben. Microns technisches Material zu HBM3E hob hervor, wie diese Speicherklasse die Inferenz gro?er Sprachmodelle und fortschrittliche KI-Workloads durch hohe Bandbreite und geringere Datenübertragungsreibung unterstützt. Hochleistungsrechnen blieb ebenfalls eine stabile Anwendungsbasis, da HBM-Architekturen bereits vor der aktuellen KI-Welle im wissenschaftlichen und Forschungsrechnen validiert wurden. Der HBM3E-Markt trat daher in das Jahr 2026 ein, wobei das Training weiterhin im Mittelpunkt der Einnahmen stand, aber eine breitere Anwendungsbasis sich darum herum bildete.
KI-Inferenz wird bis 2031 voraussichtlich mit einer CAGR von 23,12 % wachsen und ist damit die am schnellsten wachsende Anwendung im HBM3E-Markt. Microsofts Maia 200-Start war ein klares Zeichen dieses Wandels, da er als Inferenzbeschleuniger und nicht als allgemeine trainingsbasierte Plattform positioniert wurde. Inferenz erweitert auch den HBM3E-Markt, indem sie mehr ASIC-basierte Deployments und eine breitere Palette von Kundenarchitekturen erm?glicht. Netzwerk, Telekommunikation, Automotive und Edge-KI sind noch kleinere Anwendungsbereiche, tragen aber zur Breite der langfristigen Nachfrage bei, da KI-Workloads n?her an den Netzwerkrand und an spezialisierte Bordsysteme rücken. Die HBM3E-Marktgr??e im Zusammenhang mit Inferenz steigt daher nicht nur, weil die Inferenzvolumina zunehmen, sondern auch weil die Anzahl der Hardware-Wege, die diese Workloads bedienen, zunimmt.
Nach Endverbrauchsbranche:
Enterprise-Deployment verringert die Cloud-KonzentrationCloud-Dienstleister entfielen im Jahr 2025 auf 74,22 % des Umsatzes und waren damit das klare Führungssegment im HBM3E-Markt. Diese Konzentration spiegelte die Kaufkraft der Hyperscaler wider, die das Angebot durch gro?e Vorabverpflichtungen sichern und HBM3E in GPU- und benutzerdefinierte ASIC-Roadmaps integrieren konnten. Microsofts Maia 200-Start und Googles TPU-bezogene HBM3E-Beschaffung zeigen, wie gro?e Cloud-Betreiber die direkte Speichernachfrage durch ihre eigenen Silizium-Programme und Merchant-Plattformen gestalten. Dies machte die Cloud zur Ankerkunden-Gruppe für den HBM3E-Markt im Jahr 2025. Es erh?hte auch die Hürde für kleinere K?ufer, denen oft der gleiche Zugang zu langfristigen Liefervereinbarungen fehlte.
Enterprise-IT wird bis 2031 voraussichtlich mit einer CAGR von 22,91 % wachsen und ist damit das am schnellsten wachsende Endverbrauchssegment im HBM3E-Markt. Dieses Wachstum spiegelt eine schrittweise Verlagerung gro?er Unternehmen hin zu eigener KI-Infrastruktur für private Inferenz und Modell-Feinabstimmung wider, wenn Datenkontrolle und Latenz wichtiger sind als flexibler Cloud-Zugang. Der HBM3E-Markt verzeichnet auch Interesse aus Telekommunikation, Automotive, Luft- und Raumfahrt sowie Verteidigung, Gesundheitsbildgebung, Finanzdienstleistungen und wissenschaftlicher Forschung, auch wenn diese heute noch kleinere Nachfragepools darstellen. Diese Sektoren sch?tzen hochbandbreite, kompakte Pakete für spezialisierte Workloads und helfen, die Nachfrage über die Hyperscaler-Konzentration hinaus auszudehnen. Der HBM3E-Markt wird daher über den Prognosezeitraum hinweg cloud-geführt bleiben, w?hrend die Enterprise-Einführung die Endnutzermischung langsam verbreitert.
Geografische Analyse
HBM3E-Markt 厂ü诲办辞谤别补 und Taiwan
Der asiatisch-pazifische Raum hatte 2025 einen Umsatzanteil von 61,36 % und war damit der führende regionale Block im HBM3E-Markt. 厂ü诲办辞谤别补 bleibt das Produktionszentrum, da SK hynix Inc. und Samsung Electronics Co., Ltd. den Gro?teil der HBM-Wafer- und Stapelkapazit?ten betreiben, die im aktuellen Zyklus eingesetzt werden. Der Marktausblick von Hynix für 2026 beschrieb zudem den starken HBM-Sog nach Taiwan, wo fortschrittliche Packaging-Linien Speicherstapel mit KI-Beschleuniger-Logikchips verbinden. Taiwan erg?nzt die Packaging-Ebene durch TSMC, dessen CoWoS-Linien ein kritischer Engpass für den Systemaussto? bleiben.[3]Taiwan Semiconductor Manufacturing Company, "Transkripte von Investoren-Relations-Earnings-Calls und Quartalsberichte," TSMC Investor Relations, investor.tsmc.com Diese Korea-Taiwan-Produktionsverbindung erkl?rt, warum der asiatisch-pazifische Raum 2025 den gr??ten Anteil am HBM3E-Marktvolumen hielt.
HBM3E-Markt Nordamerika
Nordamerika wird voraussichtlich bis 2031 mit einem CAGR von 22,64 % wachsen und ist damit die am schnellsten wachsende Region im HBM3E-Markt. Die Region profitiert von konzentrierten KI-Infrastrukturausgaben durch Hyperscaler sowie von einer hohen Nachfragesichtbarkeit rund um den Einsatz fortschrittlicher Beschleuniger. Microsofts Maia-200-Launch im Januar 2026 zeigte, dass die nordamerikanische Nachfrage nicht auf den Kauf von Merchant-GPUs beschr?nkt ist, da auch kundenspezifische Silizium-Programme den HBM3E-Verbrauch antreiben. Die Erkl?rung von Micron Technology, Inc. vom Juni 2025 zur AMD-Plattformintegration unterstrich zudem die Rolle Nordamerikas bei der Gestaltung der Produktqualifizierung und Kundenausrichtung für den HBM3E-Markt. Die Region vereint daher Endnachfrage, Plattformeinfluss und strategische Versorgungsplanung, um ein überdurchschnittliches Marktwachstum zu unterstützen.
HBM3E-Markt EMEA und 厂ü诲补尘别谤颈办补
Europa, 厂ü诲补尘别谤颈办补, der Nahe Osten und Afrika entfielen 2025 auf den verbleibenden Anteil am HBM3E-Markt, wobei jede Region noch im einstelligen Bereich beitrug. In Europa wird die Nachfrage haupts?chlich durch wissenschaftliches Rechnen, fortschrittliche Forschungsinfrastruktur und wachsende Rechenzentrumskapazit?ten zur Unterstützung von KI-Workloads angetrieben. 厂ü诲补尘别谤颈办补 befindet sich noch in einem früheren Stadium, wobei die Einführung auf eine kleine Anzahl von L?ndern konzentriert ist, in denen Cloud- und digitale Infrastrukturinvestitionen beginnen zu skalieren. Der Nahe Osten und Afrika entwickeln sich durch souver?ne KI-Programme und GPU-Cluster-Eins?tze zu einer Nachfrageregion, obwohl die Einhaltung von Exportkontrollvorschriften eine weitere Komplexit?tsebene für die Beschaffung in sensiblen Zielregionen darstellt.

Wettbewerbslandschaft
Der HBM3E-Markt ist eines der konzentriertesten Segmente der Halbleiter-Wertsch?pfungskette, da SK Hynix, Samsung Electronics und Micron Technology die qualifizierte Lieferbasis für führende KI-Plattformen bilden. Der Wettbewerb im HBM3E-Markt wird weniger durch den Preis als durch den Qualifizierungszeitpunkt, die Stack-Ausbeute, die W?rmekontrolle und den Zugang zu fortschrittlicher Verpackung bestimmt. SK Hynix st?rkte seine Position durch die weltweit erste 12-lagige HBM3E-Massenproduktion im September 2024, was ihm einen starken frühen Vorsprung in Premium-Beschleunigerprogrammen verschaffte. Diese Position wurde schwerer anfechtbar, als NVIDIA und SK Hynix im Juni 2026 eine mehrj?hrige Technologiepartnerschaft ankündigten, die Speicher für mehrere zukünftige Produktfamilien abdeckt. Der HBM3E-Markt belohnt daher Anbieter, die frühe technische Bereitschaft in langfristige Roadmap-Kontrolle umwandeln k?nnen.
Micron hat die Plattformqualifizierung als seinen Hauptweg genutzt, um im HBM3E-Markt Boden zu gewinnen. Im Juni 2025 erkl?rte Micron, dass sein 36-GB-12-lagiges HBM3E in AMD Instinct MI350 Series-L?sungen integriert und auf mehreren führenden KI-Plattformen qualifiziert wurde. Micron verst?rkte auch weiterhin seine Produktpositionierung durch technische Botschaften rund um die HBM3E-Leistung für KI-Workloads. Samsung blieb aktiv, indem es Speichermuster der n?chsten Generation vorantrieb, einschlie?lich seiner Ankündigung im Mai 2026 über branchenweit erste HBM4E-Musterlierferungen. Diese Ma?nahmen zeigen, dass der HBM3E-Markt heute durch Plattformzugang und morgen durch die Vorbereitung auf dichtere Folgeprodukte umk?mpft wird.
Der breitere HBM3E-Markt h?ngt auch von Unternehmen au?erhalb der Speicherfertigungsindustrie ab. TSMC bleibt unverzichtbar, da die CoWoS-Integration bestimmt, wie schnell der Speicheroutput zu einer einsetzbaren Beschleuniger-Versorgung wird. Die Co-Optimierungsarbeit von SEMI im Jahr 2025 zeigte auch, dass die zukünftige Wettbewerbsf?higkeit von einer engeren Koordination zwischen thermischem, elektrischem und mechanischem Design über Die-, Paket- und Systemebenen hinweg abh?ngen wird.[4]Seung Kang, "Co-Optimierung von Halbleitersystemen für KI-Beschleuniger," SEMI, semi.org Dies bedeutet, dass der HBM3E-Markt weiterhin Unternehmen bevorzugen wird, die Speicherdesign, Verpackungsbereitschaft und Kundenqualifizierung innerhalb desselben Produktzyklus aufeinander abstimmen k?nnen. Es l?sst auch wenig Raum für Neueinsteiger, die nicht in der Lage sind, mit etablierten Anbietern in all diesen Ausführungspunkten mitzuhalten.
贬叠惭3贰-叠谤补苍肠丑别苍蹿ü丑谤别谤
-
SK hynix Inc.
-
Samsung Electronics Co., Ltd.
-
Micron Technology, Inc.
- *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert
HBM3E-Markt
- SK hynix Inc.
- Samsung Electronics Co., Ltd.
- Micron Technology, Inc.

Recent Industry Developments in HBM3E-Markt
- Juni 2026: SK Hynix lieferte laut einer Unternehmenspressemitteilung vom 17. Juni 2026 Muster seines 12-lagigen HBM4E an wichtige globale Kunden. Das Unternehmen erkl?rte, dass es die w?hrend der HBM3E-Produktion aufgebaute Massenproduktions- und Lieferexpertise genutzt hat, um HBM4E-Muster termingerecht zu liefern, und dass es eng mit Partnern zusammenarbeiten wird, um die Massenproduktion ?zeitnah” zu liefern.
- Juni 2026: Samsung Electronics best?tigte offiziell die Lieferung seiner 12-lagigen HBM3E-Chips an AMD, integriert in die AMD Instinct MI350X- und MI355X-Beschleuniger-Plattformen, die bei AMDs Medienevent im Juni 2026 vorgestellt wurden. Die Best?tigung markierte Samsungs erste ?ffentlich anerkannte HBM3E-Lieferung an einen namentlich genannten KI-Chip-Kunden nach seiner NVIDIA-12-lagigen Qualifizierung im September 2025.
- Juni 2026: NVIDIA Corporation und SK Hynix kündigten am 7. Juni 2026 eine mehrj?hrige Technologiepartnerschaft an, die die gemeinsame Entwicklung von Speicher für NVIDIA Vera Rubin KI-Supercomputer, Vera-CPUs, RTX Spark-betriebene PCs und Jetson Thor-Robotikplattformen umfasst. Die Vereinbarung umfasst auch die Nutzung von NVIDIA CUDA-X-Bibliotheken und NVIDIA PhysicsNeMo zur Beschleunigung von Halbleiterchip-Design-Simulationen in SK Hynix' Fertigungsanlagen.
- Januar 2026: Microsoft Corporation startete den Maia 200, einen benutzerdefinierten Inferenzbeschleuniger, der auf TSMCs 3-nm-Prozess basiert, mit 216 GB HBM3E bei 7,0 TB/s Bandbreite und 272 MB On-Chip-SRAM. Microsoft erkl?rte, dass Maia 200 zum Startdatum eine um 30 % bessere Leistung pro Dollar liefert als die neueste Hardware-Generation in seiner Flotte.
- Juni 2025: Micron Technology kündigte die Integration seines HBM3E 36-GB-12-lagigen Produkts in AMD Instinct MI350 Series-L?sungen an, was eine Zweitquellen-Qualifizierung neben Samsung markiert und Micron als qualifizierten Lieferanten auf mehreren führenden KI-Plattformen etabliert. Microns Investor Relations best?tigte, dass das Produkt zu diesem Datum ?auf mehreren führenden KI-Plattformen qualifiziert” war.


Globaler HBM3E-Marktberichtsumfang
Der HBM3E-Markt ist segmentiert nach Speicherkapazit?t pro Stack (bis zu 24 GB, 24–36 GB und über 36 GB), Prozessorschnittstelle (GPU, CPU, KI-Beschleuniger, ASIC, FPGA und andere Schnittstellen), Anwendung (KI-Training, KI-Inferenz, Hochleistungsrechnen (HPC)-Server, Netzwerk und Telekommunikation, Automotive und Edge-KI und andere Anwendungen), Endverbrauchsbranche (Cloud-Dienstleister, Enterprise-IT, Telekommunikation, Automotive, Luft- und Raumfahrt sowie Verteidigung und andere Endnutzerindustrien) sowie Geografie (Nordamerika, Europa, asiatisch-pazifischer Raum, 厂ü诲补尘别谤颈办补 sowie Naher Osten und Afrika). Die Marktprognosen werden in Wertangaben (USD) bereitgestellt.
| Bis zu 24 GB |
| 24 bis 36 GB |
| ?ber 36 GB |
| GPU |
| CPU |
| KI-Beschleuniger und ASIC |
| FPGA |
| Andere Schnittstellen |
| KI-Training |
| KI-Inferenz |
| Hochleistungsrechnen (HPC)-Server |
| Netzwerk und Telekommunikation |
| Automotive und Edge-KI |
| Andere Anwendungen |
| Cloud-Dienstleister |
| Enterprise-IT |
| Telekommunikation |
| Automotive |
| Luft- und Raumfahrt sowie Verteidigung |
| Andere Endnutzerindustrien |
| Nordamerika | Vereinigte Staaten |
| Kanada | |
| Mexiko | |
| Europa | Deutschland |
| Vereinigtes K?nigreich | |
| Frankreich | |
| Italien | |
| ?briges Europa | |
| Asiatisch-pazifischer Raum | China |
| Japan | |
| 厂ü诲办辞谤别补 | |
| Taiwan | |
| Indien | |
| ?briger asiatisch-pazifischer Raum | |
| 厂ü诲补尘别谤颈办补 | |
| Naher Osten und Afrika |
| Nach Speicherkapazit?t pro Stack | Bis zu 24 GB | |
| 24 bis 36 GB | ||
| ?ber 36 GB | ||
| Nach Prozessorschnittstelle | GPU | |
| CPU | ||
| KI-Beschleuniger und ASIC | ||
| FPGA | ||
| Andere Schnittstellen | ||
| Nach Anwendung | KI-Training | |
| KI-Inferenz | ||
| Hochleistungsrechnen (HPC)-Server | ||
| Netzwerk und Telekommunikation | ||
| Automotive und Edge-KI | ||
| Andere Anwendungen | ||
| Nach Endverbrauchsbranche | Cloud-Dienstleister | |
| Enterprise-IT | ||
| Telekommunikation | ||
| Automotive | ||
| Luft- und Raumfahrt sowie Verteidigung | ||
| Andere Endnutzerindustrien | ||
| Nach Geografie | Nordamerika | Vereinigte Staaten |
| Kanada | ||
| Mexiko | ||
| Europa | Deutschland | |
| Vereinigtes K?nigreich | ||
| Frankreich | ||
| Italien | ||
| ?briges Europa | ||
| Asiatisch-pazifischer Raum | China | |
| Japan | ||
| 厂ü诲办辞谤别补 | ||
| Taiwan | ||
| Indien | ||
| ?briger asiatisch-pazifischer Raum | ||
| 厂ü诲补尘别谤颈办补 | ||
| Naher Osten und Afrika | ||


Im Bericht beantwortete Schlüsselfragen
Wie gro? ist der HBM3E-Markt aktuell und wie wird er prognostiziert?
Die HBM3E-Marktgr??e betr?gt im Jahr 2026 2,01 Milliarden USD und wird bis 2031 voraussichtlich 5,35 Milliarden USD erreichen, bei einer CAGR von 21,73 % über den Zeitraum 2026 bis 2031.
Welches Speicherkapazit?tssegment führt die HBM3E-Nachfrage an?
Das Segment 24 bis 36 GB führte im Jahr 2025 mit 71,78 % des Umsatzes, unterstützt durch eine starke Einführung von 12-lagigen 36-GB-Konfigurationen in Premium-KI-Beschleunigern.
Welche Prozessorschnittstelle w?chst am schnellsten bei der HBM3E-Einführung?
KI-Beschleuniger und ASIC ist die am schnellsten wachsende Schnittstelle mit einer prognostizierten CAGR von 22,73 % bis 2031, da Hyperscaler benutzerdefinierte Silizium-Programme ausbauen.
Warum wird KI-Inferenz für HBM3E-Anbieter immer wichtiger?
KI-Inferenz wird bis 2031 voraussichtlich mit einer CAGR von 23,12 % wachsen, was die Nachfrage über Trainingscluster hinaus verbreitert und die Rolle benutzerdefinierter Beschleuniger-Deployments erh?ht.
Welche Endnutzergruppe dominiert weiterhin die K?ufe?
Cloud-Dienstleister blieben im Jahr 2025 die gr??te Endnutzergruppe und entfielen auf 74,22 % des Umsatzes, da Hyperscaler weiterhin die gr??ten Beschaffungsprogramme antreiben.
Welche Region w?chst am schnellsten und welche führt beim Umsatz?
Der asiatisch-pazifische Raum führte im Jahr 2025 beim Umsatz mit 61,36 %, w?hrend Nordamerika bis 2031 voraussichtlich am schnellsten mit einer CAGR von 22,64 % wachsen wird.
Seite zuletzt aktualisiert am:



