
Tamanho e Participa??o do Mercado de HBM para Comuta??o de Rede e Processamento de Pacotes
Vis?o Geral do Mercado
| Período de Estudo | 2020 - 2031 |
|---|---|
| Tamanho do Mercado (2026) | 0.21 Bilh?es de dólares |
| Tamanho do Mercado (2031) | 1.18 Bilh?es de dólares |
| Growth Rate (2026 - 2031) | 41.23 % |
| Mercado de Crescimento Mais Rápido | ?蝉颈补-笔补肠í蹿颈肠辞 |
| Maior Mercado | América do Norte |
| Concentra??o do Mercado | Alto |
Principais jogadores
*Isen??o de responsabilidade: Principais participantes classificados em nenhuma ordem específica Imagem ? 黑料不打烊. O reuso requer atribui??o conforme CC BY 4.0. |
|
Análise do Mercado de HBM para Comuta??o de Rede e Processamento de Pacotes pela 黑料不打烊
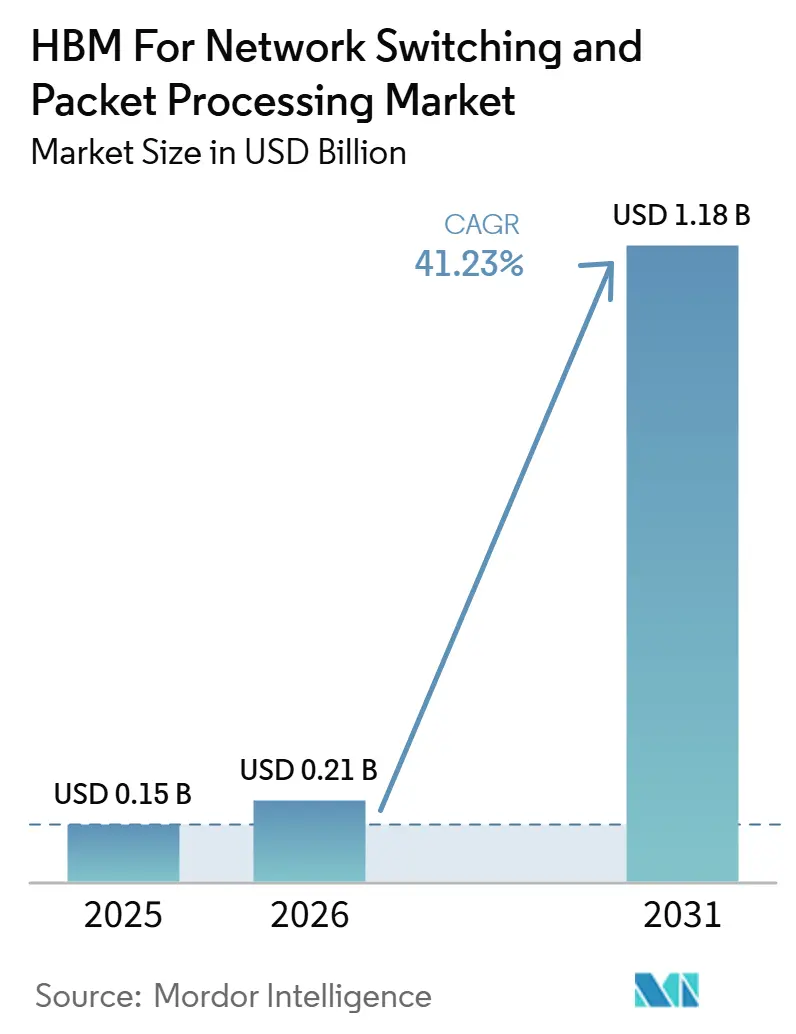
Espera-se que o mercado de HBM para comuta??o de rede e processamento de pacotes aumente de 0,15 bilh?es de USD em 2025 para 0,21 bilh?es de USD em 2026, e atinja 1,18 bilh?es de USD até 2031, crescendo a um CAGR de 41,23% ao longo de 2026-2031. O mercado está sendo impulsionado pelos gastos sustentados em infraestrutura de IA, pois clusters de treinamento muito grandes est?o empurrando os dispositivos de rede para um modelo de design limitado por memória, em vez de um modelo simples de taxa de transferência. A mudan?a do armazenamento em buffer de pacotes convencional baseado em DDR para HBM empilhado em 3D dentro de ASICs de comutadores está mudando a forma como os fornecedores projetam plataformas para tráfego de classe terabit, baixa latência e eficiência energética. As remessas de produ??o de silício de comutadores de 102,4 Tbps em 2026 mostraram que essa transi??o havia avan?ado além das amostras iniciais e entrado em implanta??o comercial. Acordos plurianuais entre hiperescaladores e fornecedores de silício est?o melhorando a visibilidade da demanda de longo prazo e dando aos compradores maiores um controle mais forte sobre o acesso ao fornecimento. As limita??es de embalagem avan?ada e os requisitos de conformidade com controles de exporta??o ainda criam acesso desigual para os compradores, favorecendo os maiores operadores de nuvem e elevando o nível para fornecedores de redes menores.
Principais Conclus?es do Relatório
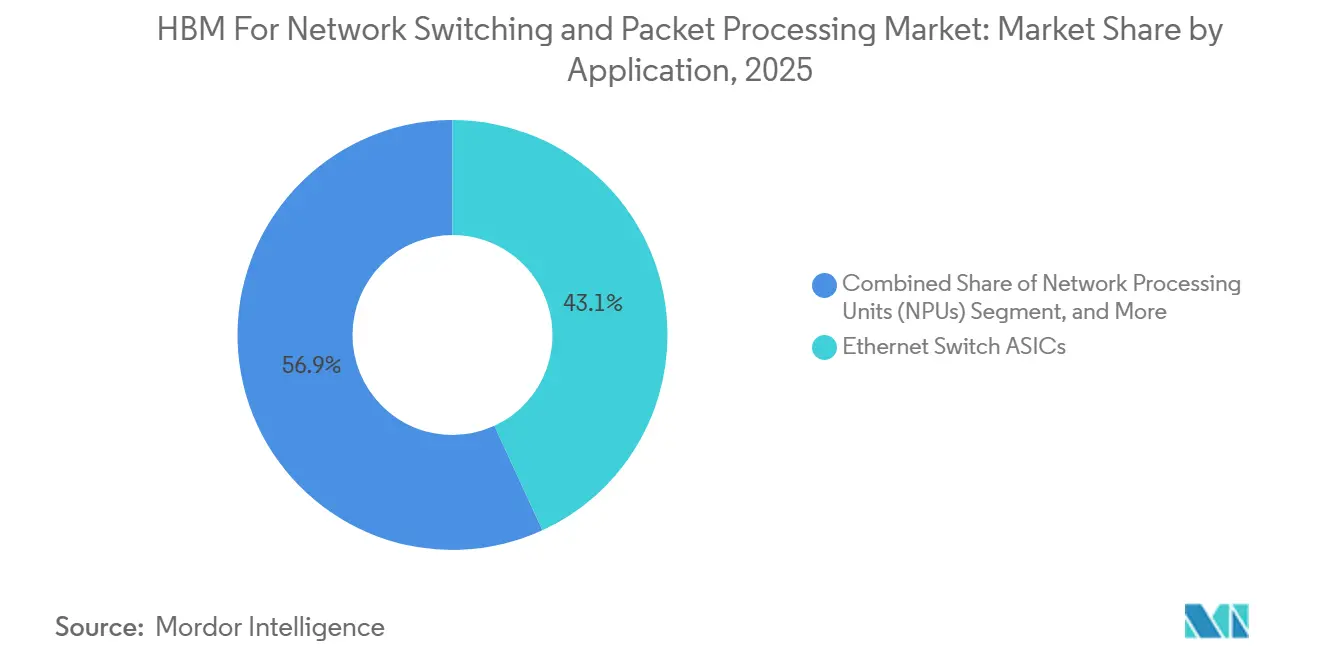
- Por aplica??o, os ASICs de comutadores Ethernet detinham 43,13% da participa??o de receita em 2025, enquanto os comutadores de malha de rede de IA est?o projetados para se expandir a um CAGR de 42,03% até 2031 no mercado de HBM para comuta??o de rede e processamento de pacotes.
- Por gera??o de HBM, o HBM3 comandava uma participa??o de 55,92% em 2025, enquanto o HBM4 está projetado para crescer a um CAGR de 42,21% até 2031 no mercado de HBM para comuta??o de rede e processamento de pacotes.
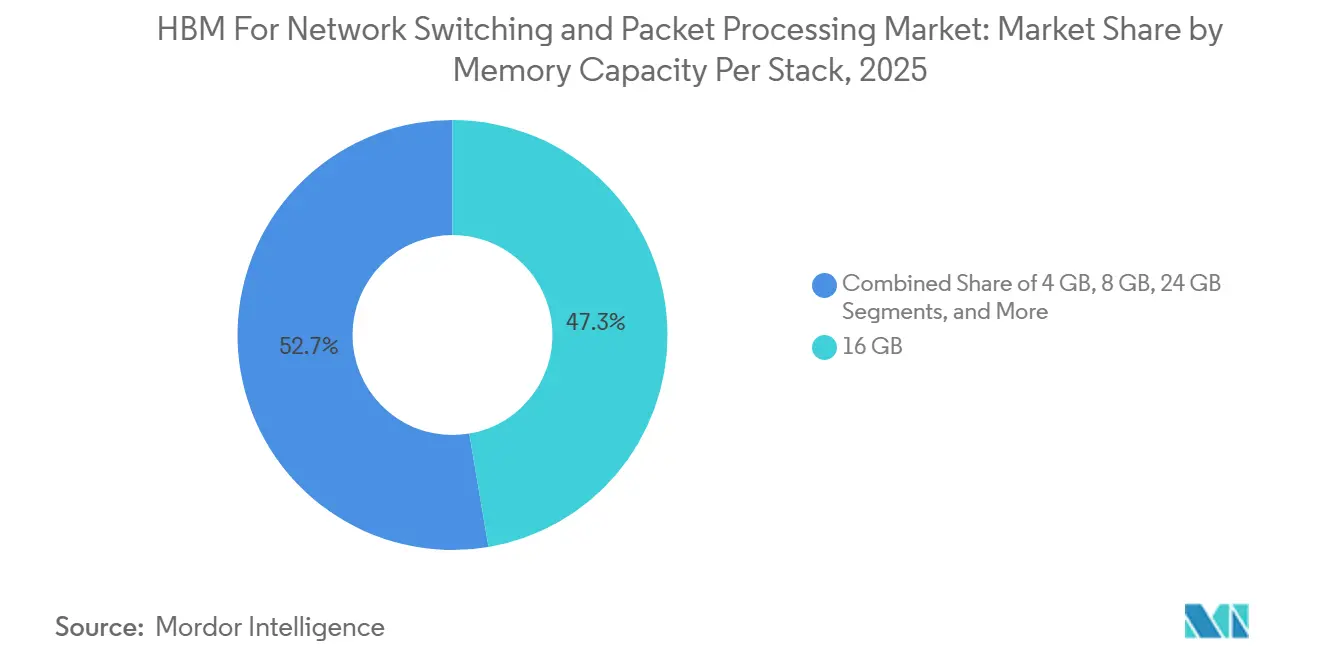
- Por capacidade de memória por pilha, 16 GB capturou uma participa??o de 47,32% em 2025, enquanto 32 GB e acima está projetado para avan?ar a um CAGR de 42,17% até 2031 no mercado de HBM para comuta??o de rede e processamento de pacotes.
- Por setor do usuário final, os data centers em nuvem responderam por 78,03% da demanda em 2025, enquanto as redes de computa??o de alto desempenho est?o projetadas para crescer a um CAGR de 42,09% até 2031 no mercado de HBM para comuta??o de rede e processamento de pacotes.
- Por geografia, a América do Norte detinha 44,68% de participa??o em 2025, enquanto a ?蝉颈补-笔补肠í蹿颈肠辞 est projetada para se expandir a um CAGR de 42,23% até 2031 no mercado de HBM para comuta??o de rede e processamento de pacotes.
Nota: O tamanho do mercado e os números de previs?o neste relatório s?o gerados usando a estrutura de estimativa proprietária da 黑料不打烊, atualizada com os dados e percep??es mais recentes disponíveis em janeiro de 2026.
Tendências e Insights de Mercado
Análise de Impacto dos Impulsionadores*
| Impulsionador | (~) % de Impacto na Previs?o de CAGR | Relev?ncia Geográfica | Prazo de Impacto |
|---|---|---|---|
| Crescentes Necessidades de Largura de Banda de Buffer de Pacotes e ASICs de Comutadores de IA | +12.5% | Global, concentrado em clusters hiperescaladores da América do Norte e ?蝉颈补-笔补肠í蹿颈肠辞 | Curto prazo (≤ 2 anos) |
| Ado??o de HBM Co-Empacotado em Plataformas de Comuta??o de Classe Terabit | +9.0% | Global, com embalagem centralizada em Taiwan | Médio prazo (2-4 anos) |
| Migra??o de Data Centers Hiperescaladores para Arquiteturas de Rede Limitadas por Memória | +8.0% | Núcleo da América do Norte e ?蝉颈补-笔补肠í蹿颈肠辞, com expans?o para a Europa | Curto prazo (≤ 2 anos) |
| Implanta??es de Ethernet 800G e 1,6T Aumentando as Necessidades de Profundidade de Buffer | +5.5% | Global, com implanta??es iniciais na América do Norte, depois Europa e ?蝉颈补-笔补肠í蹿颈肠辞 | Médio prazo (2-4 anos) |
| Ganhos de Eficiência Térmica e Energética com Integra??o de Memória Próxima ao Processamento | +4.0% | Global, com maior relev?ncia em data centers europeus e japoneses com restri??es de energia | Médio prazo (2-4 anos) |
| Redes de Borda Ricas em HBM para Processamento Determinístico de Pacotes em Telecomunica??es | +2.0% | ?蝉颈补-笔补肠í蹿颈肠辞 e Europa, com expans?o para o Oriente Médio e ?frica | Longo prazo (≥ 4 anos) |
| Fonte: 黑料不打烊 | |||
Crescentes Requisitos de Largura de Banda de Buffer de Pacotes e ASICs de Comutadores Otimizados para IA
? medida que os clusters de treinamento de IA ultrapassaram 100.000 aceleradores, o mercado de HBM para comuta??o de rede e processamento de pacotes foi impulsionado por um limite claro de largura de banda de memória que a SRAM convencional no chip n?o conseguia resolver por conta própria. Um artigo do IEEE de janeiro de 2026 sobre a arquitetura HBM-NS relatou 32,1% menos uso de energia e 55% menos latência do que as configura??es HBM sem comutador, apoiando o caso da comuta??o próxima à memória como uma op??o prática de design de rede. O artigo Themis apresentado no NSDI 2026 constatou que o gerenciamento de buffer híbrido baseado em HBM melhorou o desempenho de rede de ponta a ponta em até 2,8 vezes em velocidades de porta de 400 Gbps, fornecendo um forte argumento de desempenho para o mercado de comuta??o de rede e processamento de pacotes de HBM além de simples afirma??es de largura de banda. A press?o também aumenta mais rapidamente do que a velocidade de porta sozinha sugere, porque clusters de IA maiores criam eventos de congestionamento mais longos e rajadas de tráfego mais densas à medida que as redes passam de 400G para 800G e depois em dire??o a 1,6T. Esse padr?o está aumentando a demanda por pools de buffer mais profundos e ajudando configura??es de HBM de maior capacidade a ganhar terreno em todo o mercado de HBM para comuta??o de rede e processamento de pacotes.
Ado??o de HBM Co-Empacotado em Plataformas de Comuta??o de Rede de Classe Terabit
O mercado de HBM para comuta??o de rede e processamento de pacotes ganhou um modelo inicial de embalagem quando a Broadcom introduziu a primeira plataforma de comutador Ethernet com óptica co-empacotada de 51,2 Tbps em mar?o de 2024, com HBM, fot?nica de silício e lógica de comutador montados em um único pacote.[1]Broadcom Inc., "A Broadcom Entrega a Primeira Plataforma de Comutador Ethernet com ?ptica Co-Empacotada de 51,2 Tbps do Setor para Sistemas de IA Escaláveis," Rela??es com Investidores da Broadcom, investors.broadcom.com A Broadcom estendeu esse modelo em outubro de 2025 com o Tomahawk 6 Davisson a 102,4 Tbps, que dobrou a largura de banda dos designs anteriores de comutadores co-empacotados, mantendo o HBM no centro da arquitetura do sistema. A Marvell refor?ou essa dire??o em junho de 2026, quando lan?ou o Teralynx T100 de 102,4 Tbps com múltiplas op??es de embalagem para redes de data centers de IA e nuvem. Essa abordagem co-empacotada muda a unidade de compra dentro do mercado de HBM para comuta??o de rede e processamento de pacotes, pois os hiperescaladores avaliam cada vez mais um pacote combinado de HBM-ASIC em vez de componentes separados de memória e comutador. Os fornecedores que conseguem alinhar roteiros de memória, acesso a embalagens e cronogramas de silício de comutadores mais cedo est?o, portanto, em melhor posi??o para capturar os maiores ciclos de implanta??o.
Migra??o de Data Centers Hiperescaladores para Arquiteturas de Rede Limitadas por Memória
O mercado de HBM para comuta??o de rede e processamento de pacotes também está sendo moldado por um redesenho mais profundo nos data centers hiperescaladores, onde a malha de rede está sendo tratada mais como uma camada de memória distribuída do que como uma camada exclusivamente de transporte. O Google divulgou em 2026 que sua rede Virgo conectou 134.000 chips TPU em uma topologia plana de dois níveis sem bloqueio e entregou até 47 petabits por segundo de largura de banda bisseccional. Uma malha operando nessa escala precisa de buffers de comuta??o muito mais profundos e comportamento de latência mais estável em cargas de trabalho de treinamento, inferência e pré-processamento, o que fortalece o argumento de design para silício de comutador com suporte de HBM no mercado de HBM para comuta??o de rede e processamento de pacotes. A parceria da Broadcom de abril de 2026 com a Meta, que se estende até 2029, mostrou como os hiperescaladores est?o migrando para compromissos de infraestrutura de múltiplas gera??es que combinam chips de IA e plataformas de rede em um único framework de planejamento. O acordo de longo prazo da Broadcom com o Google até 2031 seguiu o mesmo padr?o, indicando que o mercado de HBM para comuta??o de rede e processamento de pacotes está cada vez mais vinculado a grandes compradores com longa visibilidade de fornecimento e controle de roteiro.
Implanta??es de Ethernet 800G e 1,6T Aumentando a Profundidade de Buffer e a Sensibilidade à Latência
O mercado de HBM para comuta??o de rede e processamento de pacotes está entrando em um ciclo de velocidade de porta mais rápido à medida que hiperescaladores e fornecedores de comutadores avan?am de 400G para sistemas 800G e se preparam para plataformas 1,6T. A Marvell afirmou em mar?o de 2026 que havia expandido seu portfólio de DSP óptico para a era 1,6T, indicando que a pilha óptica de suporte já estava avan?ando em dire??o à prontid?o comercial. A Arista seguiu em junho de 2026 com seu portfólio 7060XE7 para infraestrutura de IA em escala de rack, incluindo um sistema resfriado a ar de 64 portas 1,6T com previs?o de produ??o para o quarto trimestre de 2026. Velocidades de porta mais altas criam rajadas de pacotes mais densas e tornam os eventos de congestionamento curtos mais difíceis de absorver, o que aumenta o valor prático de buffers maiores com suporte de HBM no mercado de HBM para comuta??o de rede e processamento de pacotes. ? medida que os sistemas 1,6T se aproximam da implanta??o, o silício de comutador com buffer de HBM está se tornando uma expectativa de base em vez de uma op??o de design premium para o nível superior das malhas de IA.
Análise de Impacto das Restri??es*
| Restri??o | (~) % de Impacto na Previs?o de CAGR | Relev?ncia Geográfica | Prazo de Impacto |
|---|---|---|---|
| Capacidade Limitada de Embalagem Avan?ada para Integra??o de HBM em Alto Volume | -4.5% | Global, concentrado em Taiwan e principais parceiros OSAT | Curto prazo (≤ 2 anos) |
| Controles de Exporta??o e Restri??es de Qualifica??o em Nós Avan?ados de DRAM | -3.0% | Predominantemente China e entidades com empresas-m?e finais do Grupo D:5 globalmente | Médio prazo (2-4 anos) |
| Risco de Rendimento Crescente com Arquiteturas de HBM de Pilha Mais Alta | -2.0% | Global, concentrado na fabrica??o de HBM da Coreia do Sul | Curto prazo (≤ 2 anos) |
| Acoplamento Estreito a Roteiros de ASIC Personalizados Retardando a Ado??o Mais Ampla | -1.5% | Global, com efeito mais forte em redes corporativas e borda de telecomunica??es | Longo prazo (≥ 4 anos) |
| Fonte: 黑料不打烊 | |||
Capacidade Limitada de Embalagem Avan?ada para Integra??o de HBM em Alto Volume
O mercado de HBM para comuta??o de rede e processamento de pacotes ainda depende de capacidade de embalagem avan?ada que permanece mais restrita do que a demanda final, especialmente para designs que colocam HBM e lógica de comuta??o em um único pacote. As mais recentes plataformas Tomahawk e Jericho da Broadcom, juntamente com o Teralynx T100 da Marvell, apontam para uma dire??o de design que depende de embalagem sofisticada em vez de conex?o de memória independente. Isso cria concorrência direta pelo acesso a embalagens entre silício de rede e aceleradores de IA, dando aos maiores compradores e aos que reservam mais cedo uma vantagem óbvia no mercado de HBM para comuta??o de rede e processamento de pacotes. Os fornecedores de rede menores, portanto, enfrentam um caminho mais difícil para escalar, mesmo quando seus roteiros técnicos s?o sólidos e a demanda dos clientes está presente. O resultado é um ambiente de fornecimento em duas velocidades, no qual os principais hiperescaladores podem avan?ar mais rapidamente, enquanto os OEMs de segundo nível e os fornecedores orientados para empresas enfrentam um ritmo de expans?o mais lento.
Controles de Exporta??o e Restri??es de Qualifica??o em Nós Avan?ados de DRAM
Os controles de exporta??o est?o adicionando sobrecarga de qualifica??o ao mercado de HBM para comuta??o de rede e processamento de pacotes, especialmente para fornecedores que enviam sistemas avan?ados por várias jurisdi??es. Em maio de 2026, o Departamento de Indústria e Seguran?a confirmou que os requisitos de licen?a para itens de computa??o avan?ada continuavam a se aplicar a entidades com sede no Grupo de Países D:5 e Macau, sob as disposi??es relevantes de controle de exporta??o. Isso importa porque os roteiros atuais de comutadores e roteadores est?o vinculados a gera??es avan?adas de HBM em vez de nós de memória legados, portanto, a conformidade agora afeta o planejamento central do produto em vez de um caso marginal pequeno. Fornecedores e OEMs devem revisar usuários finais, rotas de remessa e propriedade de entidades com mais cuidado, o que adiciona custo e pode prolongar os ciclos de qualifica??o para destinos restritos. Esses atrasos n?o impedem o crescimento do mercado de HBM para comuta??o de rede e processamento de pacotes, mas retardam o cronograma de implanta??o e complicam a execu??o da cadeia de suprimentos para fornecedores globais.
*Nossas previs?es tratam os impactos dos impulsionadores e restri??es como direcionais, e n?o aditivos. As previs?es de impacto refletem o crescimento de base, os efeitos de composi??o e as intera??es entre variáveis.
Análise de Segmentos
Por Aplica??o:
ASICs de Comutadores Ethernet Lideram a Receita Enquanto os Comutadores de Malha de IA Crescem Mais RapidamenteOs ASICs de comutadores Ethernet detinham 43,13% da participa??o de mercado de HBM para comuta??o de rede e processamento de pacotes em 2025, enquanto os comutadores de malha de rede de IA est?o projetados para crescer a um CAGR de 42,03% de 2026 a 2031. Essa lideran?a de receita refletiu anos de implanta??o em ambientes Ethernet de folha-espinha hiperescaladores, onde a comuta??o de buffer profundo já havia se tornado um requisito prático para grandes cargas de tráfego leste-oeste. A Broadcom afirmou que o Jericho4 entregou 160 vezes a capacidade de buffer de pacotes da memória padr?o no chip, o que explica por que as plataformas Ethernet de buffer profundo permaneceram centrais para o design de rede de IA de alto desempenho em 2025 e 2026. Ao mesmo tempo, o mercado de HBM para comuta??o de rede e processamento de pacotes está sendo atraído para malhas de IA personalizadas, e a parceria da NVIDIA de mar?o de 2026 com a Marvell, respaldada por um investimento de 2 bilh?es de USD, vinculou mais estreitamente o gerenciamento avan?ado de pacotes e as redes de expans?o ao HBM.[2]NVIDIA Corporation, "NVIDIA e SK hynix Anunciam Parceria Tecnológica Plurianual para Avan?ar a Memória para Fábricas de IA," Rela??es com Investidores da NVIDIA, investor.nvidia.com
A próxima camada de demanda vem de dispositivos de interface e processamento de pacotes que ficam mais próximos do servidor, da borda da rede ou do plano de controle de telecomunica??es. A folha de dados do BCM88690 da Broadcom mostrou que o hardware de processamento de rede já usava dois cubos HBM Gen2 para um total de 8 GB de buffer de pacotes e suportava até 128.000 filas programáveis, o que manteve as NPUs relevantes para o tratamento determinístico de tráfego além das maiores malhas de IA. Isso importa para o setor de HBM em comuta??o de rede e processamento de pacotes porque mostra que a tecnologia n?o está limitada aos ASICs de comutadores de ponta e também pode suportar cargas de trabalho de processamento de pacotes com muitas filas e sensíveis à latência. Com o tempo, a demanda por aplica??es provavelmente continuará se expandindo do nível de comuta??o de maior desempenho para dispositivos adjacentes à medida que os rendimentos de memória melhoram, a economia por bit se torna mais fácil e o gerenciamento de tráfego com suporte de HBM se torna mais fácil de justificar em mais fun??es de rede.


Por Gera??o de HBM:
HBM3 Mantém a Base Enquanto o HBM4 Define o Próximo TetoO HBM3 comandava uma participa??o de 55,92% em 2025, dando-lhe a maior posi??o no tamanho do mercado de HBM para comuta??o de rede e processamento de pacotes por gera??o de HBM, enquanto o HBM4 está projetado para se expandir a um CAGR de 42,21% até 2031. O HBM3 construiu essa lideran?a porque a família StrataDNX Jericho da Broadcom e os sistemas da classe Tomahawk entraram em produ??o ao longo de 2024 e 2025, o que deu a essa gera??o a base comercial mais sólida nas plataformas de comuta??o implantadas. O HBM2 e o HBM2E permaneceram em plataformas legadas de buffer profundo, mas seu perfil de largura de banda por pino está se tornando menos adequado à medida que as redes avan?am para comuta??o acima de 400G. A documenta??o do BCM88480 da Broadcom ilustrou que os designs anteriores de HBM Gen2 ainda serviam a sistemas de roteadores instalados com 4 GB de memória de buffer no pacote, o que mostra por que as gera??es mais antigas n?o desapareceram imediatamente, mesmo com as mais novas ganhando participa??o.
O mercado de HBM para comuta??o de rede e processamento de pacotes está agora avan?ando em dire??o ao HBM3E e HBM4, pois o silício de comutador de próxima gera??o requer interfaces mais amplas e maior largura de banda por pilha. Pesquisas do Technion, UC Berkeley e UC San Diego mostraram que um design de roteador em pacote usando 4 pilhas de HBM4 poderia entregar 81,92 Tbps de largura de banda de comuta??o combinada, o que destacou a capacidade arquitetural da próxima gera??o de memória. A Samsung iniciou a produ??o em massa de HBM4 em fevereiro de 2026, e a NVIDIA e a SK Hynix formalizaram uma parceria tecnológica plurianual em junho de 2026 para avan?ar a memória de próxima gera??o para fábricas de IA, ambas melhorando a visibilidade em torno da futura base de fornecimento. Esses movimentos apoiam a vis?o de que o mercado de HBM para comuta??o de rede e processamento de pacotes continuará migrando para interfaces mais amplas de 2.048 bits e maior largura de banda por pilha à medida que a próxima onda de comuta??o chega à produ??o.
Por Capacidade de Memória por Pilha:
16 GB Ancorou a Base Enquanto 32 GB e Acima Ganha VelocidadeA configura??o de 16 GB capturou 47,32% do tamanho do mercado de HBM para comuta??o de rede e processamento de pacotes em 2025, enquanto as configura??es de 32 GB e acima est?o projetadas para crescer a um CAGR de 42,17% até 2031. Essa posi??o de 16 GB correspondeu às necessidades das plataformas de 25,6 Tbps a 51,2 Tbps, onde 2 a 4 pilhas eram suficientes para suportar buffer profundo sem elevar o custo do pacote além da toler?ncia hiperescaladora convencional. O nível de 8 GB ainda se encaixa em NPUs de telecomunica??es e comutadores de borda sensíveis ao custo, enquanto 24 GB surgiu como um passo intermediário prático entre a comuta??o de folha e as plataformas de roteamento de malha grande. O nível de 4 GB está perdendo relev?ncia porque os padr?es de tráfego de IA mais recentes podem consumir rapidamente pools de buffer rasos quando tanto as rajadas de pacotes quanto a dura??o do congestionamento aumentam.
No nível superior, 32 GB e acima está ganhando impulso porque os roteiros de HBM4 est?o avan?ando para 32 GB a 64 GB por pilha, e as malhas de IA maiores precisam de mais espa?o para absorver o congestionamento em racks e sites. A Micron afirmou que todo o seu fornecimento de HBM de 2026 estava comprometido sob acordos de pre?o e volume, indicando demanda muito forte por pilhas de alta capacidade em implanta??es de aceleradores e redes. A Samsung afirmou que sua receita de HBM de 2026 mais do que triplicaria em rela??o ao ano anterior com a expans?o do HBM4, apoiando maior disponibilidade futura de pilhas mais altas que podem se encaixar em casos de uso de rede e computa??o de ponta. Esse padr?o sugere que o mercado de HBM para comuta??o de rede e processamento de pacotes continuará migrando para pools de buffer maiores, pois as redes de IA distribuídas est?o tornando os eventos de congestionamento mais longos e complexos a norma, em vez da exce??o.
Por Setor do Usuário Final:
Data Centers em Nuvem Dominam os Gastos Enquanto as Redes de HPC Crescem Mais RapidamenteOs data centers em nuvem detinham 78,03% de participa??o em 2025, enquanto as redes de computa??o de alto desempenho est?o projetadas para se expandir a um CAGR de 42,09% até 2031, tornando-as o grupo de usuários finais de crescimento mais rápido no mercado de HBM para comuta??o de rede e processamento de pacotes. Os gastos em nuvem dominaram porque os maiores compradores já estavam construindo clusters com contagens muito altas de aceleradores, e esses ambientes dependiam cada vez mais de malhas Ethernet 800G e comutadores de buffer profundo para manter desempenho estável sob cargas de trabalho mistas de IA. O mercado de HBM para comuta??o de rede e processamento de pacotes, portanto, permaneceu estreitamente vinculado aos ciclos de capital hiperescaladores, onde escala, disponibilidade e certeza de roteiro importam tanto quanto o desempenho bruto do silício. Esse equilíbrio explica por que a demanda em nuvem liderou a receita mesmo enquanto alguns dos requisitos técnicos mais rigorosos vinham de ambientes de pesquisa e computa??o nacional menores, mas mais exigentes.
Os programas de HPC apoiados pelo governo foram um forte sinal de crescimento porque a Administra??o Nacional de Seguran?a Nuclear concedeu 18 milh?es de USD à Cornelis Networks em 2025 para trabalhos de rede de alto desempenho de próxima gera??o. A Cornelis também anunciou a implanta??o do CN5000 para o ambiente da NNSA no Laboratório Nacional Lawrence Livermore, demonstrando que o desempenho determinístico de interconex?o de alta velocidade estava avan?ando para aquisi??es reais em vez de permanecer um conceito de laboratório. Os operadores de telecomunica??es formaram um segundo fluxo de demanda à medida que as implanta??es de núcleo aut?nomo 5G continuaram a depender de processadores de pacotes com controle rico de filas e comportamento de latência determinístico, enquanto a demanda corporativa e de defesa governamental permaneceu menor, mas estável. Essa combina??o significa que os compradores em nuvem provavelmente permanecer?o a principal fonte de volume, enquanto o HPC continuará a influenciar os requisitos de design mais avan?ados dentro do mercado de HBM para comuta??o de rede e processamento de pacotes.
Análise Geográfica
Mercado de HBM para Comuta??o de Rede e Processamento de Pacotes na América do Norte
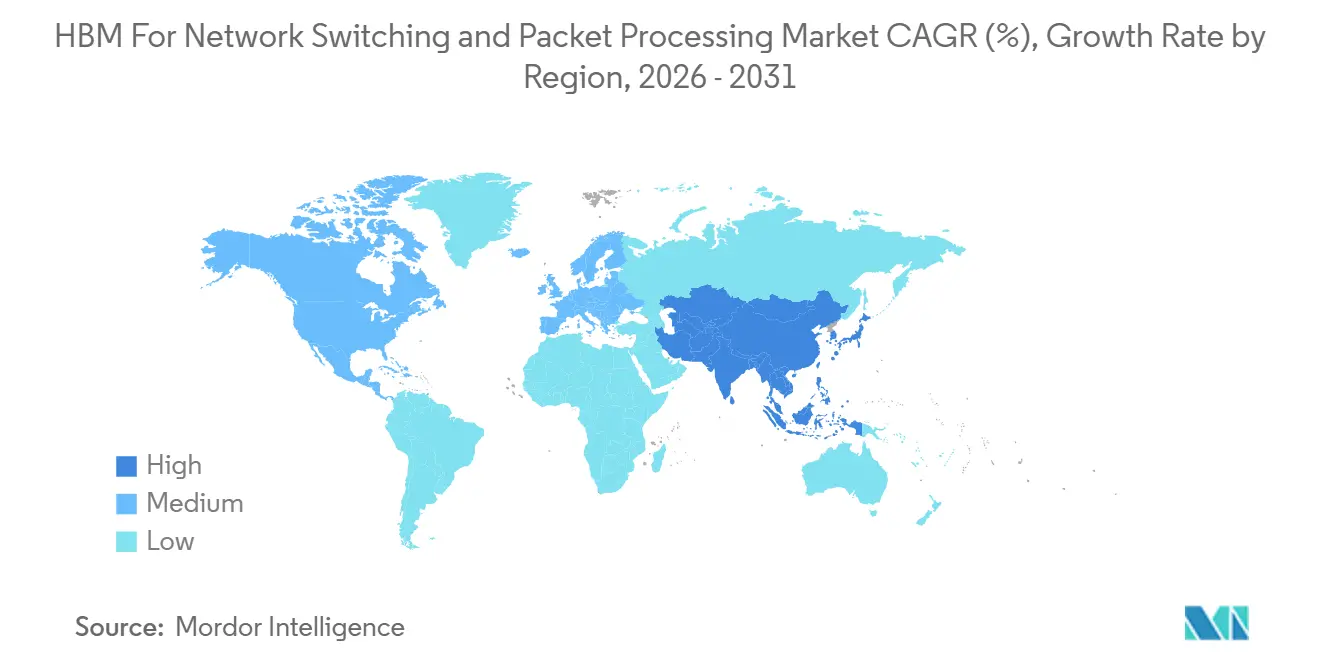
A América do Norte detinha 44,68% da participa??o no mercado de HBM para comuta??o de rede e processamento de pacotes em 2025. A regi?o liderou porque os Estados Unidos abrigavam os maiores compradores de hiperescala de silício avan?ado para comutadores e foram os primeiros a adotar plataformas de rede de alto desempenho com suporte de HBM em escala. O Google divulgou em 2026 que sua rede Virgo conectava 134.000 chips TPU em um design plano e sem bloqueio, entregando até 47 petabits por segundo de largura de banda bidirecional, refletindo a escala da infraestrutura que os operadores norte-americanos já estavam planejando e implantando.[3]Google Cloud, "Apresentando o Tecido de Data Center em Megaescala da Rede Virgo," Blog do Google Cloud, cloud.google.com Esse tipo de implanta??o favorece comutadores com largura de banda de memória e armazenamento em buffer de pacotes muito mais profundos do que os designs convencionais podem oferecer, o que mantém o mercado de HBM para comuta??o de rede e processamento de pacotes estreitamente alinhado ao ciclo de gastos de hiperescala da regi?o. A demanda governamental também sustentou a base regional após a NNSA apoiar trabalhos de rede de próxima gera??o com a Cornelis Networks para programas nacionais de computa??o.
Mercado de HBM para Comuta??o de Rede e Processamento de Pacotes na Europa e em Taiwan
A Europa contribuiu com uma participa??o significativa em 2025, com Alemanha, Reino Unido, Fran?a e países nórdicos abrigando grandes campi de nuvem e implanta??es de rede de alta capacidade. A regi?o também se beneficiou das atualiza??es do núcleo aut?nomo de 5G, que sustentaram o interesse contínuo em processadores de pacotes e sistemas de roteamento com subsistemas de memória mais robustos. Os programas nacionais de inteligência artificial no Reino Unido e na Alemanha est?o ajudando a sustentar o investimento futuro em data centers, o que deverá apoiar a ado??o gradual de silício avan?ado para comuta??o ao longo do período de previs?o. A Europa também tem interesse estratégico em reduzir a dependência de longo prazo de capacidades de semicondutores e empacotamento, embora Taiwan permane?a o principal hub de empacotamento de HBM no mercado de comuta??o de rede e processamento de pacotes atualmente.
Mercado de HBM para Comuta??o de Rede e Processamento de Pacotes na América do Sul, APAC e MEA
A ?蝉颈补-笔补肠í蹿颈肠辞 deve crescer a um CAGR de 42,23% até 2031, tornando-se a regi?o de crescimento mais rápido no mercado de HBM para comuta??o de rede e processamento de pacotes. A Coreia do Sul está no centro da oferta porque a SK hynix registrou resultados recordes no exercício fiscal de 2025, e a NVIDIA firmou uma parceria tecnológica plurianual com a SK hynix em junho de 2026 para memória de próxima gera??o utilizada em infraestrutura de inteligência artificial. Taiwan permanece indispensável porque as plataformas de comuta??o mais avan?adas com foco em inteligência artificial da Broadcom e da Marvell dependem de caminhos de montagem intensivos em empacotamento profundamente vinculados ao ecossistema de semicondutores da ilha. A ?ndia e o Sudeste Asiático est?o em estágios mais iniciais de ado??o, mas o investimento doméstico em nuvem está come?ando a criar demanda futura por plataformas de comuta??o integradas com HBM. A América do Sul, o Oriente Médio e a ?frica permanecem oportunidades de horizonte mais longo, onde a moderniza??o empresarial e as atualiza??es de redes governamentais s?o os principais impulsionadores de curto prazo, mais relevantes do que grandes implanta??es de malha de inteligência artificial.

Cenário Competitivo
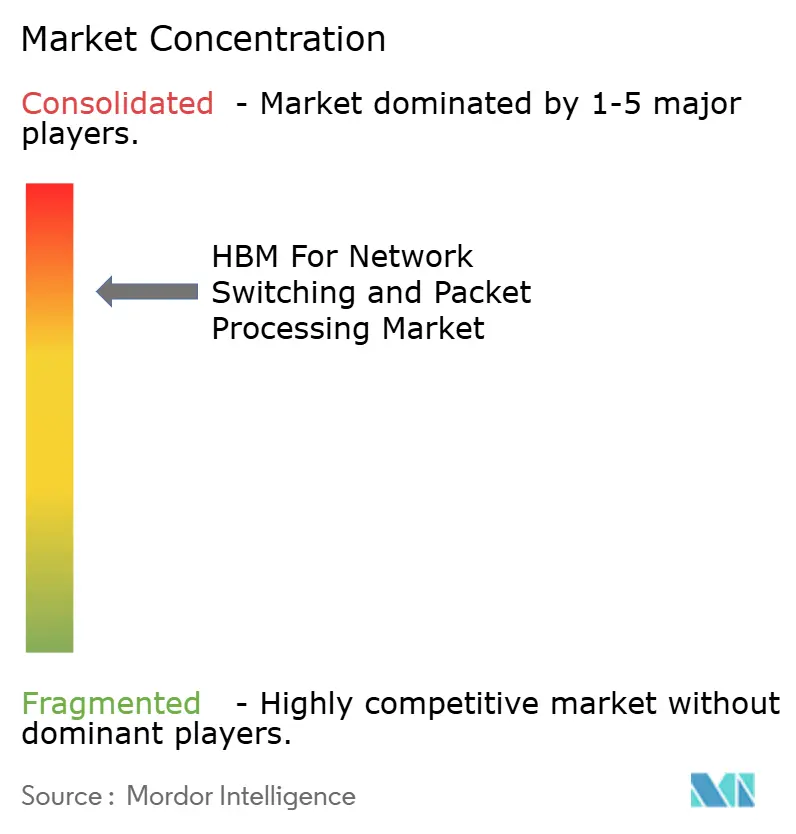
O mercado de HBM para comuta??o de rede e processamento de pacotes permaneceu concentrado na camada de fornecimento de memória, com Samsung, SK Hynix e Micron respondendo pela disponibilidade comercial de HBM nas gera??es atuais. A concorrência foi mais ampla na camada de ASIC de comutador, onde Broadcom, Marvell, Cisco e NVIDIA seguiram abordagens diferentes para buffers, óptica, malhas de expans?o e parcerias em nível de sistema. A Broadcom refor?ou sua posi??o quando come?ou a enviar o Tomahawk 6 em volume de produ??o em mar?o de 2026, após enviar o Jericho4 em agosto de 2025 para casos de uso de computa??o de IA distribuída. Ela também garantiu demanda de longo horizonte por meio de um acordo de garantia de fornecimento de rede com o Google até 2031 e uma parceria expandida com a Meta até 2029, o que reduziu a incerteza em torno de futuros ganhos de design e planejamento de fornecimento. A Marvell respondeu lan?ando o Teralynx T100 em junho de 2026 e vinculando seu roteiro mais estreitamente à NVIDIA por meio da parceria NVLink Fusion de mar?o de 2026, o que lhe deu uma rota protegida para os programas de rede de fábricas de IA.
O mercado de HBM para comuta??o de rede e processamento de pacotes ainda tem espa?o para crescer em borda de telecomunica??es e redes corporativas, onde menos fornecedores oferecem hardware de processamento de pacotes integrado com HBM adaptado para gerenciamento determinístico de tráfego. Outra possível mudan?a é o surgimento da desagrega??o de memória por meio de CXL, que poderia mudar como os sistemas futuros equilibram o buffer local de pacotes e o acesso à memória compartilhada. O lan?amento pela Marvell em mar?o de 2026 do comutador CXL Structera S 30260 mostrou que o agrupamento de memória em nível de rack estava passando do conceito para o silício comercial. Se essa abordagem escalar, alguns níveis sensíveis ao custo podem depender menos de HBM totalmente co-empacotado e mais de malhas de memória compartilhada em torno do sistema de comutador.
No lado da memória, as rela??es com fornecedores est?o se tornando mais estratégicas do que transacionais no mercado de HBM para comuta??o de rede e processamento de pacotes. A NVIDIA e a SK hynix formalizaram uma parceria tecnológica plurianual em junho de 2026, enquanto a Micron afirmou que seu fornecimento de HBM de 2026 estava totalmente comprometido sob acordos de pre?o e volume, ambos sinalizando que a disponibilidade futura está cada vez mais vinculada a compromissos comerciais de longo prazo.[4]NVIDIA Corporation, "O Ecossistema de IA da NVIDIA se Expande com a Marvell Unindo For?as por Meio do NVLink Fusion," Rela??es com Investidores da NVIDIA, investor.nvidia.com A Samsung também iniciou a produ??o em massa de HBM4 em 2026, o que indicou que a próxima gera??o de pilhas estava passando da discuss?o de roteiro para a produ??o real. Esses movimentos estratégicos elevam a barreira de entrada, porque novos desafiantes devem corresponder n?o apenas ao desempenho do chip, mas também ao acesso avan?ado à memória, prontid?o de embalagem e garantia de fornecimento plurianual. Essa combina??o mantém o mercado de HBM para comuta??o de rede e processamento de pacotes concentrado no fornecimento, ao mesmo tempo que ainda permite concorrência ativa pelos maiores ganhos de design de sistemas.
Líderes do Setor de HBM para Comuta??o de Rede e Processamento de Pacotes
-
SK hynix Inc.
-
Samsung Electronics Co., Ltd.
-
Micron Technology, Inc.
- *Isen??o de responsabilidade: Principais participantes classificados em nenhuma ordem específica
Mercado de HBM para Comuta??o de Rede e Processamento de Pacotes
- SK hynix Inc.
- Samsung Electronics Co., Ltd.
- Micron Technology, Inc.

Recent Industry Developments in Mercado de HBM para Comuta??o de Rede e Processamento de Pacotes
- Junho de 2026: A NVIDIA e a SK hynix anunciaram uma parceria tecnológica plurianual para avan?ar a memória de próxima gera??o para a constru??o global de fábricas de IA, cobrindo o fornecimento de memória avan?ada e a colabora??o de design de semicondutores de próxima gera??o alinhada ao roteiro de infraestrutura de IA da NVIDIA. O acordo formaliza o que anteriormente era um profundo relacionamento de co-engenharia em um compromisso contratual de fornecimento e desenvolvimento.
- Junho de 2026: A Marvell Technology lan?ou o Teralynx T100, o primeiro silício de comutador de 102,4 Tbps do setor construído especificamente para redes da era de IA, fabricado em um nó de processo de 3 nm com múltiplas configura??es de embalagem, matriz de grade de esferas, cobre co-empacotado e óptica co-empacotada, e em amostragem para clientes. O T100 compete diretamente com o Tomahawk 6 da Broadcom, desafiando a estimada participa??o de mercado de 80% da Broadcom no nível de maior largura de banda dos ASICs de comuta??o Ethernet.
- Abril de 2026: A Broadcom firmou uma parceria estratégica plurianual e de múltiplas gera??es com a Meta para fornecer tecnologia de chips e redes que suporta os chips Aceleradores de Treinamento e Inferência da Meta até 2029, com as interconex?es em escala de rack baseadas em Ethernet da Broadcom formando o backbone da rede do data center de IA e abordando hierarquias de memória em evolu??o.
- Abril de 2026: A Broadcom e o Google assinaram um acordo de longo prazo para a Broadcom desenvolver e fornecer unidades de processamento tensorial personalizadas e um acordo de garantia de fornecimento para componentes de rede e outros para os racks de IA de próxima gera??o do Google até 2031, um contrato que compromete os roteiros de silício de comutador integrado com HBM em volumes hiperescaladores ao longo de um prazo de múltiplas gera??es.


Escopo do Relatório Global do Mercado de HBM para Comuta??o de Rede e Processamento de Pacotes
O Mercado de HBM para Comuta??o de Rede e Processamento de Pacotes é Segmentado por Aplica??o (ASICs de Comutadores Ethernet, Unidades de Processamento de Dados (DPUs), SmartNICs, Unidades de Processamento de Rede (NPUs) e Comutadores de Malha de Rede de IA), Gera??o de HBM (HBM2, HBM2E, HBM3, HBM3E e HBM4), Capacidade de Memória por Pilha (4 GB, 8 GB, 16 GB, 24 GB e 32 GB e Acima), Setor do Usuário Final (Data Centers em Nuvem, Telecomunica??es, Redes Corporativas, Governo e Defesa e Redes de Computa??o de Alto Desempenho) e Geografia (América do Norte, Europa, ?蝉颈补-笔补肠í蹿颈肠辞, América do Sul e Oriente Médio e ?frica). As Previs?es de Mercado s?o Fornecidas em Termos de Valor (USD).
| ASICs de Comutadores Ethernet |
| Unidades de Processamento de Dados (DPUs) |
| SmartNICs |
| Unidades de Processamento de Rede (NPUs) |
| Comutadores de Malha de Rede de IA |
| HBM2 |
| HBM2E |
| HBM3 |
| HBM3E |
| HBM4 |
| 4 GB |
| 8 GB |
| 16 GB |
| 24 GB |
| 32 GB e Acima |
| Data Centers em Nuvem |
| Telecomunica??es |
| Redes Corporativas |
| Governo e Defesa |
| Redes de Computa??o de Alto Desempenho |
| América do Norte | Estados Unidos |
| 颁补苍补诲á | |
| 惭é虫颈肠辞 | |
| Europa | Alemanha |
| Reino Unido | |
| Fran?a | |
| 滨迟á濒颈补 | |
| Restante da Europa | |
| ?蝉颈补-笔补肠í蹿颈肠辞 | China |
| Jap?o | |
| Coreia do Sul | |
| Taiwan | |
| ?ndia | |
| Restante da ?蝉颈补-笔补肠í蹿颈肠辞 | |
| América do Sul | |
| Oriente Médio e ?frica |
| Por Aplica??o | ASICs de Comutadores Ethernet | |
| Unidades de Processamento de Dados (DPUs) | ||
| SmartNICs | ||
| Unidades de Processamento de Rede (NPUs) | ||
| Comutadores de Malha de Rede de IA | ||
| Por Gera??o de HBM | HBM2 | |
| HBM2E | ||
| HBM3 | ||
| HBM3E | ||
| HBM4 | ||
| Por Capacidade de Memória por Pilha | 4 GB | |
| 8 GB | ||
| 16 GB | ||
| 24 GB | ||
| 32 GB e Acima | ||
| Por Setor do Usuário Final | Data Centers em Nuvem | |
| Telecomunica??es | ||
| Redes Corporativas | ||
| Governo e Defesa | ||
| Redes de Computa??o de Alto Desempenho | ||
| Por Geografia | América do Norte | Estados Unidos |
| 颁补苍补诲á | ||
| 惭é虫颈肠辞 | ||
| Europa | Alemanha | |
| Reino Unido | ||
| Fran?a | ||
| 滨迟á濒颈补 | ||
| Restante da Europa | ||
| ?蝉颈补-笔补肠í蹿颈肠辞 | China | |
| Jap?o | ||
| Coreia do Sul | ||
| Taiwan | ||
| ?ndia | ||
| Restante da ?蝉颈补-笔补肠í蹿颈肠辞 | ||
| América do Sul | ||
| Oriente Médio e ?frica | ||


Principais Perguntas Respondidas no Relatório
Qual é o tamanho atual e previsto do espa?o de HBM para comuta??o de rede e processamento de pacotes?
Espera-se que o tamanho do mercado de HBM para comuta??o de rede e processamento de pacotes aumente de 0,15 bilh?es de USD em 2025 para 0,21 bilh?es de USD em 2026 e atinja 1,18 bilh?es de USD até 2031, a um CAGR de 41,23%.
Qual aplica??o lidera a receita hoje?
Os ASICs de comutadores Ethernet lideraram a receita com uma participa??o de 43,13% em 2025 porque já tinham uma ampla base instalada em malhas Ethernet hiperescaladoras.
Qual gera??o de HBM está crescendo mais rapidamente?
O HBM4 é o segmento de gera??o de HBM de crescimento mais rápido, com um CAGR projetado de 42,21% até 2031, à medida que o silício de comutador de próxima gera??o avan?a para interfaces mais amplas e maior largura de banda por pilha.
Por que os data centers em nuvem s?o os principais compradores?
Os data centers em nuvem representaram 78,03% da demanda em 2025 porque os hiperescaladores foram os primeiros a construir clusters de IA muito grandes que precisavam de plataformas de comuta??o de buffer profundo e baixa latência.
Qual regi?o apresenta a perspectiva de crescimento mais forte?
A ?蝉颈补-笔补肠í蹿颈肠辞 está projetada para crescer a um CAGR de 42,23% até 2031, apoiada pela base de fornecimento de HBM da Coreia do Sul e pelo papel de Taiwan na embalagem avan?ada de semicondutores.
Qual é o maior desafio do lado do fornecimento para os fornecedores?
A embalagem avan?ada permanece a principal restri??o de curto prazo porque os designs de comutadores integrados com HBM competem com os aceleradores de IA pela mesma capacidade de fabrica??o intensiva em embalagem.
Página atualizada pela última vez em:



