
Tama?o y 笔补谤迟颈肠颈辫补肠颈ó苍 del Mercado de HBM para Conmutación de Red y Procesamiento de Paquetes
Visión General del Mercado
| Período de Estudio | 2020 - 2031 |
|---|---|
| Tama?o del Mercado (2026) | 0.21 Mil millones de dólares |
| Tama?o del Mercado (2031) | 1.18 Mil millones de dólares |
| Growth Rate (2026 - 2031) | 41.23 % |
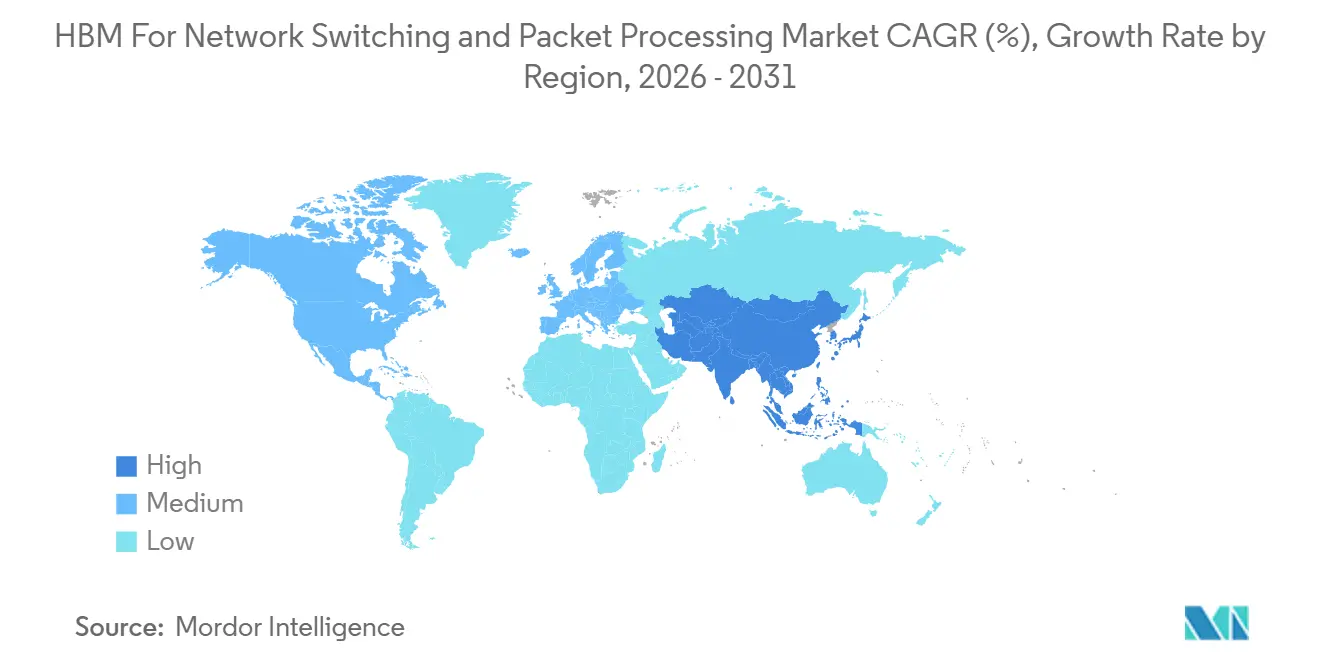
| Mercado de Crecimiento Más Rápido | 础蝉颈补-笔补肠í蹿颈肠辞 |
| Mercado Más Grande | América del Norte |
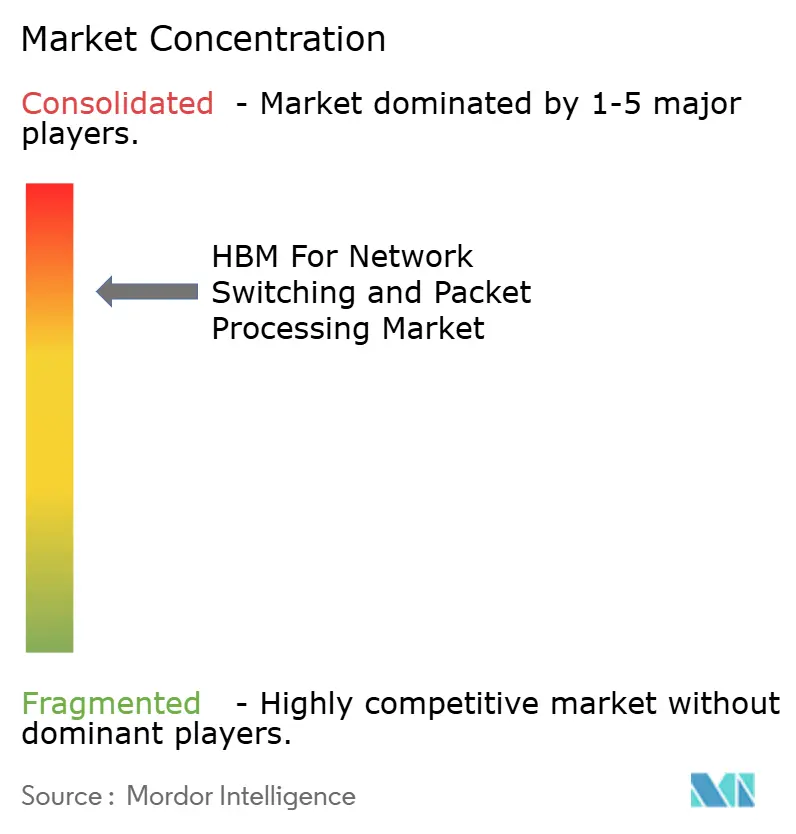
| Concentración del Mercado | Alto |
Jugadores principales
*Nota aclaratoria: los principales jugadores no se ordenaron de un modo en especial Imagen ? 黑料不打烊. El uso requiere atribución según CC BY 4.0. |
|
Análisis del Mercado de HBM para Conmutación de Red y Procesamiento de Paquetes por 黑料不打烊
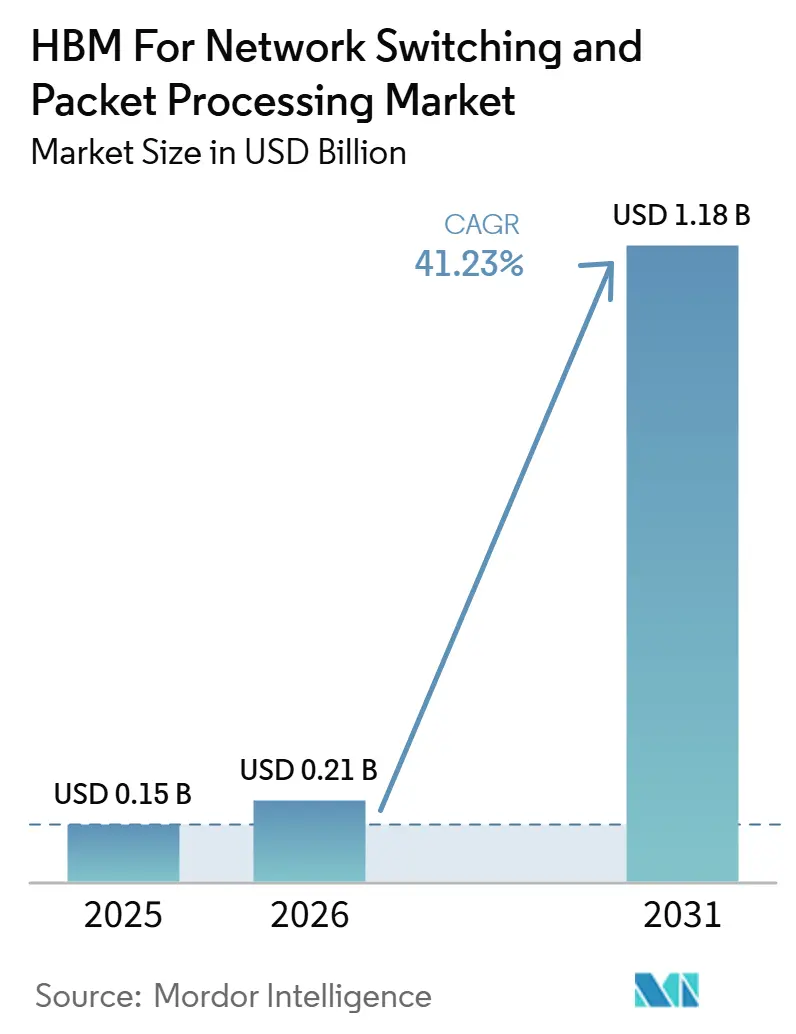
Se espera que el mercado de HBM para conmutación de red y procesamiento de paquetes aumente de 0,15 mil millones de USD en 2025 a 0,21 mil millones de USD en 2026, y alcance 1,18 mil millones de USD en 2031, creciendo a una CAGR del 41,23% durante 2026-2031. El mercado está siendo impulsado por el gasto sostenido en infraestructura de IA, ya que los clústeres de entrenamiento de gran escala están llevando a los dispositivos de red hacia un modelo de dise?o limitado por la memoria en lugar de un modelo de rendimiento simple. El cambio del almacenamiento en búfer de paquetes convencional basado en DDR al HBM apilado en 3D dentro de los ASICs de conmutadores está cambiando la forma en que los proveedores dise?an plataformas para tráfico de clase terabit, baja latencia y eficiencia energética. Los envíos de producción de silicio de conmutadores de 102,4 Tbps en 2026 demostraron que esta transición había superado el muestreo inicial y había entrado en la implementación comercial. Los acuerdos plurianuales entre los hiperescaladores y los proveedores de silicio están mejorando la visibilidad de la demanda a largo plazo y otorgando a los compradores más grandes un mayor control sobre el acceso al suministro. Las limitaciones de empaquetado avanzado y los requisitos de cumplimiento de exportación aún crean un acceso desigual para los compradores, favoreciendo a los operadores de nube más grandes y elevando el listón para los proveedores de redes más peque?os.
Conclusiones Clave del Informe
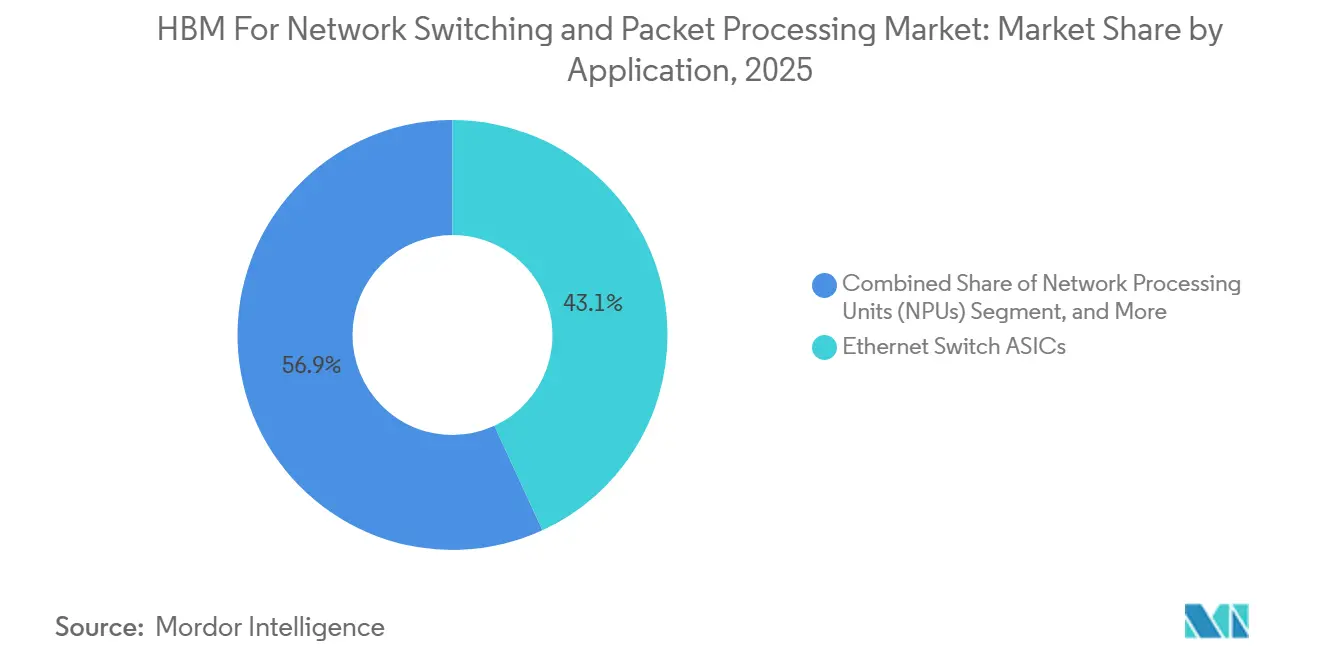
- Por aplicación, los ASICs de conmutadores Ethernet mantuvieron una participación de ingresos del 43,13% en 2025, mientras que se proyecta que los conmutadores de tejido de red de IA se expandan a una CAGR del 42,03% hasta 2031 en el mercado de HBM para conmutación de red y procesamiento de paquetes.
- Por generación de HBM, HBM3 tuvo una participación del 55,92% en 2025, mientras que se proyecta que HBM4 crezca a una CAGR del 42,21% hasta 2031 en el mercado de HBM para conmutación de red y procesamiento de paquetes.
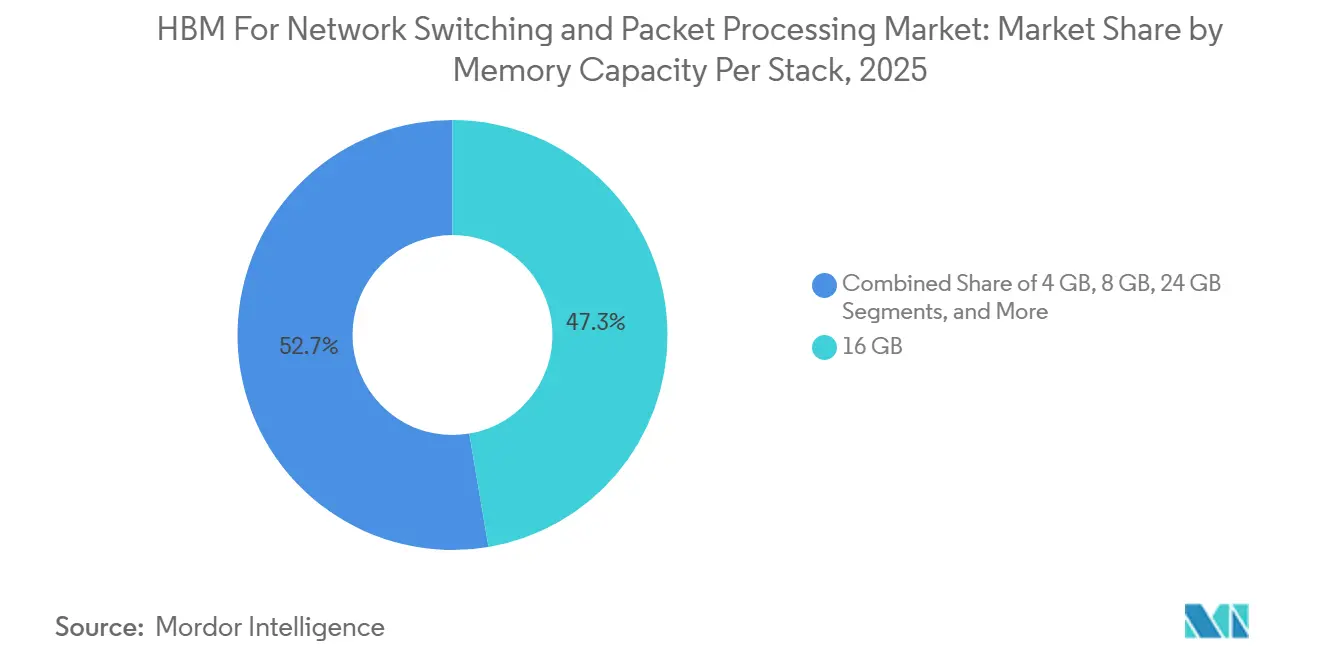
- Por capacidad de memoria por pila, 16 GB capturó una participación del 47,32% en 2025, mientras que se proyecta que 32 GB y más avance a una CAGR del 42,17% hasta 2031 en el mercado de HBM para conmutación de red y procesamiento de paquetes.
- Por industria de usuario final, los centros de datos en la nube representaron el 78,03% de la demanda en 2025, mientras que se proyecta que las redes de computación de alto rendimiento crezcan a una CAGR del 42,09% hasta 2031 en el mercado de HBM para conmutación de red y procesamiento de paquetes.
- Por geografía, América del Norte mantuvo una participación del 44,68% en 2025, mientras que se proyecta que 础蝉颈补-笔补肠í蹿颈肠辞 se expanda a una CAGR del 42,23% hasta 2031 en el mercado de HBM para conmutación de red y procesamiento de paquetes.
Nota: Las cifras del tama?o del mercado y los pronósticos de este informe se generan utilizando el marco de estimación patentado de 黑料不打烊, actualizado con los datos y conocimientos más recientes disponibles a partir de enero de 2026.
Tendencias e Información del Mercado
Análisis del Impacto de los Impulsores*
| Impulsor | (~) % de Impacto en el Pronóstico de CAGR | Relevancia Geográfica | Horizonte Temporal del Impacto |
|---|---|---|---|
| Crecientes Necesidades de Ancho de Banda de Búfer de Paquetes y ASIC de Conmutadores de IA | +12.5% | Global, concentrado en clústeres hiperescaladores de América del Norte y 础蝉颈补-笔补肠í蹿颈肠辞 | Corto plazo (≤ 2 a?os) |
| Adopción de HBM Co-Empaquetado en Plataformas de Conmutación de Clase Terabit | +9.0% | Global, con empaquetado centrado en 罢补颈飞á苍 | Mediano plazo (2-4 a?os) |
| Migración de Centros de Datos Hiperescaladores hacia Arquitecturas de Red Limitadas por Memoria | +8.0% | Núcleo de América del Norte y 础蝉颈补-笔补肠í蹿颈肠辞, con expansión a Europa | Corto plazo (≤ 2 a?os) |
| Implementaciones de Ethernet 800G y 1,6T que Aumentan las Necesidades de Profundidad de Búfer | +5.5% | Global, con implementaciones tempranas en América del Norte, luego Europa y 础蝉颈补-笔补肠í蹿颈肠辞 | Mediano plazo (2-4 a?os) |
| Ganancias de Eficiencia Térmica y Energética por la Integración de Memoria Cercana al Cómputo | +4.0% | Global, con mayor relevancia en centros de datos europeos y japoneses con restricciones de energía | Mediano plazo (2-4 a?os) |
| Redes de Borde Enriquecidas con HBM para Procesamiento Determinístico de Paquetes en Telecomunicaciones | +2.0% | 础蝉颈补-笔补肠í蹿颈肠辞 y Europa, con expansión a Oriente Medio y ?frica | Largo plazo (≥ 4 a?os) |
| Fuente: 黑料不打烊 | |||
Crecientes Requisitos de Ancho de Banda de Búfer de Paquetes y ASIC de Conmutadores Optimizados para IA
A medida que los clústeres de entrenamiento de IA superaron los 100.000 aceleradores, el mercado de HBM para conmutación de red y procesamiento de paquetes fue impulsado por un límite claro de ancho de banda de memoria que la SRAM en chip convencional no podía abordar por sí sola. Un artículo del IEEE de enero de 2026 sobre la arquitectura HBM-NS reportó un uso de energía un 32,1% menor y una latencia un 55% menor que las configuraciones HBM sin conmutador, respaldando el caso de la conmutación cercana a la memoria como una opción práctica de dise?o de red. El artículo Themis presentado en NSDI 2026 encontró que la gestión de búfer híbrido basada en HBM mejoró el rendimiento de red de extremo a extremo hasta 2,8 veces a velocidades de puerto de 400 Gbps, proporcionando un sólido argumento de rendimiento para el mercado de conmutación de red y procesamiento de paquetes con HBM más allá de las simples afirmaciones de ancho de banda. La presión también aumenta más rápido de lo que sugiere la velocidad de puerto por sí sola, porque los clústeres de IA más grandes crean eventos de congestión más prolongados y ráfagas de tráfico más densas a medida que las redes pasan de 400G a 800G y luego hacia 1,6T. Ese patrón está aumentando la demanda de grupos de búfer más profundos y ayudando a que las configuraciones de HBM de mayor capacidad ganen terreno en el mercado de HBM para conmutación de red y procesamiento de paquetes.
Adopción de HBM Co-Empaquetado en Plataformas de Conmutación de Red de Clase Terabit
El mercado de HBM para conmutación de red y procesamiento de paquetes obtuvo un primer modelo de empaquetado cuando Broadcom introdujo la primera plataforma de conmutadores Ethernet con óptica co-empaquetada de 51,2 Tbps en marzo de 2024, con HBM, fotónica de silicio y lógica de conmutación ensamblados en un solo paquete.[1]Broadcom Inc., "Broadcom Delivers Industry's First 51.2-Tbps Co-Packaged Optics Ethernet Switch Platform for Scalable AI Systems," Broadcom Investor Relations, investors.broadcom.com Broadcom amplió ese modelo en octubre de 2025 con el Tomahawk 6 Davisson a 102,4 Tbps, que duplicó el ancho de banda de los dise?os de conmutadores co-empaquetados anteriores mientras mantenía el HBM en el centro de la arquitectura del sistema. Marvell reforzó esta dirección en junio de 2026, cuando lanzó el Teralynx T100 de 102,4 Tbps con múltiples opciones de empaquetado para redes de centros de datos de IA y nube. Este enfoque co-empaquetado cambia la unidad de compra dentro del mercado de HBM para conmutación de red y procesamiento de paquetes, ya que los hiperescaladores evalúan cada vez más un paquete combinado de HBM-ASIC en lugar de componentes de memoria y conmutador separados. Los proveedores que pueden alinear antes las hojas de ruta de memoria, el acceso al empaquetado y los calendarios de silicio de conmutadores están, por tanto, en una mejor posición para capturar los ciclos de implementación más grandes.
Migración de Centros de Datos Hiperescaladores hacia Arquitecturas de Red Limitadas por Memoria
El mercado de HBM para conmutación de red y procesamiento de paquetes también está siendo moldeado por un redise?o más profundo en los centros de datos hiperescaladores, donde el tejido de red se está tratando más como una capa de memoria distribuida que como una capa exclusivamente de transporte. Google reveló en 2026 que su red Virgo conectaba 134.000 chips TPU en una topología plana de dos capas sin bloqueo y entregaba hasta 47 petabits por segundo de ancho de banda biseccional. Un tejido que opera a esa escala necesita búferes de conmutación mucho más profundos y un comportamiento de latencia más estable en cargas de trabajo de entrenamiento, inferencia y preprocesamiento, lo que refuerza el argumento de dise?o para el silicio de conmutadores respaldado por HBM en el mercado de HBM para conmutación de red y procesamiento de paquetes. La asociación de Broadcom de abril de 2026 con Meta, que se extiende hasta 2029, mostró cómo los hiperescaladores están avanzando hacia compromisos de infraestructura multigeneracionales que combinan chips de IA y plataformas de red bajo un mismo marco de planificación. El acuerdo a largo plazo de Broadcom con Google hasta 2031 siguió el mismo patrón, lo que indica que el mercado de HBM para conmutación de red y procesamiento de paquetes está cada vez más vinculado a grandes compradores con amplia visibilidad de suministro y control de hoja de ruta.
Implementaciones de Ethernet 800G y 1,6T que Aumentan la Profundidad de Búfer y la Sensibilidad a la Latencia
El mercado de HBM para conmutación de red y procesamiento de paquetes está entrando en un ciclo de velocidad de puerto más rápido a medida que los hiperescaladores y los proveedores de conmutadores avanzan de sistemas 400G a 800G y se preparan para plataformas 1,6T. Marvell se?aló en marzo de 2026 que había ampliado su cartera de DSP ópticos para la era 1,6T, lo que indica que la pila óptica de soporte ya se estaba moviendo hacia la preparación comercial. Arista siguió en junio de 2026 con su cartera 7060XE7 para infraestructura de IA a escala de bastidor, incluido un sistema de 64 puertos 1,6T refrigerado por aire con objetivo de producción para el cuarto trimestre de 2026. Las velocidades de puerto más altas crean ráfagas de paquetes más densas y hacen que los eventos de congestión breves sean más difíciles de absorber, lo que aumenta el valor práctico de los búferes más grandes respaldados por HBM en el mercado de HBM para conmutación de red y procesamiento de paquetes. A medida que los sistemas 1,6T se acercan a la implementación, el silicio de conmutadores con búfer de HBM se está convirtiendo en una expectativa de referencia en lugar de una opción de dise?o premium para el nivel superior de tejidos de IA.
Análisis del Impacto de las Restricciones*
| 搁别蝉迟谤颈肠肠颈ó苍 | (~) % de Impacto en el Pronóstico de CAGR | Relevancia Geográfica | Horizonte Temporal del Impacto |
|---|---|---|---|
| Capacidad Limitada de Empaquetado Avanzado para la Integración de HBM en Alto Volumen | -4.5% | Global, concentrado en 罢补颈飞á苍 y los principales socios OSAT | Corto plazo (≤ 2 a?os) |
| Controles de Exportación y Restricciones de Calificación en Nodos DRAM Avanzados | -3.0% | Predominantemente China y entidades con empresas matrices finales del Grupo D:5 a nivel global | Mediano plazo (2-4 a?os) |
| Riesgo de Rendimiento Creciente con Arquitecturas HBM de Mayor Número de Pilas | -2.0% | Global, concentrado en la fabricación de HBM de Corea del Sur | Corto plazo (≤ 2 a?os) |
| Acoplamiento Estrecho a Hojas de Ruta de ASIC Personalizados que Ralentiza la Adopción Más Amplia | -1.5% | Global, con mayor efecto en redes empresariales y borde de telecomunicaciones | Largo plazo (≥ 4 a?os) |
| Fuente: 黑料不打烊 | |||
Capacidad Limitada de Empaquetado Avanzado para la Integración de HBM en Alto Volumen
El mercado de HBM para conmutación de red y procesamiento de paquetes aún depende de la capacidad de empaquetado avanzado que sigue siendo más ajustada que la demanda final, especialmente para dise?os que colocan el HBM y la lógica de conmutación en un solo paquete. Las últimas plataformas Tomahawk y Jericho de Broadcom, junto con el Teralynx T100 de Marvell, apuntan a una dirección de dise?o que depende de un empaquetado sofisticado en lugar de la conexión de memoria independiente. Eso crea una competencia directa por el acceso al empaquetado entre el silicio de redes y los aceleradores de IA, otorgando a los compradores más grandes y a los que reservan antes una ventaja obvia en el mercado de HBM para conmutación de red y procesamiento de paquetes. Los proveedores de redes más peque?os, por tanto, enfrentan un camino más difícil hacia la escala, incluso cuando sus hojas de ruta técnicas son sólidas y la demanda de los clientes está presente. El resultado es un entorno de suministro a dos velocidades en el que los principales hiperescaladores pueden moverse más rápido, mientras que los OEM de segundo nivel y los proveedores orientados a empresas enfrentan tiempos de aceleración más lentos.
Controles de Exportación y Restricciones de Calificación en Nodos DRAM Avanzados
Los controles de exportación están a?adiendo sobrecarga de calificación al mercado de HBM para conmutación de red y procesamiento de paquetes, especialmente para los proveedores que envían sistemas avanzados a través de varias jurisdicciones. En mayo de 2026, la Oficina de Industria y Seguridad confirmó que los requisitos de licencia para artículos de computación avanzada continuaban aplicándose a las entidades con sede en el Grupo de Países D:5 y Macao bajo las disposiciones de control de exportación pertinentes. Eso importa porque las hojas de ruta actuales de conmutadores y enrutadores están vinculadas a generaciones avanzadas de HBM en lugar de nodos de memoria heredados, por lo que el cumplimiento ahora afecta la planificación central del producto en lugar de un caso marginal menor. Los proveedores y OEM deben revisar con mayor cuidado los usuarios finales, las rutas de envío y la propiedad de las entidades, lo que a?ade costos y puede alargar los ciclos de calificación para los destinos restringidos. Esos retrasos no impiden que el mercado de HBM para conmutación de red y procesamiento de paquetes crezca, pero sí ralentizan el calendario de implementación y complican la ejecución de la cadena de suministro para los proveedores globales.
*Nuestras previsiones consideran los impactos de impulsores y restricciones como direccionales, no aditivos. Las previsiones de impacto reflejan el crecimiento base, los efectos de mezcla y las interacciones entre variables.
Análisis de Segmentos
Por Aplicación:
Los ASICs de Conmutadores Ethernet Lideran los Ingresos Mientras los Conmutadores de Tejido de IA Crecen Más RápidoLos ASICs de conmutadores Ethernet mantuvieron el 43,13% de la participación del mercado de HBM para conmutación de red y procesamiento de paquetes en 2025, mientras que se proyecta que los conmutadores de tejido de red de IA crezcan a una CAGR del 42,03% de 2026 a 2031. Ese liderazgo en ingresos reflejó a?os de implementación en entornos Ethernet de hoja-espina hiperescaladores, donde la conmutación de búfer profundo ya se había convertido en un requisito práctico para grandes cargas de tráfico este-oeste. Broadcom se?aló que Jericho4 entregó 160 veces la capacidad de búfer de paquetes de la memoria en chip estándar, lo que explica por qué las plataformas Ethernet de búfer profundo siguieron siendo centrales para el dise?o de redes de IA de alto rendimiento en 2025 y 2026. Al mismo tiempo, el mercado de HBM para conmutación de red y procesamiento de paquetes está siendo atraído hacia tejidos de IA personalizados, y la asociación de NVIDIA de marzo de 2026 con Marvell, respaldada por una inversión de 2 mil millones de USD, ha vinculado más estrechamente la gestión avanzada de paquetes y las redes de escalado a dise?os con conocimiento de HBM.[2]NVIDIA Corporation, "NVIDIA and SK hynix Announce Multiyear Technology Partnership to Advance Memory for AI Factories," NVIDIA Investor Relations, investor.nvidia.com
La siguiente capa de demanda proviene de dispositivos de interfaz y procesamiento de paquetes que se sitúan más cerca del servidor, el borde de la red o el plano de control de telecomunicaciones. La hoja de datos del BCM88690 de Broadcom mostró que el hardware de procesamiento de red ya utilizaba dos cubos HBM Gen2 para un total de 8 GB de búfer de paquetes y admitía hasta 128.000 colas programables, lo que mantuvo a las NPU relevantes para el manejo determinístico del tráfico más allá de los tejidos de IA más grandes. Eso importa para el HBM en la industria de conmutación de red y procesamiento de paquetes porque muestra que la tecnología no se limita a los ASICs de conmutadores de gama alta y también puede admitir cargas de trabajo de procesamiento de paquetes con muchas colas y sensibles a la latencia. Con el tiempo, es probable que la demanda de aplicaciones siga ampliándose desde el nivel de conmutación de mayor rendimiento hacia dispositivos adyacentes a medida que mejoren los rendimientos de memoria, se facilite la economía por bit y la gestión de tráfico respaldada por HBM sea más fácil de justificar en más funciones de red.


Por Generación de HBM:
HBM3 Mantiene la Base Mientras HBM4 Establece el Próximo TechoHBM3 tuvo una participación del 55,92% en 2025, otorgándole la posición más grande en el tama?o del mercado de HBM para conmutación de red y procesamiento de paquetes por generación de HBM, mientras que se proyecta que HBM4 se expanda a una CAGR del 42,21% hasta 2031. HBM3 construyó esa ventaja porque la familia StrataDNX Jericho de Broadcom y los sistemas de clase Tomahawk entraron en producción durante 2024 y 2025, lo que le dio a esta generación la base comercial más sólida en las plataformas de conmutación implementadas. HBM2 y HBM2E permanecieron en plataformas heredadas de búfer profundo, pero su perfil de ancho de banda por pin se está volviendo menos adecuado a medida que las redes avanzan más profundamente en la conmutación de 400G y superior. La documentación del BCM88480 de Broadcom ilustró que los dise?os anteriores de HBM Gen2 aún servían a los sistemas de enrutadores instalados con 4 GB de memoria de búfer en paquete, lo que muestra por qué las generaciones más antiguas no desaparecieron de inmediato, incluso cuando las más nuevas ganaron participación.
El mercado de HBM para conmutación de red y procesamiento de paquetes se está moviendo ahora hacia HBM3E y HBM4, ya que el silicio de conmutadores de próxima generación requiere interfaces más amplias y mayor ancho de banda por pila. Una investigación del Technion, UC Berkeley y UC San Diego mostró que un dise?o de enrutador en paquete que utiliza 4 pilas HBM4 podría entregar 81,92 Tbps de ancho de banda de conmutación combinado, lo que destacó el margen arquitectónico de la próxima generación de memoria. Samsung comenzó la producción en masa de HBM4 en febrero de 2026, y NVIDIA y SK hynix formalizaron una asociación tecnológica plurianual en junio de 2026 para avanzar en la memoria de próxima generación para fábricas de IA, ambas de las cuales mejoraron la visibilidad en torno a la futura base de suministro. Esos movimientos respaldan la opinión de que el mercado de HBM para conmutación de red y procesamiento de paquetes continuará desplazándose hacia interfaces más amplias de 2.048 bits y mayor ancho de banda por pila a medida que la próxima ola de conmutación alcance la producción.
Por Capacidad de Memoria por Pila:
16 GB Ancló la Base Mientras 32 GB y Más Gana VelocidadLa configuración de 16 GB capturó el 47,32% del tama?o del mercado de HBM para conmutación de red y procesamiento de paquetes en 2025, mientras que se proyecta que las configuraciones de 32 GB y más crezcan a una CAGR del 42,17% hasta 2031. Esa posición de 16 GB coincidió con las necesidades de las plataformas de 25,6 Tbps a 51,2 Tbps, donde 2 a 4 pilas eran suficientes para admitir un búfer profundo sin elevar el costo del paquete más allá de la tolerancia hiperescaladora convencional. El nivel de 8 GB aún se adapta a las NPU de telecomunicaciones y a los conmutadores de borde sensibles al costo, mientras que 24 GB ha surgido como un paso intermedio práctico entre la conmutación de hoja y las plataformas de enrutamiento de tejido grande. El nivel de 4 GB está perdiendo relevancia porque los nuevos patrones de tráfico de IA pueden consumir rápidamente grupos de búfer superficiales cuando tanto las ráfagas de paquetes como la duración de la congestión aumentan.
En el extremo superior, 32 GB y más está ganando impulso porque las hojas de ruta de HBM4 se están moviendo hacia 32 GB a 64 GB por pila, y los tejidos de IA más grandes necesitan más espacio para absorber la congestión en bastidores y sitios. Micron se?aló que todo su suministro de HBM de 2026 estaba comprometido bajo acuerdos de precio y volumen, lo que indica una demanda muy fuerte de pilas de alta capacidad en implementaciones de aceleradores y redes. Samsung se?aló que sus ingresos de HBM de 2026 se triplicarían con creces a?o tras a?o a medida que HBM4 se acelera, lo que respalda una mayor disponibilidad futura de pilas más altas que pueden adaptarse a casos de uso de redes y cómputo de gama alta. Este patrón sugiere que el mercado de HBM para conmutación de red y procesamiento de paquetes continuará desplazándose hacia grupos de búfer más grandes, ya que las redes de IA distribuidas están convirtiendo los eventos de congestión más largos y complejos en la norma en lugar de la excepción.
Por Industria de Usuario Final:
Los Centros de Datos en la Nube Dominan el Gasto Mientras las Redes HPC Crecen Más RápidoLos centros de datos en la nube mantuvieron una participación del 78,03% en 2025, mientras que se proyecta que las redes de computación de alto rendimiento se expandan a una CAGR del 42,09% hasta 2031, convirtiéndolas en el grupo de usuarios finales de más rápido crecimiento en el mercado de HBM para conmutación de red y procesamiento de paquetes. El gasto en la nube dominó porque los compradores más grandes ya estaban construyendo clústeres con recuentos de aceleradores muy altos, y esos entornos dependían cada vez más de tejidos Ethernet 800G y conmutadores de búfer profundo para mantener un rendimiento estable bajo cargas de trabajo de IA mixtas. El mercado de HBM para conmutación de red y procesamiento de paquetes, por tanto, siguió estrechamente vinculado a los ciclos de capital hiperescaladores, donde la escala, la disponibilidad y la certeza de la hoja de ruta importan tanto como el rendimiento bruto del silicio. Ese equilibrio explica por qué la demanda de la nube lideró los ingresos incluso mientras algunos de los requisitos técnicos más agudos provenían de entornos de investigación y computación nacional más peque?os pero más exigentes.
Los programas de HPC respaldados por el gobierno fueron una se?al de crecimiento sólida porque la Administración Nacional de Seguridad Nuclear otorgó 18 millones de USD a Cornelis Networks en 2025 para trabajos de redes de alto rendimiento de próxima generación. Cornelis también anunció el despliegue del CN5000 para el entorno de la NNSA en el Laboratorio Nacional Lawrence Livermore, demostrando que el rendimiento de interconexión de alta velocidad determinístico estaba pasando a la adquisición real en lugar de permanecer como un concepto de laboratorio. Los operadores de telecomunicaciones formaron una segunda corriente de demanda a medida que las implementaciones de núcleo autónomo 5G continuaron dependiendo de procesadores de paquetes con control de cola enriquecido y comportamiento de latencia determinístico, mientras que la demanda empresarial y de defensa gubernamental se mantuvo más peque?a pero estable. Esa combinación significa que los compradores de la nube probablemente seguirán siendo la principal fuente de volumen, mientras que HPC continuará influyendo en los requisitos de dise?o más avanzados dentro del mercado de HBM para conmutación de red y procesamiento de paquetes.
Análisis Geográfico
Mercado de HBM para Conmutación de Red y Procesamiento de Paquetes en América del Norte
América del Norte concentró el 44,68% de la cuota del mercado de HBM para conmutación de red y procesamiento de paquetes en 2025. La región lideró porque Estados Unidos albergaba a los mayores compradores de silicio de conmutación avanzada a escala de hiperscala y fue el primero en adoptar plataformas de red respaldadas por HBM de alta gama a gran escala. Google reveló en 2026 que su red Virgo conectaba 134.000 chips TPU en un dise?o plano sin bloqueo y ofrecía hasta 47 petabits por segundo de ancho de banda biseccional, lo que refleja la escala de infraestructura que los operadores norteamericanos ya estaban planificando e implementando.[3]Google Cloud, "Introducing Virgo Network Megascale Data Center Fabric," Google Cloud Blog, cloud.google.com Este tipo de implementación favorece a los conmutadores con un ancho de banda de memoria y un almacenamiento en búfer de paquetes mucho más profundos de los que pueden ofrecer los dise?os convencionales, lo que mantiene el mercado de HBM para conmutación de red y procesamiento de paquetes estrechamente alineado con el ciclo de gasto de hiperscala de la región. La demanda gubernamental también respaldó la base regional después de que la NNSA apoyara el trabajo de redes de próxima generación con Cornelis Networks para programas de computación nacional.
Mercado de HBM para Conmutación de Red y Procesamiento de Paquetes en Europa y 罢补颈飞á苍
Europa aportó una cuota significativa en 2025, con Alemania, el Reino Unido, Francia y los países nórdicos albergando importantes campus en la nube e implementaciones de redes de alta capacidad. La región también se benefició de las actualizaciones del núcleo autónomo de 5G, que respaldaron el interés continuo en procesadores de paquetes y sistemas de enrutamiento con subsistemas de memoria más ricos. Los programas nacionales de inteligencia artificial en el Reino Unido y Alemania están contribuyendo a sostener la inversión futura en centros de datos, lo que debería respaldar la adopción gradual de silicio de conmutación avanzada durante el período de previsión. Europa también tiene un interés estratégico en reducir la dependencia a largo plazo de las capacidades de semiconductores y empaquetado, aunque 罢补颈飞á苍 sigue siendo el centro de empaquetado principal para HBM en el mercado de conmutación de red y procesamiento de paquetes en la actualidad.
Mercado de HBM para Conmutación de Red y Procesamiento de Paquetes en América del Sur, 础蝉颈补-笔补肠í蹿颈肠辞 y Oriente Medio y ?frica
Se proyecta que 础蝉颈补-笔补肠í蹿颈肠辞 crecerá a una CAGR del 42,23% hasta 2031, convirtiéndose en la región de mayor crecimiento en el mercado de HBM para conmutación de red y procesamiento de paquetes. Corea del Sur se sitúa en el centro de la oferta porque SK hynix publicó resultados récord en el ejercicio fiscal 2025, y NVIDIA estableció una asociación tecnológica plurianual con SK hynix en junio de 2026 para la memoria de próxima generación utilizada en infraestructura de inteligencia artificial. 罢补颈飞á苍 sigue siendo indispensable porque las plataformas de conmutación más avanzadas orientadas a la inteligencia artificial de Broadcom y Marvell dependen de rutas de ensamblaje intensivas en empaquetado que están profundamente vinculadas al ecosistema de semiconductores de la isla. India y el Sudeste Asiático se encuentran en una etapa más temprana de adopción, pero la inversión doméstica en la nube está comenzando a generar demanda futura de plataformas de conmutación integradas con HBM. América del Sur, Oriente Medio y ?frica siguen siendo oportunidades a más largo plazo, donde la modernización empresarial y las actualizaciones de redes gubernamentales son los impulsores más importantes a corto plazo, por encima de las grandes implementaciones de tejidos de inteligencia artificial.

Panorama Competitivo
El mercado de HBM para conmutación de red y procesamiento de paquetes se mantuvo concentrado en la capa de suministro de memoria, con Samsung, SK hynix y Micron representando la disponibilidad comercial de HBM en las generaciones actuales. La competencia fue más amplia en la capa de ASICs de conmutadores, donde Broadcom, Marvell, Cisco y NVIDIA siguieron diferentes enfoques en cuanto a búferes, óptica, tejidos de escalado y asociaciones a nivel de sistema. Broadcom reforzó su posición cuando comenzó a enviar Tomahawk 6 en volumen de producción en marzo de 2026, tras haber enviado Jericho4 en agosto de 2025 para casos de uso de computación de IA distribuida. También aseguró demanda a largo plazo a través de un acuerdo de garantía de suministro de redes con Google hasta 2031 y una asociación ampliada con Meta hasta 2029, lo que redujo la incertidumbre en torno a las futuras victorias de dise?o y la planificación del suministro. Marvell respondió lanzando el Teralynx T100 en junio de 2026 y vinculando su hoja de ruta más estrechamente a NVIDIA a través de la asociación NVLink Fusion de marzo de 2026, lo que le dio una ruta protegida hacia los programas de redes de fábricas de IA.
El mercado de HBM para conmutación de red y procesamiento de paquetes aún tiene espacio para crecer en el borde de telecomunicaciones y las redes empresariales, donde menos proveedores ofrecen hardware de procesamiento de paquetes integrado con HBM adaptado para la gestión determinística del tráfico. Otro posible cambio es el auge de la desagregación de memoria a través de CXL, que podría cambiar la forma en que los sistemas futuros equilibran el almacenamiento en búfer de paquetes local y el acceso a memoria compartida. El lanzamiento de Marvell en marzo de 2026 del conmutador CXL Structera S 30260 mostró que la agrupación de memoria a nivel de bastidor estaba pasando del concepto al silicio comercial. Si ese enfoque escala, algunos niveles sensibles al costo pueden depender menos del HBM completamente co-empaquetado y más de los tejidos de memoria compartida alrededor del sistema de conmutadores.
En el lado de la memoria, las relaciones con los proveedores se están volviendo más estratégicas que transaccionales en el mercado de HBM para conmutación de red y procesamiento de paquetes. NVIDIA y SK hynix formalizaron una asociación tecnológica plurianual en junio de 2026, mientras que Micron se?aló que su suministro de HBM de 2026 estaba totalmente comprometido bajo acuerdos de precio y volumen, ambos de los cuales indicaron que la disponibilidad futura está cada vez más vinculada a compromisos comerciales a largo plazo.[4]NVIDIA Corporation, "NVIDIA AI Ecosystem Expands as Marvell Joins Forces Through NVLink Fusion," NVIDIA Investor Relations, investor.nvidia.com Samsung también comenzó la producción en masa de HBM4 en 2026, lo que indicó que la próxima generación de pilas estaba pasando de la discusión de la hoja de ruta a la producción real. Estos movimientos estratégicos elevan la barrera de entrada, porque los nuevos competidores deben igualar no solo el rendimiento del chip, sino también el acceso a memoria avanzada, la preparación del empaquetado y la garantía de suministro plurianual. Esa combinación deja al mercado de HBM para conmutación de red y procesamiento de paquetes concentrado en el suministro, mientras que aún permite una competencia activa por las victorias de dise?o de sistemas más grandes.
Líderes de la Industria de HBM para Conmutación de Red y Procesamiento de Paquetes
-
SK hynix Inc.
-
Samsung Electronics Co., Ltd.
-
Micron Technology, Inc.
- *Nota aclaratoria: los principales jugadores no se ordenaron de un modo en especial
Mercado de HBM para Conmutación de Red y Procesamiento de Paquetes
- SK hynix Inc.
- Samsung Electronics Co., Ltd.
- Micron Technology, Inc.

Recent Industry Developments in Mercado de HBM para Conmutación de Red y Procesamiento de Paquetes
- Junio de 2026: NVIDIA y SK hynix anunciaron una asociación tecnológica plurianual para avanzar en la memoria de próxima generación para la construcción global de fábricas de IA, que abarca el suministro de memoria avanzada y la colaboración en el dise?o de semiconductores de próxima generación alineada con la hoja de ruta de infraestructura de IA de NVIDIA. El acuerdo formaliza lo que anteriormente era una profunda relación de co-ingeniería en un compromiso contractual de suministro y desarrollo.
- Junio de 2026: Marvell Technology lanzó el Teralynx T100, el primer silicio de conmutadores de 102,4 Tbps de la industria dise?ado específicamente para las redes de la era de la IA, fabricado en un nodo de proceso de 3 nm con múltiples configuraciones de empaquetado, matriz de rejilla de bolas, cobre co-empaquetado y óptica co-empaquetada, y en muestreo para clientes. El T100 compite directamente con el Tomahawk 6 de Broadcom, desafiando la participación de mercado estimada del 80% de Broadcom en el nivel de mayor ancho de banda de los ASICs de conmutación Ethernet.
- Abril de 2026: Broadcom firmó una asociación estratégica multigeneracional y plurianual con Meta para suministrar tecnología de chips y redes que respalda los chips de Acelerador de Entrenamiento e Inferencia de Meta hasta 2029, con las interconexiones a escala de bastidor basadas en Ethernet de Broadcom formando la columna vertebral de la red del centro de datos de IA y abordando las jerarquías de memoria en evolución.
- Abril de 2026: Broadcom y Google firmaron un acuerdo a largo plazo para que Broadcom desarrolle y suministre unidades de procesamiento tensorial personalizadas y un acuerdo de garantía de suministro para redes y otros componentes para los bastidores de IA de próxima generación de Google hasta 2031, un contrato que compromete las hojas de ruta de silicio de conmutadores integrado con HBM a volúmenes hiperescaladores en un horizonte temporal multigeneracional.


Alcance del Informe Global del Mercado de HBM para Conmutación de Red y Procesamiento de Paquetes
El Mercado de HBM para Conmutación de Red y Procesamiento de Paquetes está Segmentado por Aplicación (ASICs de Conmutadores Ethernet, Unidades de Procesamiento de Datos (DPUs), SmartNICs, Unidades de Procesamiento de Red (NPUs) y Conmutadores de Tejido de Red de IA), Generación de HBM (HBM2, HBM2E, HBM3, HBM3E y HBM4), Capacidad de Memoria por Pila (4 GB, 8 GB, 16 GB, 24 GB y 32 GB y Más), Industria de Usuario Final (Centros de Datos en la Nube, Telecomunicaciones, Redes Empresariales, Gobierno y Defensa, y Redes de Computación de Alto Rendimiento) y Geografía (América del Norte, Europa, 础蝉颈补-笔补肠í蹿颈肠辞, América del Sur y Oriente Medio y ?frica). Los Pronósticos del Mercado se Proporcionan en Términos de Valor (USD).
| ASICs de Conmutadores Ethernet |
| Unidades de Procesamiento de Datos (DPUs) |
| SmartNICs |
| Unidades de Procesamiento de Red (NPUs) |
| Conmutadores de Tejido de Red de IA |
| HBM2 |
| HBM2E |
| HBM3 |
| HBM3E |
| HBM4 |
| 4 GB |
| 8 GB |
| 16 GB |
| 24 GB |
| 32 GB y Más |
| Centros de Datos en la Nube |
| Telecomunicaciones |
| Redes Empresariales |
| Gobierno y Defensa |
| Redes de Computación de Alto Rendimiento |
| América del Norte | Estados Unidos |
| 颁补苍补诲á | |
| 惭é虫颈肠辞 | |
| Europa | Alemania |
| Reino Unido | |
| Francia | |
| Italia | |
| Resto de Europa | |
| 础蝉颈补-笔补肠í蹿颈肠辞 | China |
| 闯补辫ó苍 | |
| Corea del Sur | |
| 罢补颈飞á苍 | |
| India | |
| Resto de 础蝉颈补-笔补肠í蹿颈肠辞 | |
| América del Sur | |
| Oriente Medio y ?frica |
| Por Aplicación | ASICs de Conmutadores Ethernet | |
| Unidades de Procesamiento de Datos (DPUs) | ||
| SmartNICs | ||
| Unidades de Procesamiento de Red (NPUs) | ||
| Conmutadores de Tejido de Red de IA | ||
| Por Generación de HBM | HBM2 | |
| HBM2E | ||
| HBM3 | ||
| HBM3E | ||
| HBM4 | ||
| Por Capacidad de Memoria por Pila | 4 GB | |
| 8 GB | ||
| 16 GB | ||
| 24 GB | ||
| 32 GB y Más | ||
| Por Industria de Usuario Final | Centros de Datos en la Nube | |
| Telecomunicaciones | ||
| Redes Empresariales | ||
| Gobierno y Defensa | ||
| Redes de Computación de Alto Rendimiento | ||
| Por Geografía | América del Norte | Estados Unidos |
| 颁补苍补诲á | ||
| 惭é虫颈肠辞 | ||
| Europa | Alemania | |
| Reino Unido | ||
| Francia | ||
| Italia | ||
| Resto de Europa | ||
| 础蝉颈补-笔补肠í蹿颈肠辞 | China | |
| 闯补辫ó苍 | ||
| Corea del Sur | ||
| 罢补颈飞á苍 | ||
| India | ||
| Resto de 础蝉颈补-笔补肠í蹿颈肠辞 | ||
| América del Sur | ||
| Oriente Medio y ?frica | ||


Preguntas Clave Respondidas en el Informe
?Cuál es el tama?o actual y proyectado del espacio de HBM para conmutación de red y procesamiento de paquetes?
Se espera que el tama?o del mercado de HBM para conmutación de red y procesamiento de paquetes aumente de 0,15 mil millones de USD en 2025 a 0,21 mil millones de USD en 2026 y alcance 1,18 mil millones de USD en 2031, a una CAGR del 41,23%.
?Qué aplicación lidera los ingresos hoy?
Los ASICs de conmutadores Ethernet lideraron los ingresos con una participación del 43,13% en 2025 porque ya tenían una amplia base instalada en tejidos Ethernet hiperescaladores.
?Qué generación de HBM está creciendo más rápido?
HBM4 es el segmento de generación de HBM de más rápido crecimiento, con una CAGR proyectada del 42,21% hasta 2031, a medida que el silicio de conmutadores de próxima generación avanza hacia interfaces más amplias y mayor ancho de banda por pila.
?Por qué los centros de datos en la nube son los principales compradores?
Los centros de datos en la nube representaron el 78,03% de la demanda en 2025 porque los hiperescaladores fueron los primeros en construir clústeres de IA muy grandes que necesitaban plataformas de conmutación de búfer profundo y baja latencia.
?Qué región muestra las perspectivas de crecimiento más sólidas?
Se proyecta que 础蝉颈补-笔补肠í蹿颈肠辞 crezca a una CAGR del 42,23% hasta 2031, respaldada por la base de suministro de HBM de Corea del Sur y el papel de 罢补颈飞á苍 en el empaquetado avanzado de semiconductores.
?Cuál es el principal desafío del lado de la oferta para los proveedores?
El empaquetado avanzado sigue siendo la principal restricción a corto plazo porque los dise?os de conmutadores integrados con HBM compiten con los aceleradores de IA por la misma capacidad de fabricación intensiva en empaquetado.
?ltima actualización de la página el:



