
AI Inference GPU Marktgr??e und Marktanteil
惭补谤办迟ü产别谤蝉颈肠丑迟
| Studienzeitraum | 2020 - 2031 |
|---|---|
| Marktgr??e (2026) | 14.87 Milliarden US-Dollar |
| Marktgr??e (2031) | 57.29 Milliarden US-Dollar |
| Growth Rate (2026 - 2031) | 30.97 % |
| Schnellstwachsender Markt | Asien-Pazifik |
| Gr??ter Markt | Asien-Pazifik |
| Marktkonzentration | Mittel |
Hauptakteure
*Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert Bild ? 黑料不打烊. Wiederverwendung erfordert Namensnennung gem?? CC BY 4.0. |
|
AI Inference GPU Marktanalyse von 黑料不打烊
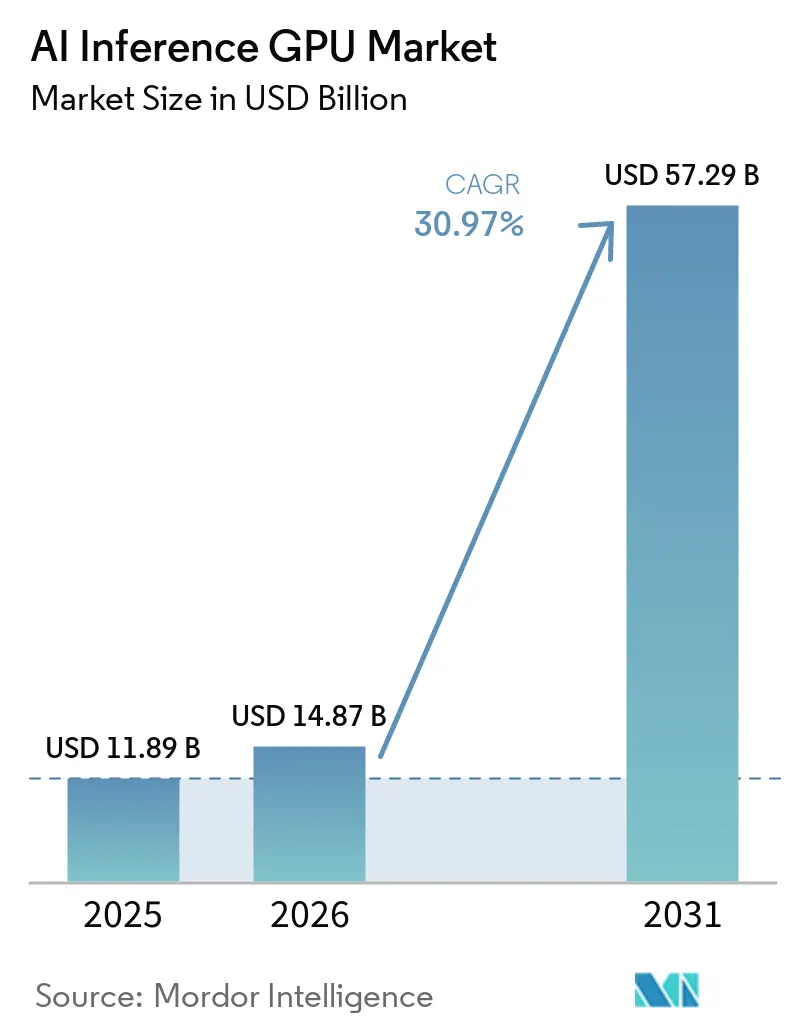
Die AI Inference GPU Marktgr??e wird voraussichtlich von 11,89 Milliarden USD im Jahr 2025 und 14,87 Milliarden USD im Jahr 2026 auf 57,29 Milliarden USD bis 2031 anwachsen, mit einer CAGR von 30,97 % zwischen 2026 und 2031. Der zunehmende Einsatz von generativen KI-Modellen im Produktionsma?stab verlagert Kapital in Richtung Inferenz-Cluster, bei denen Durchsatz pro Watt und Gesamtbetriebskosten die reine Trainingsgeschwindigkeit bei Rechenzentrum-Investitionsentscheidungen überwiegen. Meta Platforms gab bekannt, im Gesch?ftsjahr 2025 mehr als 600.000 NVIDIA H100 GPUs zu betreiben, wobei ein gro?er Anteil für Inferenz-Workloads bestimmt ist, die Llama-basierte Empfehlungs- und Inhaltsmoderierungsdienste unterstützen. Exportkontrollen, die Lieferungen fortschrittlicher GPUs nach China einschr?nken, haben die Einführung inl?ndischer Alternativen wie Huaweis Ascend 910C und Alibabas Hanguang 800 beschleunigt und den regionalen Wettbewerb versch?rft. Hyperscale-Betreiber setzen gleichzeitig auf Open-Source-Inferenz-Compiler.
Wichtigste Erkenntnisse des Berichts
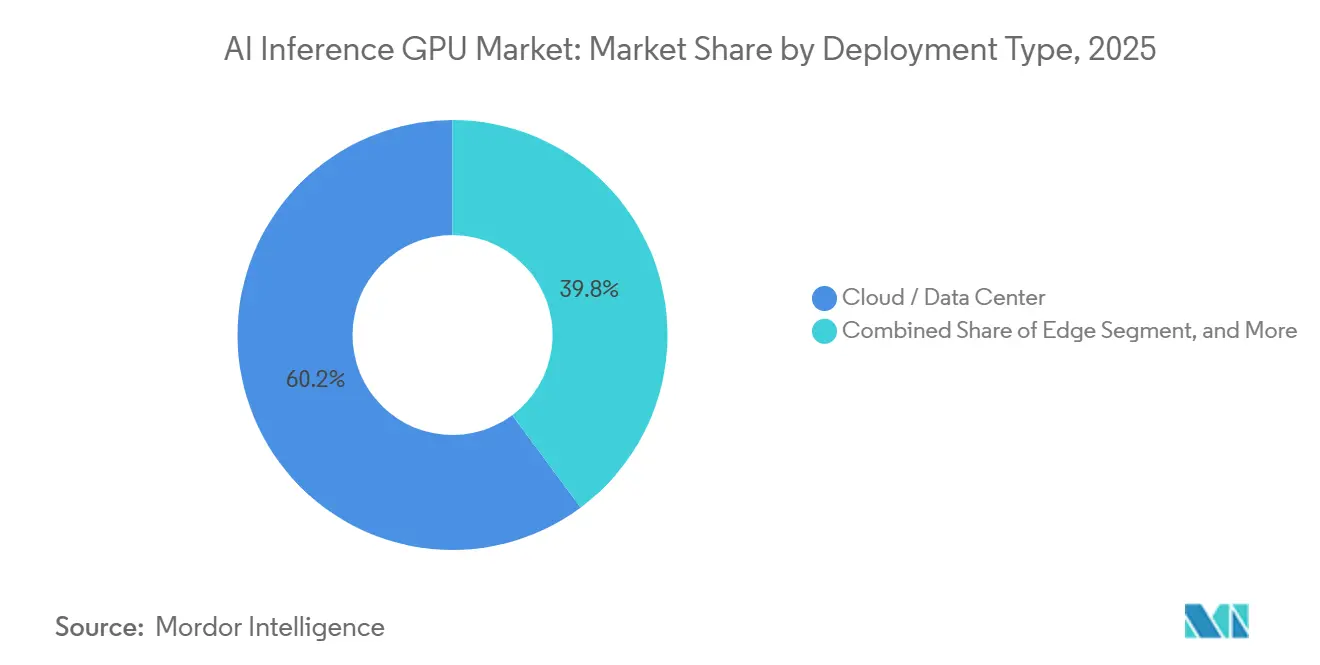
- Nach Bereitstellungstyp führten Cloud- und Rechenzentrumsbereitstellungen mit einem AI Inference GPU Marktanteil von 60,17 % im Jahr 2025.
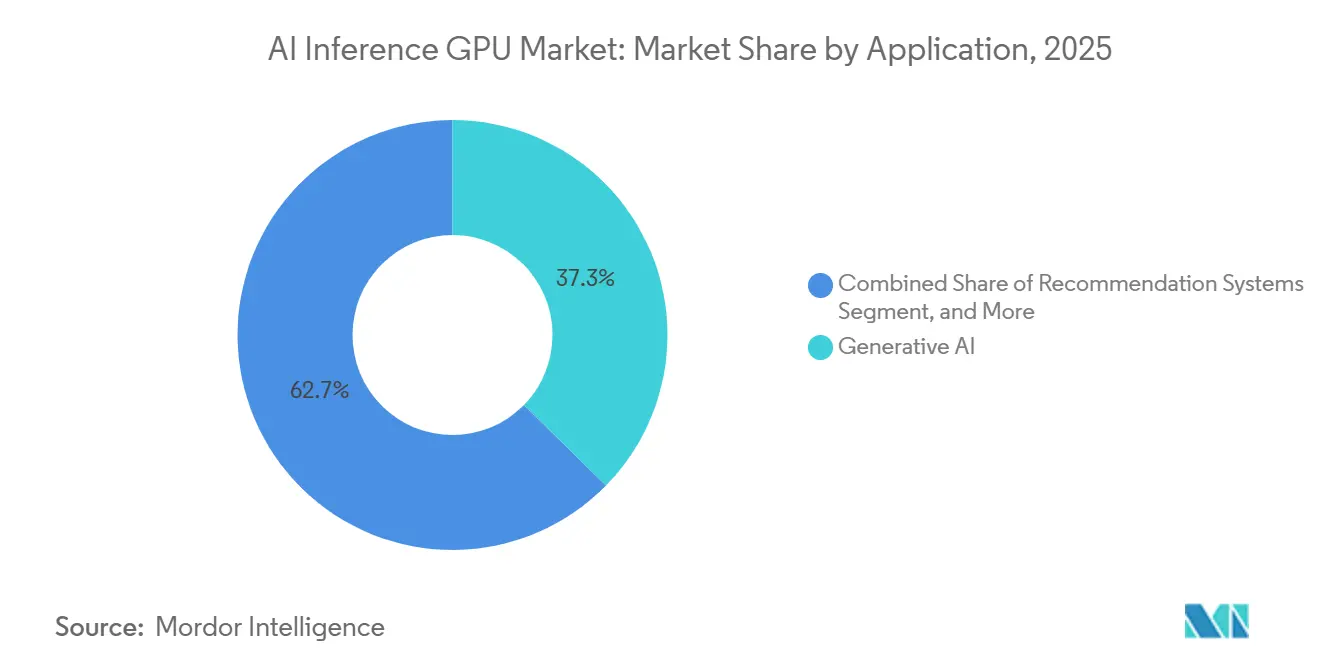
- Nach Anwendung entfiel auf generative KI ein Anteil von 37,34 % am AI Inference GPU Markt im Jahr 2025, mit einer CAGR von 31,75 % bis 2031.
- Nach Formfaktor hielten PCIe GPUs im Jahr 2025 einen Anteil von 50,44 % am AI Inference GPU Markt, w?hrend eingebettete Module voraussichtlich mit einer CAGR von 31,78 % bis 2031 wachsen werden.
- Nach Anwendung entfiel auf generative KI ein Anteil von 3 im Jahr 2025 und eine CAGR von 31,75 % bis 2031.
Hinweis: Die Marktgr??e und Prognosezahlen in diesem Bericht werden mithilfe des propriet?ren Sch?tzungsrahmens von 黑料不打烊 erstellt und mit den neuesten verfügbaren Daten und Erkenntnissen vom Januar 2026 aktualisiert.
Markttrends und Einblicke
Analyse der Treiberwirkung*
| TREIBER | (~) % AUSWIRKUNG AUF DIE CAGR-PROGNOSE | GEOGRAFISCHE RELEVANZ | ZEITHORIZONT DER AUSWIRKUNG |
|---|---|---|---|
| Steigende Nachfrage nach generativen KI-Diensten in Hyperscale-Rechenzentren | +8.5% | Global, konzentriert in Nordamerika und Asien-Pazifik | Mittelfristig (2–4 Jahre) |
| Rasche Verbreitung von Empfehlungsmaschinen auf E-Commerce-Plattformen | +6.2% | Global, angeführt von Asien-Pazifik und Nordamerika | Kurzfristig (≤ 2 Jahre) |
| Ausweitung von Computer Vision in industriellen Automatisierungslinien | +5.8% | Produktionszentren in Europa und Asien-Pazifik | Mittelfristig (2–4 Jahre) |
| Wachsende Nutzung von konversationeller KI im Kundensupport | +4.9% | Global, frühe Dynamik in Nordamerika und Europa | Kurzfristig (≤ 2 Jahre) |
| Entstehung von Transformer-Pruning-optimierten Inferenz-GPUs | +3.7% | Global, getrieben von Hyperscale-Betreibern | Langfristig (≥ 4 Jahre) |
| Verfügbarkeit von Open-Source-Inferenz-Compilern zur Senkung der Gesamtbetriebskosten | +2.6% | Global | Mittelfristig (2–4 Jahre) |
| Quelle: 黑料不打烊 | |||
Steigende Nachfrage nach generativen KI-Diensten in Hyperscale-Rechenzentren
Hyperscale-Clouds stellen Inferenz-Cluster bereit, die inzwischen die Gr??e ihrer Trainingssysteme übertreffen, was die Realit?t widerspiegelt, dass ein einziges gro?es Sprachmodell Millionen gleichzeitiger Nutzer bedient. Microsoft Azure fügte Ende 2025 120.000 NVIDIA H200 NVL GPUs hinzu, um GitHub Copilot und Azure OpenAI-Endpunkte zu unterstützen, die im Dezember 2025 mehr als 50 Milliarden API-Aufrufe verarbeiteten.[1]Microsoft, "Azure Expands H200 Fleet," news.microsoft.com Oracle Cloud Infrastructure meldete eine Verfügbarkeit von 99,95 % für GPU-Inferenz-Workloads nach der Einführung flüssigkeitsgekühlter Rack-Designs, die die Sperrschichttemperaturen unter 75 °C halten. AWS führte im M?rz 2026 den benutzerdefinierten Inferentia 3-Chip ein, der den dreifachen Durchsatz von Inferentia 2 liefert, doch NVIDIA Blackwell NVL bleibt bei Mixed-Precision-Workloads führend, die FP8- und INT4-Quantisierung nutzen. Meta gab bekannt, dass die Inferenzinfrastruktur 18 Milliarden USD seines Kapitalbudgets von 40 Milliarden USD für 2025 verbrauchte, was die strategische Priorit?t des Eigenbetriebs gegenüber der Anmietung von Kapazit?ten unterstreicht. Da sich die Latenzanforderungen für konversationelle KI von 500 Millisekunden im Jahr 2024 auf weniger als 200 Millisekunden im Jahr 2026 versch?rfen, steigt die Nachfrage nach GPUs mit Hochbandbreitenspeicher und Verbindungen mit geringer Latenz weiter an.
Rasche Verbreitung von Empfehlungsmaschinen auf E-Commerce-Plattformen
Echtzeit-Personalisierung arbeitet heute mit einer Latenz von unter 10 Millisekunden, was Einzelh?ndler zwingt, Inferenz-GPUs einzusetzen, die sp?rliche Einbettungen und dynamische Merkmale ohne Batch-Verz?gerungen verwalten. Amazon Personalize steigerte den Inferenz-Durchsatz im Jahr 2025, als H?ndler von CPU-basiertem kollaborativem Filtern auf GPU-beschleunigte Deep-Learning-Modelle migrierten.[2]Amazon, "Amazon Personalize 2025 Annual Report," sec.gov Alibaba Clouds Hanguang 800-Chip reduzierte die Empfehlungslatenz auf Taobao und Tmall von 35 Millisekunden auf 12 Millisekunden und senkte den Energieverbrauch pro Abfrage w?hrend des Singles-Day-Peaks 2025 um 60 %. Shopify integrierte NVIDIA TensorRT-LLM im September 2025, wodurch Produktentdeckungsmodelle sich innerhalb von 5 Minuten an Bestands?nderungen anpassen konnten und die Konversionsraten für Piloth?ndler stiegen. ByteDance gab an, dass TikTok Shop 400 Millionen Produktimpressionen pro Stunde auf NVIDIA A100- und H100-GPUs verarbeitet, wobei die Inferenzkosten aufgrund aggressivem Modell-Pruning weniger als 0,02 % des Bruttowarenwerts ausmachen.
Ausweitung von Computer Vision in industriellen Automatisierungslinien
Hersteller installieren Inferenz-GPUs an Inspektionspunkten, um Defekte mit Geschwindigkeiten zu erkennen, die die menschliche Sichtprüfung übertreffen. BMW Group setzte 2025 NVIDIA Jetson AGX Orin-Module in 47 Werken ein und senkte die Falsch-Positiv-Rate bei Lackfehlern auf unter 0,5 %.[3]BMW Group, "Sustainability Report 2025," bmw.com Siemens' Simatic AI-Plattform, die auf Intel Gaudi 3-Beschleunigern basiert, reduzierte ungeplante Ausfallzeiten in Halbleiterfabriken um 18 %, indem sie Ausf?lle 72 Stunden im Voraus vorhersagte. Bosch Rexroth integrierte AMD Instinct MI300A Ende 2025 in ctrlX-Controller, um eine geschlossene Regelkreisantwort von 10 Millisekunden für Hochgeschwindigkeitsrobotik zu gew?hrleisten. Cognex rüstete In-Sight-Bildverarbeitungssysteme mit eingebetteten Beschleunigern auf und erzielte eine Verfügbarkeit von 99,7 % in Hochvibrationszonen, eine Verbesserung um vier Prozentpunkte gegenüber früheren Designs mit externer Rechenleistung. Edge-Bereitstellungen dominieren, da industrielle Protokolle den durch Cloud-Roundtrips eingeführten Jitter nicht tolerieren k?nnen.
Wachsende Nutzung von konversationeller KI im Kundensupport
Unternehmen lagern den Tier-1-Support an generative KI-Agenten aus, die Probleme autonom l?sen, die durchschnittliche Bearbeitungszeit verkürzen und menschliche Agenten für Eskalationen freisetzen. Salesforces Einstein GPT l?ste 35 % der Kundenservicef?lle ohne menschliches Eingreifen in Pilotprojekten in den Bereichen Telekommunikation und Finanzen, wobei Inferenz auf gemischten NVIDIA H100- und AMD MI300X-Flotten ausgeführt wurde.[4]Salesforce, "Q1 FY 2026 Earnings Call Transcript," salesforce.com ServiceNows Now Assist, betrieben von einem fein abgestimmten Llama 3, senkte die mittlere Zeit bis zur L?sung für IT-Service-Workflows durch den Einsatz von Retrieval-Augmented Generation. Microsoft Dynamics 365 Copilot verarbeitete im vierten Quartal 2025 mehr als 2 Milliarden Support-Interaktionen, wobei die Inferenzkosten nach der Einführung von INT8-Quantisierung und spekulativem Decoding um 40 % sanken. Regulierte Sektoren bevorzugen On-Premises-Inferenz, um Datenübertragungsgebühren zu vermeiden; JPMorgan Chase betreibt eine private Cloud mit über 10.000 NVIDIA H100 GPUs, um Kundendaten intern zu halten.
Analyse der Hemmnisse*
| HEMMNIS | (~) % AUSWIRKUNG AUF DIE CAGR-PROGNOSE | GEOGRAFISCHE RELEVANZ | ZEITHORIZONT DER AUSWIRKUNG |
|---|---|---|---|
| Hohe Anfangsinvestitionskosten für High-End-Inferenz-GPUs | -4.3% | Global, starke Auswirkungen auf mittelst?ndische Unternehmen in Schwellenm?rkten | Kurzfristig (≤ 2 Jahre) |
| Strom- und Kühlungsbeschr?nkungen bei Edge-Bereitstellungen | -3.8% | Global, insbesondere an abgelegenen und industriellen Edge-Standorten | Mittelfristig (2–4 Jahre) |
| Lieferkettenvolatilit?t bei fortschrittlichen Verpackungssubstraten | -2.9% | Global, konzentriert in Halbleiter-Hubs im Asien-Pazifik-Raum | Mittelfristig (2–4 Jahre) |
| Wachsender Wettbewerb durch RISC-V- und benutzerdefinierte ASIC-KI-Beschleuniger | -2.1% | Global, frühe Einführung in Hyperscale- und souver?nen KI-Projekten | Langfristig (≥ 4 Jahre) |
| Quelle: 黑料不打烊 | |||
Hohe Anfangsinvestitionskosten für High-End-Inferenz-GPUs
Die Listenpreise für NVIDIA H200 NVL-Einheiten übersteigen 40.000 USD und stellen eine erhebliche Hürde für mittelst?ndische Unternehmen dar, denen Risikokapitalkredite oder Cloud-Guthaben fehlen. Dell Technologies gab an, dass die durchschnittlichen Verkaufspreise für KI-optimierte Server aufgrund von Hochbandbreitenspeicher- und Flüssigkühlungsanforderungen um 35 % gegenüber dem Vorjahr gestiegen sind.[5]Dell Technologies, "Q4 FY 2026 Earnings Highlights," dell.com Supermicro meldete Lieferzeiten von 16 Wochen für GPU-Server und verlangte 50 % Anzahlungen, was die Lieferungen bis Ende 2026 verz?gert. Equinix-Daten zeigen, dass KI-Inferenz-Racks durchschnittlich 25 Kilowatt verbrauchen, was zu einem Aufschlag bei Colocation-Gebühren führt. NVIDIAs DGX Cloud-Abonnement zu 5,50 USD pro GPU-Stunde bietet eine Alternative, aber Eigentum ist nur dann kosteneffektiv, wenn die Auslastung über 60 % bleibt.
Strom- und Kühlungsbeschr?nkungen bei Edge-Bereitstellungen
Edge-Standorte begrenzen Racks oft auf 500 Watt, was Entwickler zwingt, Modellkomplexit?t gegen thermischen Spielraum abzuw?gen. Qualcomms Snapdragon X Elite-Plattform liefert 45 TOPS INT8-Leistung in einem 15-Watt-Geh?use, das für lüfterlose Kioske geeignet ist. Der NVIDIA Jetson AGX Orin kann unter Spitzenlast 60 Watt erreichen und ben?tigt nach 30 Minuten aktive Kühlung, was seinen Einsatz in versiegelten Au?engeh?usen einschr?nkt. Studien der Internationalen Elektrotechnischen Kommission zeigen Leistungseinbu?en, wenn die Sperrschichttemperaturen 85 °C überschreiten, eine h?ufige Herausforderung in nicht belüfteten industriellen Umgebungen. Intel Xeon 6-Prozessoren integrieren AMX-Kacheln und liefern 2 TFLOPS INT8-Inferenz innerhalb bestehender CPU-Thermalhüllen, wodurch der Bedarf an diskreten GPUs in einigen latenzempfindlichen Edge-Anwendungen entf?llt.
*Unsere Prognosen behandeln die Auswirkungen von Treibern und Einschr?nkungen als richtungsweisend und nicht additiv. Die Wirkungsprognosen berücksichtigen Basiswachstum, Mischungseffekte und Wechselwirkungen zwischen Variablen.
Segmentanalyse
Nach Bereitstellungstyp:
Cloud-Dominanz verankert durch Hyperscale-BetreiberCloud- und Rechenzentrumsinstallationen hielten 2025 einen AI Inference GPU Marktanteil von 60,17 %, da Hyperscaler Ressourcen bündelten, um Milliarden t?glicher API-Aufrufe zu bedienen. Microsofts Azure-Erg?nzung von 120.000 H200 NVL-Einheiten Ende 2025 erm?glichte 50 Milliarden GitHub Copilot-Aufrufe in einem einzigen Monat und unterstreicht die Durchsatzkriterien, die Beschaffungsentscheidungen dominieren. Metas Zuweisung von 18 Milliarden USD für Inferenzinfrastruktur verdeutlicht den Schwenk vom Training zum Serving.
Edge-Bereitstellungen, die mit einer CAGR von 31,53 % wachsen, gewinnen dort an Bedeutung, wo Latenzbudgets eine Cloud-Verarbeitung mit Roundtrip ausschlie?en. Teslas Full-Self-Driving-Computer verarbeitet 2.300 Kameraframes pro Sekunde auf benutzerdefinierten Beschleunigern und demonstriert die deterministische Leistung, die Edge-Anwendungen erfordern. Industrielle Automatisierung bevorzugt ebenfalls On-Device-Inferenz, um Anforderungen an Regelkreis-Timing zu erfüllen, aber strenge Leistungshüllen schr?nken die GPU-Auswahl auf Module unter 60 Watt ein, wie den Jetson AGX Orin. Der AI Inference GPU Markt teilt sich damit in leistungsreiche Hyperscale-Einrichtungen und eingeschr?nkte Edge-Standorte auf.


Nach Formfaktor:
PCIe-Kompatibilit?t sichert Führungsposition trotz SXM-GewinnenPCIe-Karten erfassten 2025 50,44 % der AI Inference GPU Marktgr??e aufgrund der Drop-in-Kompatibilit?t mit bestehenden Servern. Dell berichtete, dass 68 % der PowerEdge AI-Lieferungen PCIe GPUs verwendeten, und Supermicro nannte eine Auslastungsrate von 92 % dank flexibler Mix-and-Match-Konfigurationen. Die Bandbreite von PCIe 5.0 mit 128 GB s?? ist für die meisten Inferenz-Jobs ausreichend, denen der All-to-All-Datenverkehr des verteilten Trainings fehlt.
SXM- und OAM-Module gewinnen in gro?en Clustern an Bedeutung, wo die Inter-GPU-Bandbreite wichtiger ist als Modularit?t. NVIDIA Blackwell NVL integriert 72 GPUs pro Rack mit einem 1,8 TB/s NVLink Switch-Fabric, das Inferenz von Modellen mit Billionen von Parametern erm?glicht. Metas Grand Teton-Server verwendet OAM, um eine um 40 % h?here Energieeffizienz als PCIe-?quivalente zu erzielen. Eingebettete Module, die mit einer CAGR von 31,78 % prognostiziert werden, passen in leistungsbeschr?nkte Edge-Ger?te; Jetson Orin NX liefert 100 TOPS INT8-Inferenz in einem 100 mm × 87 mm gro?en Formfaktor und erweitert die Bereitstellungsoptionen in autonomen Robotern und Smart-City-Kameras.
Nach Anwendung:
Generative KI treibt breite Akzeptanz voranGenerative KI hielt 2025 einen Anteil von 37,34 % an der AI Inference GPU Marktgr??e und expandiert bis 2031 mit einer CAGR von 31,75 %, was ihre rasche Integration in kundenseitige Workflows und Content-Pipelines widerspiegelt. Salesforce berichtete, dass Einstein GPT 35 % der Service-Tickets autonom l?ste, was zeigt, wie Token-Generierungs-Workloads GPUs mit Hochbandbreitenspeicher gegenüber FLOPS-zentrierten Designs bevorzugen. Adobe Firefly verarbeitete 2025 mehr als 10 Milliarden Bildgenerierungsaufrufe auf NVIDIA H100- und AMD MI300X-Flotten, die über AWS- und Azure-Regionen verteilt sind. Token-Streaming ist überwiegend speicherbegrenzt, sodass Betreiber GPUs standardisieren, die mit mindestens 192 GB HBM3 oder HBM3E ausgeliefert werden. OpenAIs Einsatz von Cerebras Wafer-Scale-Engines unterstreicht die Pr?mie, die auf Speicherlokalit?t für Modelle mit Billionen von Parametern gelegt wird.
Computer-Vision-Inferenz, die mit einer CAGR von 28,3 % w?chst, bleibt für industrielle Automatisierung, autonome Fahrzeuge und robotische Inspektion unverzichtbar. BMWs Einsatz von NVIDIA Jetson AGX Orin-Modulen in 47 Werken senkte die Falsch-Positiv-Rate bei Defekten auf unter 0,5 %. Empfehlungsmaschinen migrieren weiterhin von kollaborativem Filtern zu Transformer-Architekturen, wie die Reduzierung der Latenz durch Alibaba Clouds Hanguang 800 von 35 ms auf 12 ms w?hrend des Singles-Day-Peaks 2025 zeigt. Konversationelle KI überschneidet sich zunehmend mit generativer KI; ServiceNow nutzt Retrieval-Augmented Generation, um die mittlere Zeit bis zur L?sung zu senken. Zusammen sorgen diese Workloads für eine Nachfragevielfalt, die den AI Inference GPU Markt gegen Verlangsamungen in einzelnen Segmenten absichert.
Geografische Analyse
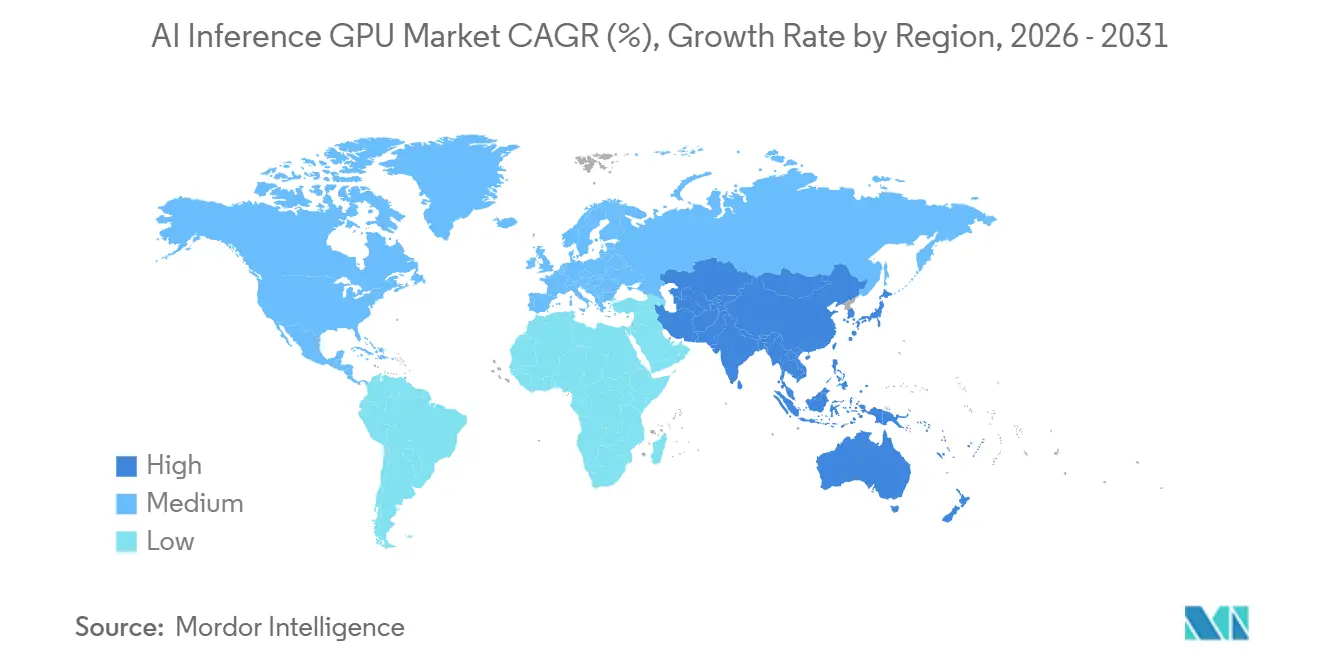
APAC KI-Inferenz-GPU-Markt
Asien-Pazifik entfiel im Jahr 2025 auf 69,52 % des Umsatzes und wird voraussichtlich bis 2031 mit einer CAGR von 31,92 % wachsen, unterstützt durch staatliche KI-Programme, Hyperscale-Partnerschaften und eine aggressive Rechenzentrumsexpansion. Huawei lieferte im Jahr 2025 mehr als 50.000 Ascend 910C-Beschleuniger aus, nachdem Exportbeschr?nkungen die Verfügbarkeit der NVIDIA H100 eingeschr?nkt hatten. Reliance Jio und NVIDIA gründeten im September 2025 ein Gemeinschaftsunternehmen, um bis Mitte 2027 100.000 H100-GPUs zu installieren, und verankerten damit Indiens Vorsto? in Richtung KI-Dienste für Unternehmen. Singapur und Thailand genehmigten im Jahr 2026 neue flüssigkeitsgekühlte Rechenzentrumsstandorte, die 800 Megawatt Kapazit?t hinzufügen und 2027 für GPU-Mieter ge?ffnet werden.
Nordamerika KI-Inferenz-GPU-Markt
Die Nachfrage nach KI-Inferenz-GPUs in Nordamerika wird von Hyperscale-Cloud-Anbietern und regulierten Unternehmen angetrieben, die lokale Inferenz bevorzugen, um Anforderungen an die Datensouver?nit?t zu erfüllen. AWS ver?ffentlichte im Juli 2025 Inferentia 3 und meldete eine um 40 % geringere Latenz für Stable-Diffusion-Pipelines nach der Migration zur TensorRT-Optimierung. JPMorgan Chase betreibt eine private Cloud mit mehr als 10.000 NVIDIA H100-GPUs, was die Pr?ferenz der Bank für eigene Infrastruktur bei compliance-sensiblen Workloads unterstreicht. Kanadische Energieunternehmen starteten Anfang 2026 Pilotprojekte mit Groq-Sprachverarbeitungseinheiten zur Echtzeit-Bohrkernprotokoll-Interpretation und signalisierten damit ein wachsendes Interesse an deterministischer Latenz-Siliziumtechnologie.
Europa KI-Inferenz-GPU-Markt
Der KI-Act der EU fügt Dokumentations- und Transparenzpflichten hinzu und verl?ngert damit die Bereitstellungszyklen. Siemens zeigte, dass Compliance erreichbar ist; seine auf Gaudi 3 basierende Simatic-KI-Plattform reduzierte die Ausfallzeiten in Halbleiterfabriken um 18 %, w?hrend die vorgeschriebenen Risikobeurteilungsoffenlegungen eingehalten wurden. Frankreich und Deutschland stellten 2 Milliarden EUR (2,18 Milliarden USD) für souver?ne Inferenz-Cloud-Programme bereit, die 2028 in Betrieb gehen sollen, was auf einen aufgestauten Bedarf hindeutet, sobald die regulatorische Klarheit verbessert wird.

Wettbewerbslandschaft
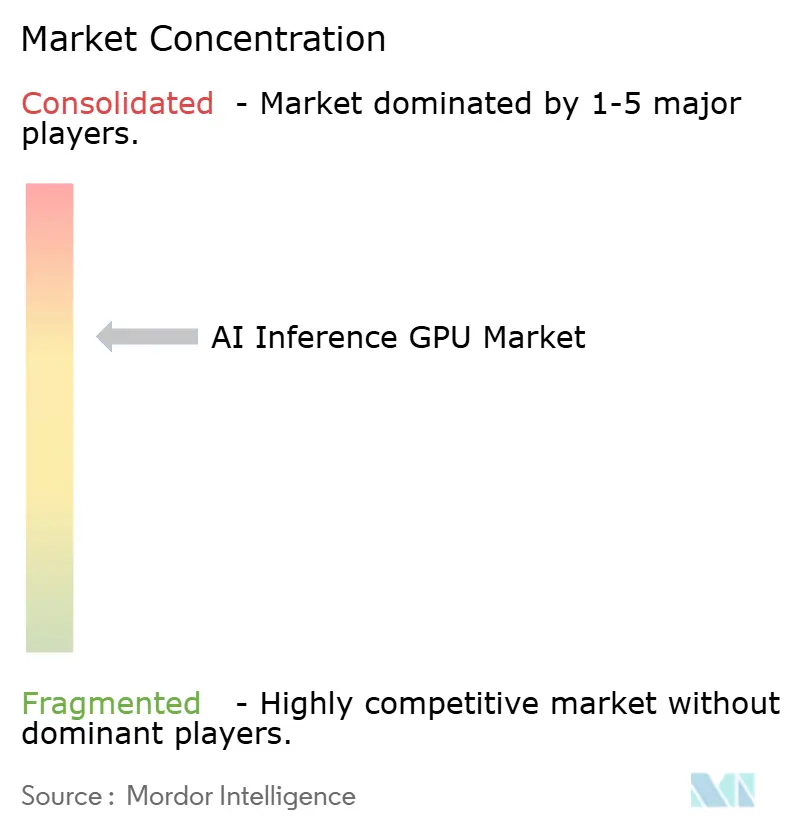
Der AI Inference GPU Markt ist m??ig konzentriert: NVIDIA kontrollierte 2025 einen bedeutenden Anteil der Rechenzentrum-Inferenz-Lieferungen, doch benutzerdefinierte ASICs und alternative GPU-Anbieter erodieren diese Dominanz. Cerebras sicherte sich einen mehrj?hrigen Liefervertrag im Wert von 15 Milliarden USD mit OpenAI für Wafer-Scale CS-3-Engines, die 1 Million Token pro Sekunde streamen und PCIe-Engp?sse eliminieren. Groq gewann einen Vertrag im Wert von 1,5 Milliarden USD mit dem Public Investment Fund Saudi-Arabiens für den Rollout deterministischer Latenz-Prozessoren, die für das Serving arabischer Sprachmodelle optimiert sind. AMDs MI350X, das im M?rz 2026 an Microsoft Azure und Oracle Cloud ausgeliefert wird, integriert 288 GB HBM3E, um Kontextfenster mit mehr als 100 Milliarden Parametern zu adressieren.
Die vertikale Integration nimmt zu. Google enthüllte TPU v7 im Dezember 2025, das einen 2,5-fachen Inferenz-Durchsatz-Sprung gegenüber TPU v6 liefert und gleichzeitig die Kosten pro Abfrage um 35 % senkt. Amazon, Microsoft und Meta finanzieren jeweils interne Silizium-Teams, um die Abh?ngigkeit von Drittanbieter-GPUs zu reduzieren. Edge-Inferenz weist eine geringere Konzentration auf; Qualcomm, Intel, Imagination Technologies und mehrere RISC-V-Startups konkurrieren unter 100-Watt-Hüllen, wo Energieeffizienz den Spitzendurchsatz überwiegt.
Open-Source-Compiler wie TensorRT, ONNX Runtime und Apache TVM gleichen das Spielfeld aus und erm?glichen es kleineren Anbietern, mit NVIDIAs Optimierungsvorsprung zu konkurrieren. AWS senkte die Stable Diffusion-Latenz Anfang 2025 nach der Einführung von TensorRT um 40 %. Aufgrund dieser Dynamik wird erwartet, dass der Preiswettbewerb ab 2027 zunimmt, wenn die Wafer-Scale-Kapazit?t steigt und Verpackungsbeschr?nkungen nachlassen.
Marktführer der AI Inference GPU Branche
-
NVIDIA Corporation
-
Advanced Micro Devices, Inc.
-
Intel Corporation
-
Qualcomm Technologies, Inc.
-
Samsung Electronics Co., Ltd.
- *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert
KI-Inferenz-GPU-Markt
- NVIDIA Corporation
- Advanced Micro Devices, Inc.
- Intel Corporation
- Qualcomm Technologies, Inc.
- Samsung Electronics Co., Ltd.
- Huawei Technologies Co., Ltd.
- Baidu, Inc.
- Microsoft Corporation
- Graphcore Ltd.
- Tenstorrent Inc.
- Mythic AI, Inc.
- Flex Logix Technologies, Inc.
- Imagination Technologies Ltd.
- Arm Holdings plc
- Cerebras Systems, Inc.

Recent Industry Developments in KI-Inferenz-GPU-Markt
- April 2026: Imagination Technologies gab bekannt, dass sein IMG Series 4 Neuronales-Netz-Beschleuniger die ISO 26262 ASIL-D-Zertifizierung erhalten hat, was seinen Einsatz in automobilen Wahrnehmungssystemen erm?glicht, die funktionale Sicherheitskonformit?t erfordern. Pilotintegrationen mit Tier-1-Zulieferern begannen im zweiten Quartal 2026.
- M?rz 2026: NVIDIA Corporation startete seine Blackwell Ultra-Inferenzplattform mit 144 GPUs pro Rack, NVLink Switch mit 3,6 TB s?? aggregierter Bandbreite und Flüssigkühlung, die den Stromverbrauch um 25 % gegenüber luftgekühlten Blackwell NVL-Setups senkt.
- M?rz 2026: Tenstorrent sicherte sich 200 Millionen USD in einer Series-D-Finanzierungsrunde unter der Führung des Samsung Catalyst Fund, um die Produktion von Grayskull- und Wormhole-Inferenzprozessoren zu skalieren, und gab Design-Wins bei japanischen und südkoreanischen Telekommunikationsbetreibern bekannt.
- Februar 2026: AMD kündigte den MI355X-Inferenzbeschleuniger mit 384 GB HBM3E und FP6-Quantisierungsunterstützung an und lieferte erste Einheiten im M?rz 2026 an Microsoft Azure und Meta Platforms.


Umfang des globalen AI Inference GPU Marktberichts
Der AI Inference GPU Marktbericht ist segmentiert nach Bereitstellungstyp (Cloud/Rechenzentrum, Edge und Eingebettet/On-Device), Formfaktor (PCIe GPUs, SXM/OAM GPUs und Eingebettete Module), Anwendung (Generative KI, Computer Vision, Empfehlungssysteme, Autonome Systeme und NLP/Konversationelle KI) sowie Geografie (Nordamerika, Europa, Asien-Pazifik, 厂ü诲补尘别谤颈办补 sowie Naher Osten und Afrika). Die Marktprognosen werden in Wertangaben (USD) bereitgestellt.
| Cloud / Rechenzentrum |
| Edge |
| Eingebettet / On-Device |
| PCIe GPUs |
| SXM / OAM GPUs |
| Eingebettete Module |
| Generative KI |
| Computer Vision |
| Empfehlungssysteme |
| Autonome Systeme |
| NLP / Konversationelle KI |
| Nordamerika | Vereinigte Staaten |
| Kanada | |
| Mexiko | |
| Europa | Deutschland |
| Vereinigtes K?nigreich | |
| Frankreich | |
| Italien | |
| ?briges Europa | |
| Asien-Pazifik | China |
| Japan | |
| 厂ü诲办辞谤别补 | |
| Indien | |
| 厂ü诲辞蝉迟补蝉颈别苍 | |
| ?briger Asien-Pazifik-Raum | |
| 厂ü诲补尘别谤颈办补 | |
| Naher Osten und Afrika |
| Nach Bereitstellungstyp | Cloud / Rechenzentrum | |
| Edge | ||
| Eingebettet / On-Device | ||
| Nach Formfaktor | PCIe GPUs | |
| SXM / OAM GPUs | ||
| Eingebettete Module | ||
| Nach Anwendung | Generative KI | |
| Computer Vision | ||
| Empfehlungssysteme | ||
| Autonome Systeme | ||
| NLP / Konversationelle KI | ||
| Nach Geografie | Nordamerika | Vereinigte Staaten |
| Kanada | ||
| Mexiko | ||
| Europa | Deutschland | |
| Vereinigtes K?nigreich | ||
| Frankreich | ||
| Italien | ||
| ?briges Europa | ||
| Asien-Pazifik | China | |
| Japan | ||
| 厂ü诲办辞谤别补 | ||
| Indien | ||
| 厂ü诲辞蝉迟补蝉颈别苍 | ||
| ?briger Asien-Pazifik-Raum | ||
| 厂ü诲补尘别谤颈办补 | ||
| Naher Osten und Afrika | ||


Im Bericht beantwortete Schlüsselfragen
Wie gro? wird der AI Inference GPU Markt bis 2031 sein?
Die AI Inference GPU Marktgr??e wird voraussichtlich bis 2031 57,29 Milliarden USD erreichen und von 2026 bis 2031 mit einer CAGR von 30,97 % wachsen.
Welcher Anwendungsbereich w?chst am schnellsten bei AI Inference GPUs?
Generative KI bleibt das am schnellsten wachsende Segment mit einer CAGR von 31,75 %, da Unternehmen gro?e Sprachmodelle in kundenseitige Tools integrieren.
Warum bevorzugen Hyperscale-Betreiber PCIe GPUs für die Inferenz?
PCIe-Karten halten 50,44 % des AI Inference GPU Marktanteils, weil sie in bestehende Server passen und in gemischten Workload-Clustern eine Auslastung von 92 % erreichen.
Welche Faktoren schr?nken KI-Inferenz am Netzwerk-Edge ein?
Enge Rack-Budgets von 500 Watt und begrenzte Kühlkapazit?t schr?nken Edge-Bereitstellungen ein und dr?ngen Anbieter zu Niedrigleistungsmodulen wie Qualcomm Snapdragon X Elite mit 15 Watt.
Wie beeinflussen Exportkontrollen die regionalen Marktdynamiken?
US-Beschr?nkungen für den Export fortschrittlicher GPUs nach China haben inl?ndische Beschleuniger wie Huaweis Ascend 910C und Alibabas Hanguang 800 gef?rdert und den Asien-Pazifik-Anteil von 69,52 % am Umsatz gest?rkt.
Welche Unternehmen führen die Entwicklung benutzerdefinierter KI-Inferenz-Silizium an?
Cerebras, Groq und Tenstorrent stehen an der Spitze der benutzerdefinierten ASIC-Welle und sichern sich Vertr?ge in Milliardenh?he für deterministische Latenz- oder Wafer-Scale-Inferenz-Engines.
Seite zuletzt aktualisiert am:



