
KI im Omics-Marktgr??e und Marktanteil
惭补谤办迟ü产别谤蝉颈肠丑迟
| Studienzeitraum | 2020 - 2031 |
|---|---|
| Marktgr??e (2026) | 1.61 Milliarden US-Dollar |
| Marktgr??e (2031) | 5.14 Milliarden US-Dollar |
| Growth Rate (2026 - 2031) | 26.09 % |
| Schnellstwachsender Markt | Asien-Pazifik |
| Gr??ter Markt | Nordamerika |
| Marktkonzentration | Mittel |
Hauptakteure
*Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert Bild ? 黑料不打烊. Wiederverwendung erfordert Namensnennung gem?? CC BY 4.0. |
|
KI im Omics-Marktanalyse von 黑料不打烊
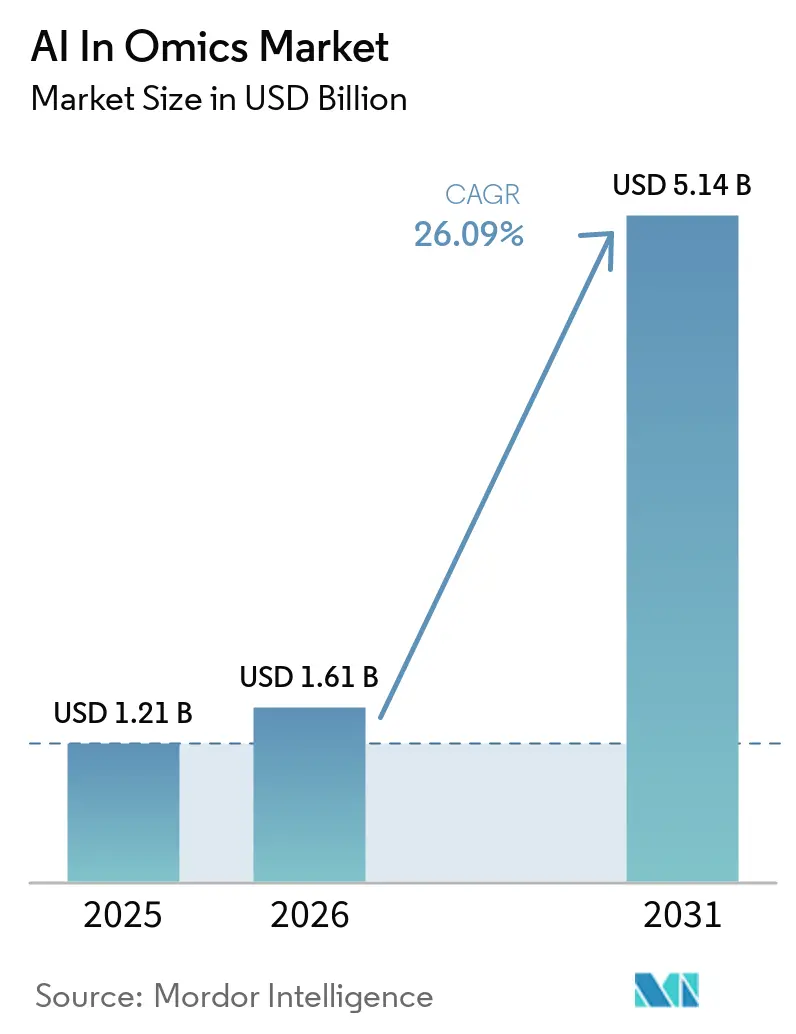
Die Gr??e des KI im Omics-Marktes wurde im Jahr 2025 auf 1,21 Milliarden USD gesch?tzt und soll von 1,61 Milliarden USD im Jahr 2026 auf 5,14 Milliarden USD bis 2031 wachsen, bei einer CAGR von 26,09 % w?hrend des Prognosezeitraums (2026–2031).
Die Expansion ist mit dem rasanten Wachstum mehrschichtiger biologischer Datens?tze, leistungsf?higeren KI-Architekturen, die hochdimensionale Omics-Eingaben verarbeiten k?nnen, und einer klaren Verlagerung der Pharmaunternehmen hin zur datengestützten Zielidentifikation und Patientenstratifizierung verbunden. Der KI im Omics-Markt wird auch durch eine wettbewerbsbedingte Aufspaltung zwischen breiten Workflow-Plattformen und tieferen Spezialgorithmen gepr?gt, was Anbieter dazu dr?ngt, Sequenzierung, Analytik und Interpretation enger zu verknüpfen. Gleichzeitig schr?nkt die fragmentierte Dateneigentümerschaft zwischen akademischen Gruppen, Krankenh?usern und unternehmenseigenen Biobanken nach wie vor die Vollst?ndigkeit der Trainingsdatens?tze ein und verlangsamt die Modellentwicklung. Die Annotationsqualit?t bleibt eine weitere Einschr?nkung für die kurzfristige Skalierung, da Atlas-Projekte noch gro?e Mengen zuverl?ssiger Zellbeschriftungen ben?tigen, bevor neuere Foundation-Modelle effektiv davon lernen k?nnen. Trotz dieser Einschr?nkungen baut der KI im Omics-Markt kumulativen Wert auf, da jeder zus?tzliche Patientendatensatz die Vorhersageleistung verbessern und die Teilnahme für den n?chsten Beitragenden attraktiver machen kann.
Wichtigste Erkenntnisse des Berichts
- Nach Komponente hielt Software im Jahr 2025 einen Umsatzanteil von 55,2 %, w?hrend Dienstleistungen bis 2031 voraussichtlich mit einer CAGR von 34,9 % wachsen werden.
- Nach Omics-Typ entfielen im Jahr 2025 35,2 % des Umsatzes auf die Genomik, die zugleich das schnellste Wachstum mit einer CAGR von 40,1 % bis 2031 verzeichnen soll.
- Nach KI-Technologie erzielte maschinelles Lernen im Jahr 2025 einen Umsatzanteil von 39,3 %, w?hrend die natürliche Sprachverarbeitung bis 2031 voraussichtlich mit einer CAGR von 32,2 % expandieren wird.
- Nach Anwendung entfielen im Jahr 2025 35,4 % des Umsatzes auf die Wirkstoffforschung und -entwicklung, w?hrend die Pr?zisionsmedizin bis 2031 voraussichtlich mit einer CAGR von 36,3 % wachsen wird.
- Nach Endnutzer hielten Pharma- und Biotechnologieunternehmen im Jahr 2025 einen Marktanteil von 45,8 % am KI im Omics-Markt, w?hrend akademische und Forschungseinrichtungen bis 2031 voraussichtlich mit einer CAGR von 35,5 % wachsen werden.
- Nach Geografie entfielen im Jahr 2025 38,2 % des Umsatzes auf Nordamerika, w?hrend Asien-Pazifik bis 2031 voraussichtlich das schnellste Wachstum mit einer CAGR von 37,4 % verzeichnen wird.
Hinweis: Die Marktgr??e und Prognosezahlen in diesem Bericht werden mithilfe des propriet?ren Sch?tzungsrahmens von 黑料不打烊 erstellt und mit den neuesten verfügbaren Daten und Erkenntnissen vom Januar 2026 aktualisiert.
Globale KI im Omics-Markttrends und Erkenntnisse
Analyse der Treiberwirkung*
| Treiber | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Zeithorizont der Auswirkung |
|---|---|---|---|
| Einführung der Pr?zisionsmedizin in der Onkologie und bei seltenen Erkrankungen | +5.3% | Global, konzentriert in Nordamerika und der EU | Mittelfristig (2–4 Jahre) |
| Steigende Omics-Datenvolumina und -komplexit?t | +4.7% | Global | Kurzfristig (≤ 2 Jahre) |
| KI-gestützte Beschleunigung der Ziel- und Biomarker-Entdeckung | +5.8% | Nordamerika und Europa, Ausstrahlungseffekte auf den APAC-Kernbereich | Mittelfristig (2–4 Jahre) |
| Ausweitung klinischer multiomischer Assays und Begleitdiagnostika | +3.9% | Nordamerika, Ausweitung auf EU und APAC | Mittelfristig (2–4 Jahre) |
| Milliarden-Zell-Atlas-Programme zur Erweiterung der Trainingskorpora | +2.4% | Nordamerika, Ausstrahlungseffekte auf die EU | Langfristig (≥ 4 Jahre) |
| F?derierte klinisch-omische Umgebungen zur Erm?glichung der Modellentwicklung | +2.8% | EU, APAC, Nordamerika | Langfristig (≥ 4 Jahre) |
| Quelle: 黑料不打烊 | |||
Einführung der Pr?zisionsmedizin ver?ndert die Wirtschaftlichkeit der Arzneimittelentwicklung
Pr?zisionsonkologie und Workflows für seltene Erkrankungen rücken die molekulare Profilierung n?her in den Mittelpunkt der therapeutischen Auswahl, was ver?ndert, wie klinische Teams entscheiden, wo sie Zeit, Kapital und Studienressourcen im KI im Omics-Markt einsetzen. Diese Verlagerung ist bedeutsam, da multiomische Modelle dazu beitragen k?nnen, Patientengruppen früher einzugrenzen, was eine bessere Abstimmung zwischen biologischem Signal, Studiendesign und nachgelagerter Behandlungsreaktion unterstützt. Die Lens-Plattform von Tempus AI zeigt, dass dieses Modell kommerziell skaliert, wobei der Umsatz im Bereich Daten und Anwendungen im Jahr 2025 316,4 Millionen USD erreichte, ein Anstieg von 30,9 % im Jahresvergleich. Tempus meldete au?erdem einen Gesamtumsatz von 1,3 Milliarden USD für 2025, was darauf hindeutet, dass KI-verknüpfte klinische und Datendienste über isolierte Pilotprojekte hinausgehen und in wiederholbare Betriebsmodelle übergehen. Da diese Workflows früher in der Entwicklung eingesetzt werden, k?nnen krankheitsspezifische Pathway-Erkenntnisse über verwandte Programme hinweg wiederverwendet werden, was die kommerzielle Rendite jedes kuratierten Datensatzes verbessert. Dies tr?gt dazu bei, dass der KI im Omics-Markt gleichzeitig Ausgaben von Wirkstoffforschungsgruppen, translationalen Forschern und klinisch ausgerichteten Softwareanbietern anzieht.
Steigende Omics-Datenvolumina belasten die veraltete Analyseinfrastruktur
Steigende Datenvolumina bleiben ein grundlegender Wachstumsmotor für den KI im Omics-Markt, da mehrschichtige biologische Datens?tze für viele veraltete Analysesysteme zu gro? und zu komplex werden. Moderne Projekte arbeiten selten mit einer einzigen Modalit?t isoliert, sodass Sequenz-, Expressions-, Protein-, Ph?notyp- und klinische Kontextdaten h?ufig gemeinsam innerhalb derselben Rechenumgebung verarbeitet werden müssen. Dies erzeugt Druck nicht nur auf die Speicherung, sondern auch auf Vorverarbeitung, Harmonisierung, Inferenzgeschwindigkeit, Validierungsverfolgung und Neutrainingskapazit?t, da kontinuierlich neue Datens?tze eintreffen. NVIDIA gibt an, dass Parabricks eine mehr als 100-mal schnellere Gesamtgenomanalyse bei 50 % niedrigeren Rechenkosten als CPU-Workflows erm?glichen kann, was zeigt, warum beschleunigte und Cloud-f?hige Pipelines an Beliebtheit gewinnen. Sobald sich eine Institution für diesen Technologie-Stack entschieden hat, wird eine Migration schwieriger, da Datenmodelle, Validierungsroutinen und Nutzergewohnheiten an die Plattformarchitektur gebunden werden. Deshalb bewegt sich der KI im Omics-Markt weg von eigenst?ndigen Tools hin zu integrierten Umgebungen, die Rechenleistung, Analytik und Workflow-Management in einer einzigen Schicht kombinieren.
KI verkürzt die Pipeline von der Biomarker-Entdeckung bis zur klinischen Studie
Der KI im Omics-Markt profitiert auch von einem kürzeren Weg zwischen Biomarker-Entdeckung, Patientenauswahl und klinischer Testung, was seit Langem einer der schwierigsten Engp?sse in der translationalen Medizin war. Cancer Cell berichtete, dass kontrastives Lernen auf multiomischen Datens?tzen die Patientenauswahl in einer retrospektiven Analyse verbesserte und das ?berlebensrisiko im Vergleich zur ursprünglichen Phase-III-Studienpopulation um 15 % reduzierte. Dieselbe Studie stellte fest, dass validierte pr?diktive Biomarker mit einer doppelt so hohen Zulassungswahrscheinlichkeit verbunden sind, obwohl viele Onkologieprogramme noch in der Entwicklung scheitern. Dies ver?ndert die Wirtschaftlichkeit der Entdeckung, da Unternehmen Kapital früher auf besser abgestimmte Patientenuntergruppen lenken k?nnen, anstatt diese Grenzen erst nach kostspieliger Sp?tphasenarbeit zu erkennen. Es erh?ht auch den Wert longitudinaler propriet?rer Datens?tze, da wiederholte Messungen sowohl die Biomarker-Konfidenz als auch die Modellgeneralisierbarkeit über Kohorten hinweg verbessern. Infolgedessen bevorzugt der KI im Omics-Markt Unternehmen, die einzigartigen Datenzugang, klinischen Kontext und einsatzf?hige Modellierungssysteme kombinieren, gegenüber solchen, die nur allgemeine Analytik anbieten.
Begleitdiagnostika integrieren KI-Omics in regulatorische Workflows
Die Ausweitung klinischer multiomischer Assays verwandelt den KI im Omics-Markt in einen st?rker regulierten und erstattungsf?higeren Betriebsraum, was ver?ndert, welche Art von Anbietern skalieren kann. Die US-amerikanische Food and Drug Administration genehmigte Guardant360 CDx im September 2025 als Begleitdiagnostikum für Inluriyo von Eli Lilly, was die sechste Begleitdiagnostik-Zulassung des Tests markierte[1]U.S. Food and Drug Administration, "P200010/S021: Guardant360? CDx," U.S. Food and Drug Administration, accessdata.fda.gov.. Die Beh?rde lie? im Juli 2025 auch den Oncomine Dx Express Test als Begleitdiagnostikum für Sunvozertinib zu. Sein Predetermined Change Control Plan ist wichtig, da er einen strukturierten Weg für Markt-Updates von KI-gestützter Variantenaufruf-Software schafft, ohne einen vollst?ndigen Neustart des Validierungsansatzes zu erfordern. Dies verringert einige betriebliche Reibungspunkte für etablierte Anbieter, die bereits über Qualit?tssysteme, Dokumentationsprozesse und Post-Market-Monitoring verfügen. Im KI im Omics-Markt begünstigt dies zunehmend Unternehmen, die Assay-Leistung mit konformer Software-Wartung und evidenzgestützten Update-Zyklen verbinden k?nnen.
Analyse der Hemmnisauswirkungen*
| Hemmnis | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Zeithorizont der Auswirkung |
|---|---|---|---|
| Datenschutz-, Einwilligungs- und Cybersicherheitsbeschr?nkungen | -3.6% | Global, am st?rksten in der EU und den USA | Kurzfristig (≤ 2 Jahre) |
| Lücken bei der Standardisierung und Interoperabilit?t multiomischer Daten | -2.4% | Global, am ausgepr?gtesten in APAC und Schwellenm?rkten | Mittelfristig (2–4 Jahre) |
| Compliance-Belastung durch den EU-KI-Act und den EHDS | -2.1% | EU prim?r, indirekte Auswirkungen auf globale Akteure | Mittelfristig (2–4 Jahre) |
| Engp?sse bei der Atlas-Skalenannotation und Beschriftungsqualit?t | -1.5% | Global | Langfristig (≥ 4 Jahre) |
| Quelle: 黑料不打烊 | |||
Datenschutz- und Einwilligungsbeschr?nkungen fragmentieren Trainingsdatens?tze
Datenschutz- und Einwilligungsregeln hindern den KI im Omics-Markt daran, alle generierten Daten zu nutzen, selbst wenn der wissenschaftliche Wert dieser Datens?tze hoch ist. Gesamtgenomsequenzen lassen sich nicht so einfach anonymisieren wie viele andere klinische Datens?tze, sodass Institutionen nach wie vor strengen Governance-Erwartungen hinsichtlich Zugang, Speicherung, Verknüpfung und Sekund?rnutzung gegenüberstehen. Die Europ?ische Kommission gibt an, dass die EHDS-Verordnung im M?rz 2026 in Kraft getreten ist und die Sekund?rnutzung genomischer, proteomischer, transkriptomischer, metabolomischer und epigenomischer Daten abdeckt, die nationalen Gesundheitsdaten-Zugangsstellen jedoch erst schrittweise operativ werden[2]Europ?ische Kommission, "Verordnung über den Europ?ischen Gesundheitsdatenraum," Europ?ische Kommission, europa.eu.. Das bedeutet, dass der kurzfristige Zugang uneinheitlich bleibt, da lokale Einwilligungsregeln, rechtliche Prüfungen und Sicherheitsanforderungen die Zusammenstellung von Datens?tzen über mehrere Standorte hinweg weiterhin verlangsamen. Das am schwierigsten zug?ngliche Material umfasst h?ufig unterrepr?sentierte Abstammungsgruppen, was Verzerrungen vertiefen kann, wenn Modelle auf engeren und weniger repr?sentativen Kohorten trainiert werden. F?deriertes Lernen kann dem KI im Omics-Markt helfen, den zentralen Datentransfer zu reduzieren, h?ngt jedoch weiterhin von gemeinsamer Governance, kompatiblen Workflows und zuverl?ssiger Koordination zwischen Institutionen ab.
Lücken bei der Standardisierung multiomischer Daten schr?nken die plattformübergreifende Interoperabilit?t ein
Standardisierungslücken sind ein weiteres Hemmnis für den KI im Omics-Markt, da Multi-Omics-Produkte auf Daten angewiesen sind, die sauber zwischen Laboren, Plattformen und Analyseumgebungen übertragen werden k?nnen. Scientific Reports stellte fest, dass eine Bewertung von 10.109 ?ffentlichen Omics-Datens?tzen über 16 Datentypen hinweg ergab, dass biologische Metainformationen stark heterogen und nicht standardisiert blieben. Die gleiche Fragmentierung ist besonders schwierig in der Proteomik und Metabolomik, wo Plattformauswahl, Probenvorbereitung und Normalisierungspraktiken starke Batch-Effekte erzeugen, die die Modellübertragbarkeit schw?chen k?nnen. Anbieter investieren daher erheblich in interne Harmonisierungsschichten, bevor sie Modelle in gro?em Ma?stab über verschiedene Kohorten hinweg trainieren, benchmarken und validieren k?nnen. Diese Schritte erh?hen die Entwicklungskosten und verl?ngern die Zeitpl?ne, was eine schwerere Belastung für kleinere Anbieter darstellt, die nicht über breite Informatikteams oder lange Implementierungszyklen verfügen. Im KI im Omics-Markt ist Interoperabilit?t daher eine direkte Einschr?nkung der Kommerzialisierungsgeschwindigkeit und nicht nur eine technische Unannehmlichkeit.
*Unsere Prognosen behandeln die Auswirkungen von Treibern und Einschr?nkungen als richtungsweisend und nicht additiv. Die Wirkungsprognosen berücksichtigen Basiswachstum, Mischungseffekte und Wechselwirkungen zwischen Variablen.
Segmentanalyse
Nach Komponente: Dienstleistungen gewinnen an Wert, da die KI-Komplexit?t zunimmt
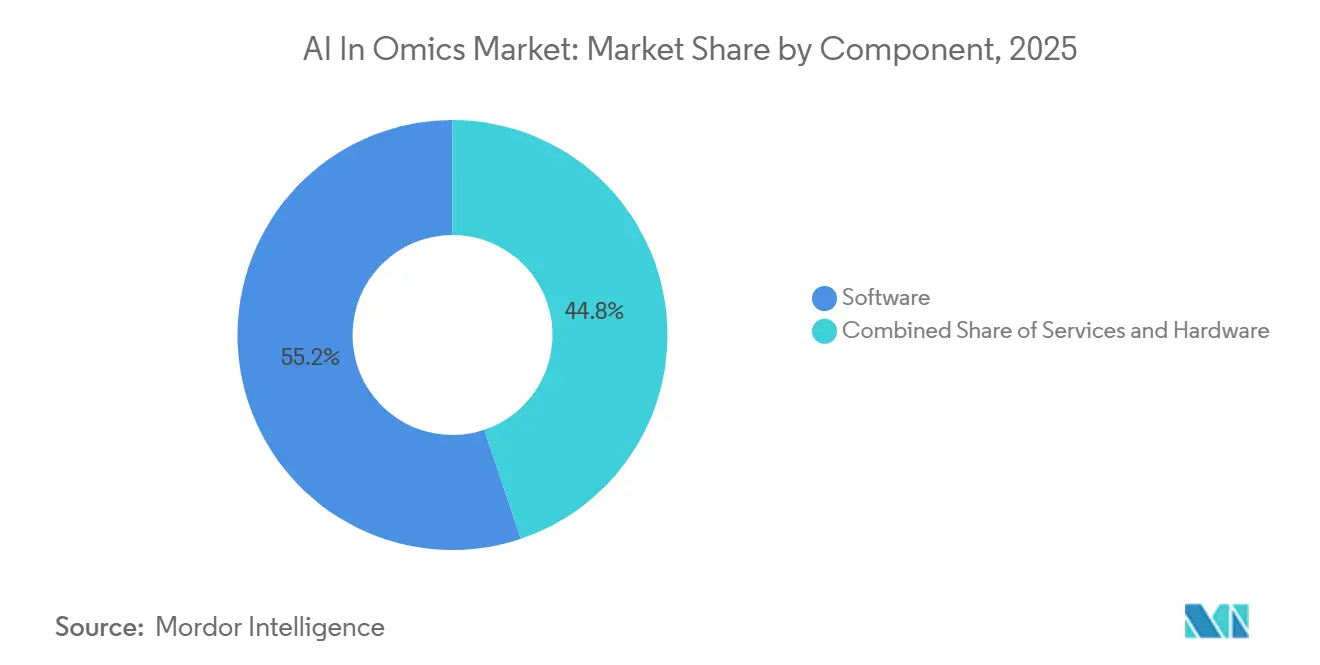
Software machte 55,2 % des Umsatzes im Jahr 2025 aus, was sie zur gr??ten Komponente im KI im Omics-Markt machte und die St?rke der plattformgestützten Kommerzialisierung widerspiegelte. Dieser Vorsprung resultierte aus Cloud-basierten Umgebungen, die vorgefertigte Pipelines, kuratierte Wissensschichten, Rechenzugang und Visualisierungstools in einem einzigen Betriebssystem für die Omics-Analyse kombinieren. Für viele Nutzer reduziert dies die Notwendigkeit, interne Infrastruktur aufzubauen, bevor mit der Multi-Omics-Arbeit begonnen wird, was die Einführung für Teams erleichtert, die über Daten, aber begrenzte Engineering-Kapazit?ten verfügen. Es verkürzt auch die Zeit bis zur Nutzung, da Analysten von Rohdateien zur Interpretation innerhalb eines einzigen Workflows übergehen k?nnen, anstatt mehrere Tools zusammenzufügen. Hardware blieb die kleinste Komponente, da mehr analytische Workloads nun von lokalen Instrumenten getrennt und in skalierbare Remote-Umgebungen verlagert werden.
Dienstleistungen sollen bis 2031 mit einer CAGR von 34,9 % wachsen, was sie zur am schnellsten wachsenden Komponente der KI im Omics-Marktgr??e macht und zeigt, wohin sich die inkrementelle Wertsch?pfung verlagert. Die Nachfrage verlagert sich hin zu kundenspezifischer Modellentwicklung, Bioinformatik-Beratung, Workflow-Management und langzyklischer Datenintegrationsunterstützung, da Projekte schwieriger über Institutionen und Anwendungsf?lle hinweg zu standardisieren werden. QIAGEN gab an, dass sein Digital Insights-Gesch?ft im Gesch?ftsjahr 2025 ein zweistelliges Wachstum zu konstanten Wechselkursen erzielte und dass das Unternehmen bis 2028 mindestens 14 KI-gestützte Anwendungen plant. Das ist bedeutsam, weil die KI im Omics-Branche wiederkehrende Servicenachfrage rund um Software-Kerne schafft, insbesondere dort, wo Nutzer nach der Erstbereitstellung Validierung, Neutraining, regulatorische Dokumentation und Workflow-Anpassung ben?tigen. Da KI-Tools tiefer in regulierte und klinisch verknüpfte Umgebungen vordringen, wird externe Unterstützung weniger optional und st?rker in das t?gliche Betriebsmodell eingebettet.
Notiz: Segmentanteile aller einzelnen Segmente sind nach dem Berichtskauf verfügbar


Nach Omics-Typ: Genomik verankert den Stack mit wachsender mehrschichtiger Tiefe
Die Genomik hielt im Jahr 2025 einen Umsatzanteil von 35,2 % und soll bis 2031 mit einer CAGR von 40,1 % expandieren, was bedeutet, dass sie im KI im Omics-Markt sowohl beim Umfang als auch beim Wachstum führend ist. Diese Position spiegelt ihre Rolle als Basisschicht für die meisten Multi-Omics-Workflows wider, da genomische Sequenzen h?ufig als Ausgangsrahmen für die Verknüpfung nachgelagerter Expressions-, Protein- und Ph?notypsignale dienen. Bev?lkerungsweite Sequenzierung und die breitere Nutzung Biobank-verknüpfter Forschung vergr??ern weiterhin die für die Modellentwicklung verfügbare Trainingsbasis, was die Genomik als die kommerziell zentralste Omics-Schicht st?rkt. Transkriptomik und Proteomik gewinnen als komplement?re Schichten an Bedeutung, da sie funktionalen Kontext hinzufügen, den Sequenzdaten allein in klinischen und arzneimittelentwicklungsbezogenen Umgebungen nicht liefern k?nnen. Metabolomik und Epigenomik bleiben umsatzm??ig kleiner, aber das Forschungsinteresse steigt weiter, da beide Schichten dazu beitragen, ph?notypische Variabilit?t zu erkl?ren, die Sequenzver?nderungen allein nicht vollst?ndig erfassen.
Der KI im Omics-Markt konzentriert sich weiterhin auf die Genomik, da neue multimodale Modelle in der Regel mit Sequenzdaten beginnen und dann andere biologische Schichten hinzufügen, wenn sich der Kontext erweitert. NVIDIA gab an, dass Evo 2 ein genomisches Foundation-Modell mit 40 Milliarden Parametern ist, das auf 8,85 Billionen Nukleotiden aus mehr als 128.000 Genomen trainiert wurde. Diese Gr??enordnung unterstützt die Ansicht, dass genomische Sequenzen zum prim?ren Substrat für gr??ere biologische Foundation-Modelle werden, die sp?ter transkriptomischen, proteomischen und klinischen Kontext aufnehmen k?nnen. Innerhalb der KI im Omics-Branche h?lt dies die Genomik im Mittelpunkt des Produktdesigns, des langfristigen Modelltrainings und der Datenlizenzierungspriorit?ten entlang der gesamten Wertsch?pfungskette. Es bedeutet auch, dass Anbieter, die bereits hochwertige genomische Workflows kontrollieren, einen wichtigen Ausgangsvorteil haben, da sich breitere Multi-Omics-Plattformen weiterentwickeln.
Nach KI-Technologie: Maschinelles Lernen dominiert, NLP entwickelt sich zum strategischen Differenzierungsmerkmal
Maschinelles Lernen machte 39,3 % des Umsatzes im Jahr 2025 aus und war damit das gr??te KI-Technologiesegment im KI im Omics-Markt, was unterstreicht, wie etabliert diese Methoden bereits im operativen Einsatz sind. Sein Vorsprung resultierte aus Variantenaufruf, Biomarker-Entdeckung, Patientenstratifizierung und verwandten Aufgaben, bei denen Produktions-Workflows bereits validiert und von Laboren und Forschungsteams übernommen wurden. Deep Learning hat diese Position in Umgebungen gest?rkt, in denen Mustererkennung wichtiger ist als manuell entwickelte Merkmale, insbesondere da Datens?tze gr??er und für einfachere Ans?tze weniger handhabbar werden. Computer Vision und Data Mining bleiben kleinere Umsatzpools, aber r?umliche Omics macht bildverknüpfte Analysen sowohl in der Forschung als auch in der translationalen Anwendung zunehmend wichtiger. Da die Mischung der Datentypen breiter wird, geht die Technologieführerschaft weniger um eine Algorithmusklasse und mehr darum, wie gut jede Methode zur Evidenzstruktur eines bestimmten Workflows passt.
Natürliche Sprachverarbeitung soll bis 2031 mit einer CAGR von 32,2 % wachsen, der schnellsten Rate unter den KI-Technologiegruppen im KI im Omics-Markt, und ein Zeichen dafür, dass textlastige Evidenzschichten kommerziell relevanter werden. Ein gro?er Teil des nutzbaren Kontexts zu Varianten, Wirkstoff-Gen-Interaktionen, Krankheitsmechanismen und Studieneignung liegt noch in unstrukturierter Literatur, regulatorischem Material und klinischen Notizen statt in übersichtlichen Analysetabellen. DBCLS berichtete im Mai 2026, dass Japans ChatTogoVar GPT-4o bei der Interpretation genomischer Varianten in einer in Human Genome Variation ver?ffentlichten Studie übertraf. Das ist bedeutsam, weil eine st?rkere Extraktion und Interpretation von Text die für nachgelagerte molekulare Modelle verfügbare Evidenz erweitern kann, ohne auf v?llig neue Nasslab-Datengenerierung warten zu müssen. In der Praxis wird NLP zu einem Differenzierungsmerkmal für Anbieter, die interpretierbare, klinisch nützliche Ergebnisse anstatt nur pr?diktiver Scores anbieten m?chten.
Nach Anwendung: Wirkstoffforschung führt, Pr?zisionsmedizin beschleunigt sich
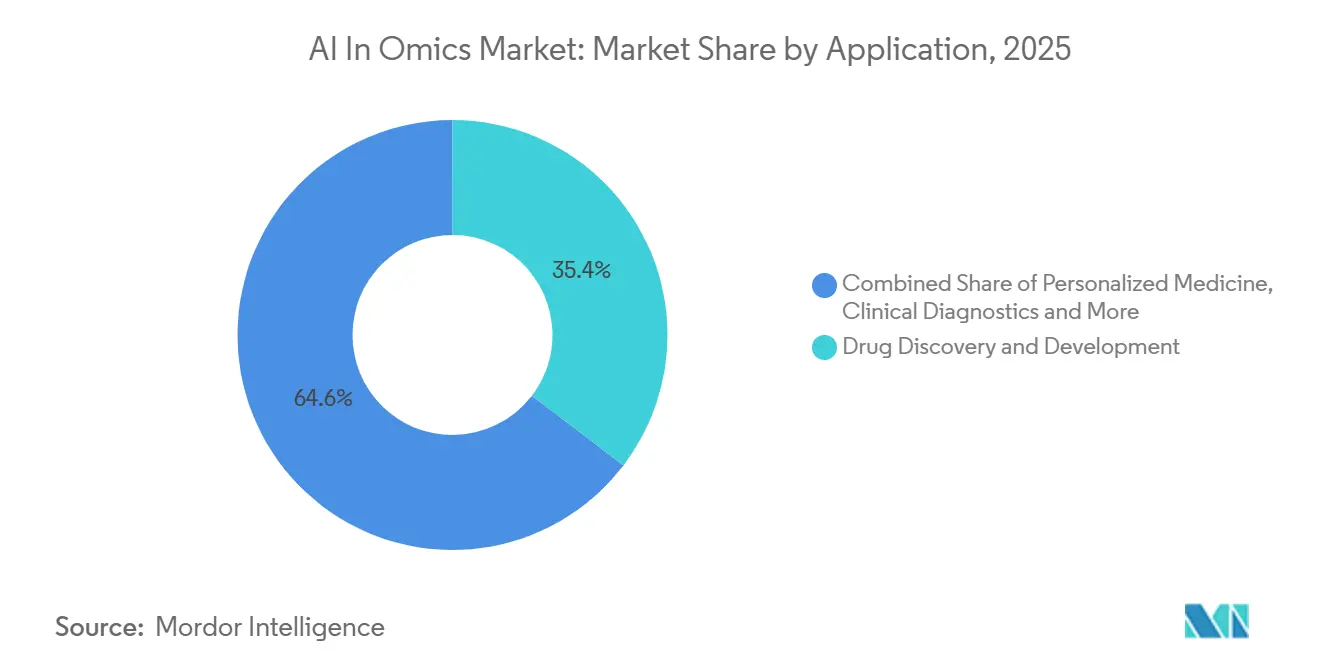
Wirkstoffforschung und -entwicklung machte 35,4 % des Umsatzes im Jahr 2025 aus, was sie zur gr??ten Anwendung im KI im Omics-Markt machte und die pharmazeutische Forschung und Entwicklung im Mittelpunkt der Ausgaben hielt. Das Segment bleibt gro?, weil Arzneimittelentwickler frühe Anwender von Multi-Omics-Analytik waren und diese Tools weiterhin zur Verbesserung der Zielauswahl, Biomarkerstrategie und Studiengestaltung nutzen. Tempus meldete 316,4 Millionen USD Umsatz im Bereich Daten und Anwendungen im Jahr 2025, was das Ausma? der Nachfrage nach datenverknüpften Analyseplattformen zeigt, die Forschungs- und Entwicklungsprogramme unterstützen. Klinische Diagnostik, Biomarker-Entdeckung und Zielidentifikation machen den Rest des Anwendungsmix aus, und jede profitiert, wenn die Patientenstratifizierung pr?ziser und einfacher zu operationalisieren wird. Solange die Produktivit?t in der Forschung und Entwicklung ein zentrales Anliegen bleibt, werden Entdeckungsprogramme wahrscheinlich weiterhin einen gro?en Anteil der kommerziellen Ausgaben bei Plattform- und Dienstleistungsanbietern absorbieren.
Pr?zisionsmedizin soll bis 2031 mit einer CAGR von 36,3 % expandieren, dem schnellsten Tempo unter den Anwendungen im KI im Omics-Markt, und ein Zeichen dafür, dass molekulare Profilierung in eine breitere klinische Nutzung übergeht. Dies spiegelt eine Bewegung über die Sp?tphasen-Onkologie hinaus hin zu früheren und breiteren Workflows in der Onkologie und anderen Krankheitsbereichen wider, in denen molekularer Kontext die Versorgung direkter leiten kann. Tempus gab Anfang 2026 an, dass sein pankanzer?ser HRD-Algorithmus RNA-Expressionsdaten verwendet, um Patienten zu identifizieren, die m?glicherweise von PARP-Inhibitoren über das traditionelle DNA-only-Testing hinaus profitieren. Dieser Ansatz erh?ht den Wert bestehender Datens?tze, da er die Patientenauswahl erweitert, ohne vollst?ndig neue Probenentnahmerunden zu erfordern. Langfristig sollte dies die klinische Nachfrage weiterhin in Richtung Tools treiben, die molekulare Details, Erkl?rbarkeit und einsatzf?hige Software in einem einzigen Angebot kombinieren k?nnen.
Notiz: Segmentanteile aller einzelnen Segmente sind nach dem Berichtskauf verfügbar
Nach Endnutzer: Pharma verankert den Umsatz, Wissenschaft treibt die Modellentwicklung voran
Pharma- und Biotechnologieunternehmen erzielten im Jahr 2025 einen Umsatzanteil von 45,8 %, was ihnen den gr??ten Platz im KI im Omics-Markt sicherte und ihre Rolle als Hauptk?ufer datenreicher Analysel?sungen widerspiegelte. Ihr Vorsprung resultiert aus dem Druck, Entwicklungszeitpl?ne zu verkürzen, die Zielqualit?t zu verbessern, Ausgaben für gescheiterte Studien zu reduzieren und früher in der Pipeline st?rkere Biomarkerstrategien aufzubauen. Diese K?ufer verfügen auch über die Budgets, um Multi-Omics-Daten zu lizenzieren, integrierte Plattformen einzusetzen und Ergebnisse in Umgebungen zu validieren, die h?ufig h?here Standards für Rückverfolgbarkeit und Dokumentation erfordern. Krankenh?user und klinische Labore bilden die n?chste Nachfrageschicht, da wachsende genomische Testvolumina die t?gliche Versorgung enger mit den Datenpipelines verknüpfen, die das Modelltraining und die Verfeinerung speisen. Diese klinische Verbindung ist wichtig, weil routinem??ige Sequenzierungs- und Liquid-Biopsy-Workflows reale Evidenz für kommerzielle und akademische Nutzer kontinuierlich auffrischen k?nnen.
Akademische und Forschungseinrichtungen sollen bis 2031 mit einer CAGR von 35,5 % wachsen, dem schnellsten Tempo unter den Endnutzern im KI im Omics-Markt, und ein Zeichen dafür, dass sich die Modellentwicklungskapazit?t über kommerzielle K?ufer hinaus ausbreitet. Deutschlands MoReHealth Niedersachsen-Initiative wurde 2025 als 3 Millionen EUR (3,49 Millionen USD) Multi-Omics-Programm gestartet, das KI-gestützte Tools über 4 Institutionen hinweg integriert. Dies zeigt, dass ?ffentliche Forschungsfinanzierung koordinierte Datengenerierungsnetzwerke anstelle isolierter Laborprojekte aufbaut, was langfristig gr??ere und wiederverwendbarere Datens?tze unterstützt. In der KI im Omics-Branche st?rkt dieses akademische Wachstum das Angebot an Trainingsdaten, Validierungskohorten und translationalen Partnerschaften, auf die kommerzielle Anbieter sp?ter angewiesen sind. Auftragsforschungsorganisationen blieben das kleinste Endnutzersegment, aber ihre Rolle nimmt weiterhin zu, wo Auftraggeber Modellentwicklung, Validierung und Assay-Unterstützung in einem einzigen externen Engagement gebündelt haben m?chten.
Geografische Analyse
Nordamerika hielt im Jahr 2025 einen Marktanteil von 38,2 % am KI im Omics-Markt, was es zum gr??ten regionalen Umsatzpool machte und die Konzentration von Sequenzierungsinfrastruktur, KI-Talenten und pharmazeutischen Forschungsausgaben in einem ?kosystem widerspiegelte. Die Vereinigten Staaten treiben diesen Vorsprung voran, da klinische Genomik-Netzwerke, datenorientierte Softwareunternehmen, akademische medizinische Zentren und gro?e Arzneimittelentwickler bereits eng miteinander verbunden sind. Tempus meldete 1,3 Milliarden USD Umsatz im Jahr 2025, ein Anstieg von 83,4 % im Jahresvergleich, was das Kommerzialisierungsausma? veranschaulicht, das das US-amerikanische Umfeld unterstützen kann, wenn klinische Daten, Analytik und Zahlervertrautheit zusammenpassen. Die Begleitdiagnostik-Entscheidungen der US-amerikanischen Food and Drug Administration im Jahr 2025 zeigten auch, dass KI-verknüpfte molekulare Tests erkennbare regulatorische Wege durchlaufen k?nnen, wenn Evidenzpakete stark sind. Diese Kombination aus Infrastrukturtiefe, Erstattungsvertrautheit und regulatorischer Erfahrung h?lt Nordamerika bei der Bereitstellungsgeschwindigkeit im gesamten KI im Omics-Markt vorne.
Europa bleibt eine wichtige Region im KI im Omics-Markt, auch wenn seine Politikstruktur sowohl eine l?ngerfristige Datennutzung erm?glicht als auch kurzfristige Compliance-Kosten für viele Teilnehmer erh?ht. Die Europ?ische Kommission gibt an, dass die EHDS-Verordnung im M?rz 2026 in Kraft getreten ist und die Sekund?rnutzung genomischer, proteomischer, transkriptomischer, metabolomischer und epigenomischer Daten abdeckt. Deutschlands genomDE-Modellprojekt hatte bis Herbst 2024 mehr als 5.000 Patienten integriert und zielt auf 100.000 Gesamtgenomsequenzen über 5 Jahre ab[3]Deutsches ?rzteblatt, "Genomsequenzierung Auf Dem Weg in Die Regelversorgung," Deutsches ?rzteblatt, aerzteblatt.de.. Diese Programme sollten die nutzbare Datenbasis der Region langfristig erweitern, aber die operative Belastung durch den EU-KI-Act und damit verbundene Governance-Schritte begünstigt weiterhin besser etablierte Anbieter.
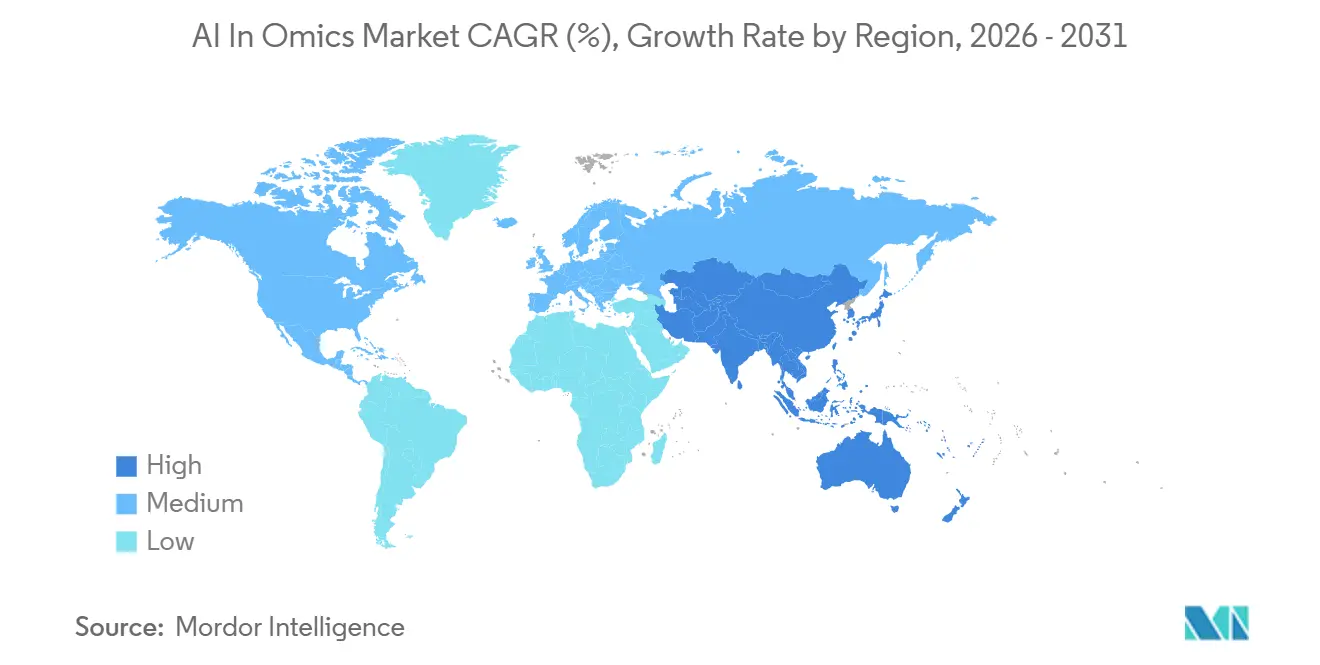
Asien-Pazifik soll mit einer CAGR von 37,4 % wachsen, was ihm die schnellste regionale Expansion in der KI im Omics-Marktgr??e bis 2031 verleiht und auf wachsenden Schwung bei staatlich gef?rderten Genomik- und digitalen Gesundheitsprogrammen hinweist. Dieses Tempo spiegelt Bemühungen gro?er asiatischer Volkswirtschaften wider, lokale Sequenzierungskapazit?ten aufzubauen, klinische Datensysteme zu st?rken und die Abh?ngigkeit von westlichen, abstammungsverzerrten Trainingsdatens?tzen zu verringern. Japan zeigt auch eine aktive ?bertragung von Sprachmodellen in die Genomik, wobei DBCLS 2026 berichtete, dass ChatTogoVar GPT-4o bei der Interpretation genomischer Varianten übertraf. 厂ü诲补尘别谤颈办补 sowie der Nahe Osten und Afrika sind heute noch kleiner, aber eine bessere Gesundheitsinfrastruktur und wachsende Start-up-Aktivit?ten sollten die künftigen Einführungsm?glichkeiten schrittweise erweitern.

Wettbewerbslandschaft
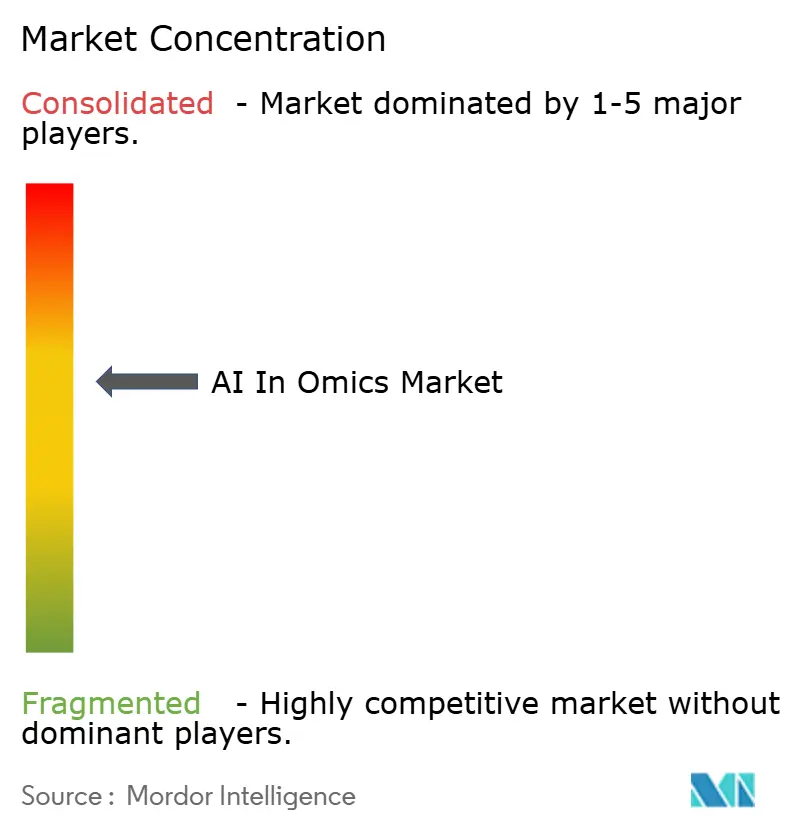
Der KI im Omics-Markt ist auf Plattformebene m??ig konsolidiert, bleibt jedoch über engere Anwendungsnischen hinweg fragmentiert, was eine Marktstruktur schafft, in der Gr??e wichtig ist, Spezialisierung jedoch in vielen Anwendungsf?llen noch gewinnt. Gro?e workflow-orientierte Unternehmen wie Illumina, Thermo Fisher Scientific, QIAGEN und NVIDIA konkurrieren bei Integration, Durchsatz, Infrastrukturreichweite und der F?higkeit, Datengenerierung mit nachgelagerter Analyse zu verbinden. KI-native Unternehmen wie Tempus AI und SOPHiA GENETICS konkurrieren st?rker auf Modelltiefe, multimodalen Datenbest?nden und klinischer Interpretationsqualit?t, insbesondere dort, wo Entscheidungsunterstützung und regulierter Einsatz am wichtigsten sind. Diese Aufspaltung bedeutet, dass kein einzelnes Unternehmen den gesamten Stack kontrolliert, obwohl eine begrenzte Anzahl von Unternehmen die skalierbarsten Plattformen und die wiederverwendbarsten Analyseumgebungen verankert. Die st?rkste strategische Richtung ist die vertikale Integration, wobei Anbieter versuchen, ?bergabepunkte zwischen Sequenzierung, Berechnung, Interpretation und klinischer oder Forschungsma?nahme zu reduzieren.
Tempus hat dieses Modell im Jahr 2026 durch Kooperationen und Produkterweiterungen gest?rkt, die propriet?re Datenbest?nde mit praktischen klinischen und Forschungs-Workflows verbinden. Im April 2026 kündigten Tempus und die University of Southern California eine strategische Zusammenarbeit zur F?rderung der KI-gestützten Pr?zisionsmedizin an. Tempus hob auch seinen pankanzer?sen HRD-Algorithmus und das anhaltende Wachstum in seinem Daten- und Anwendungsgesch?ft hervor, was einen Versuch zeigt, sowohl die Produktschicht als auch die Evidenzschicht gleichzeitig zu vertiefen. Diese Schritte sind im KI im Omics-Markt bedeutsam, weil sie die Software-Leistung an propriet?ren klinischen Kontext knüpfen, anstatt nur an eigenst?ndige Analysetools.
Andere führende Unternehmen bauen ebenfalls breitere Kontrollpunkte rund um den KI im Omics-Markt auf. Illumina gab im Februar 2026 an, dass es KI-gestützte Exploration in die multiomische Analyse bringt, was seinen Vorsto? unterstützt, die Sequenzierungsausgabe enger mit der nachgelagerten Interpretation zu verbinden. QIAGEN gab im M?rz 2026 an, dass sein Digital Insights-Gesch?ft mit einem zweistelligen Wachstum zu konstanten Wechselkursen w?chst und dass bis 2028 mindestens 14 KI-gestützte Anwendungen geplant sind. NVIDIA positioniert BioNeMo weiterhin als grundlegende Schicht für die Modellentwicklung in den Biowissenschaften, was es erm?glicht, Wert auf der Ebene der Rechen- und Modellinfrastruktur zu erfassen, anstatt nur in fertigen Anwendungen.
Marktführer im KI im Omics-Bereich
-
Agilent Technologies
-
Illumina, Inc.
-
QIAGEN
-
Tempus AI
-
Thermo Fisher Scientific
- *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert

Aktuelle Branchenentwicklungen
- Mai 2026: Tempus AI erweiterte seine Partnerschaft mit Bristol Myers Squibb, um klinische Studiendesigns zu verbessern und den regulatorischen Erfolg in der soliden Tumor-Onkologie und Neurowissenschaft zu steigern. Dies baut auf seinen Kooperationen mit Merck, Daiichi Sankyo und Gilead im Jahr 2026 auf.
- Mai 2026: SOPHiA GENETICS kooperierte mit Synnovis, um KI-gestützte Liquid-Biopsy-Tests für Lungen- und Brustkrebspatienten im Vereinigten K?nigreich im Rahmen des Blood-test-first-Programms von NHS England einzuführen. Die Initiative zielt darauf ab, j?hrlich 7.000 Tests durchzuführen, was etwa ein Drittel der ctDNA-Tests in England abdeckt.
- April 2026: Illumina brachte DRAGEN v4.5 auf den Markt, ein Tool für maschinelles Lernen, das FFPE-bedingte falsch-positive Ergebnisse bei Einzelnukleotidvarianten um über 90 % und bei Indels um 87 % reduziert. Es unterstützt den Billion Cell Atlas sowie neue TruPath Genome- und 5-Basen-Epigenomik-Assays.


Umfang des globalen KI im Omics-Marktberichts
Gem?? dem Umfang des Berichts bezieht sich KI im Omics auf die Anwendung von Techniken der künstlichen Intelligenz zur Analyse und Interpretation gro?skaliger biologischer Daten, die aus Omics-Technologien generiert werden. Omics umfasst Bereiche wie Genomik, Proteomik, Transkriptomik, Metabolomik und weitere, die eine umfassende Profilierung von Molekülen innerhalb biologischer Systeme beinhalten.
Die Segmentierung für den KI im Omics-Markt ist nach Komponente, Omics-Typ, KI-Technologie, Anwendung, Endnutzer und Geografie kategorisiert. Nach Komponente ist der Markt in Software, Hardware und Dienstleistungen unterteilt. Nach Omics-Typ umfasst er Genomik, Transkriptomik, Proteomik, Metabolomik und Epigenomik. Nach KI-Technologie deckt die Segmentierung maschinelles Lernen, Deep Learning, natürliche Sprachverarbeitung, Computer Vision und Data Mining ab. Nach Anwendung umfasst er Wirkstoffforschung und -entwicklung, klinische Diagnostik, Pr?zisionsmedizin, Biomarker-Entdeckung sowie Zielidentifikation und -validierung. Nach Endnutzer ist der Markt in Pharma- und Biotechnologieunternehmen, akademische und Forschungseinrichtungen, Krankenh?user und klinische Labore sowie Auftragsforschungsorganisationen segmentiert. Nach Geografie wird der Markt in Nordamerika, Europa, Asien-Pazifik, dem Nahen Osten und Afrika sowie 厂ü诲补尘别谤颈办补 analysiert. Der Marktbericht deckt auch die gesch?tzten Marktgr??en und Trends für 17 L?nder in den wichtigsten Regionen weltweit ab. Für jedes Segment werden Marktgr??e und Prognose in Wertangaben (USD) bereitgestellt.
| Software |
| Hardware |
| Dienstleistungen |
| Genomik |
| Transkriptomik |
| Proteomik |
| Metabolomik |
| Epigenomik |
| Maschinelles Lernen |
| Deep Learning |
| Natürliche Sprachverarbeitung |
| Computer Vision |
| Data Mining |
| Wirkstoffforschung und -entwicklung |
| Klinische Diagnostik |
| Pr?zisionsmedizin |
| Biomarker-Entdeckung |
| Zielidentifikation und -validierung |
| Pharma- und Biotechnologieunternehmen |
| Akademische und Forschungseinrichtungen |
| Krankenh?user und klinische Labore |
| Auftragsforschungsorganisationen |
| Nordamerika | Vereinigte Staaten |
| Kanada | |
| Mexiko | |
| Europa | Deutschland |
| Vereinigtes K?nigreich | |
| Frankreich | |
| Italien | |
| Spanien | |
| ?briges Europa | |
| Asien-Pazifik | China |
| Indien | |
| Japan | |
| 厂ü诲办辞谤别补 | |
| Australien | |
| ?briger Asien-Pazifik-Raum | |
| Naher Osten und Afrika | GCC |
| 厂ü诲补蹿谤颈办补 | |
| ?briger Naher Osten und Afrika | |
| 厂ü诲补尘别谤颈办补 | Brasilien |
| Argentinien | |
| ?briges 厂ü诲补尘别谤颈办补 |
| Nach Komponente | Software | |
| Hardware | ||
| Dienstleistungen | ||
| Nach Omics-Typ | Genomik | |
| Transkriptomik | ||
| Proteomik | ||
| Metabolomik | ||
| Epigenomik | ||
| Nach KI-Technologie | Maschinelles Lernen | |
| Deep Learning | ||
| Natürliche Sprachverarbeitung | ||
| Computer Vision | ||
| Data Mining | ||
| Nach Anwendung | Wirkstoffforschung und -entwicklung | |
| Klinische Diagnostik | ||
| Pr?zisionsmedizin | ||
| Biomarker-Entdeckung | ||
| Zielidentifikation und -validierung | ||
| Nach Endnutzer | Pharma- und Biotechnologieunternehmen | |
| Akademische und Forschungseinrichtungen | ||
| Krankenh?user und klinische Labore | ||
| Auftragsforschungsorganisationen | ||
| Nach Geografie | Nordamerika | Vereinigte Staaten |
| Kanada | ||
| Mexiko | ||
| Europa | Deutschland | |
| Vereinigtes K?nigreich | ||
| Frankreich | ||
| Italien | ||
| Spanien | ||
| ?briges Europa | ||
| Asien-Pazifik | China | |
| Indien | ||
| Japan | ||
| 厂ü诲办辞谤别补 | ||
| Australien | ||
| ?briger Asien-Pazifik-Raum | ||
| Naher Osten und Afrika | GCC | |
| 厂ü诲补蹿谤颈办补 | ||
| ?briger Naher Osten und Afrika | ||
| 厂ü诲补尘别谤颈办补 | Brasilien | |
| Argentinien | ||
| ?briges 厂ü诲补尘别谤颈办补 | ||


Im Bericht beantwortete Schlüsselfragen
Wie hoch ist der Wert des KI im Omics-Marktes im Jahr 2026?
Der KI im Omics-Markt hat im Jahr 2026 einen Wert von 1,61 Milliarden USD und soll bis 2031 bei einer CAGR von 26,09 % einen Wert von 5,14 Milliarden USD erreichen.
Welche Komponente w?chst im KI im Omics-Bereich am schnellsten?
Dienstleistungen sind die am schnellsten wachsende Komponente mit einer prognostizierten CAGR von 34,9 % bis 2031, angetrieben durch die Nachfrage nach kundenspezifischen Modellen, Bioinformatik-Unterstützung und Validierungsarbeit.
Warum führt die Genomik in diesem Bereich?
Die Genomik führte im Jahr 2025 mit einem Anteil von 35,2 % und ist mit einer CAGR von 40,1 % bis 2031 auch der am schnellsten wachsende Omics-Typ, da sie als Basisschicht für die meisten Multi-Omics-Workflows dient.
Welcher Anwendungsbereich erzielt den h?chsten Umsatz?
Wirkstoffforschung und -entwicklung war im Jahr 2025 mit einem Anteil von 35,4 % die gr??te Anwendung, da Pharmaunternehmen die frühesten und gr??ten K?ufer von KI-gestützten Omics-Tools bleiben.
Welche Region expandiert am schnellsten?
Asien-Pazifik soll bis 2031 mit einer CAGR von 37,4 % wachsen, unterstützt durch Investitionen in die Sequenzierung, digitale Gesundheitsprogramme und wachsendes Interesse an lokal relevanten Trainingsdatens?tzen.
Was ist die gr??te Herausforderung bei der Einführung?
Datenschutz, Einwilligung, Cybersicherheit und schwache Multi-Omics-Standardisierung bleiben die gr??ten Einschr?nkungen, da sie den Datensatzzugang begrenzen, die standortübergreifende Zusammenarbeit verlangsamen und die Validierungskosten erh?hen.
Seite zuletzt aktualisiert am:



